Capítulo 13: Problema de gestión de sangre
Descripción general del capítulo
El problema de gestión de sangre es un problema de asignación de recursos multidimensional, ya que tenemos que gestionar ocho tipos de sangre diferentes, además de llevar un registro de cuánto tiempo lleva almacenada la sangre (a menos que esté congelada). Esta es la primera vez que debemos recurrir a herramientas como la programación lineal para tomar decisiones en cada punto en el tiempo.
Comenzamos ilustrando una política miope que implica resolver un programa lineal simple que ignora tomar decisiones que no comprenden el impacto de las decisiones actuales sobre el futuro. Para la gestión de sangre, eso puede surgir en la gestión de sangre tipo $O-$, que se conoce como el donante universal —puede usarse para cualquier paciente. Ayuda mantener reservas de sangre tipo $O-$ en caso de que haya escasez de otros tipos.
Luego demostramos el uso de la programación dinámica aproximada para equilibrar las recompensas actuales con las recompensas futuras. Para usar ADP en un problema multidimensional, aprovechamos la estructura del problema en el diseño de una aproximación para el valor de un conjunto de inventarios de sangre en el futuro. Esta idea funciona cuando podemos explotar la estructura del problema.
Narrativa
El problema de gestionar inventarios de sangre sirve como una ilustración particularmente elegante de un problema de asignación de recursos. Vamos a comenzar suponiendo que estamos gestionando inventarios en un solo hospital, donde cada semana debemos decidir cuál de nuestros inventarios de sangre debe usarse para las demandas que deben atenderse en la semana entrante.
Tenemos que comenzar con algo de contexto sobre la sangre. Para efectos de gestionar inventarios de sangre, nos preocupamos principalmente por el tipo de sangre y su antigüedad. Aunque existe una amplia gama de diferencias en la sangre de dos individuos, para la mayoría de los propósitos los médicos se centran en los ocho tipos de sangre principales: $A+$ (“A positivo”), $A-$ (“A negativo”), $B+$, $B-$, $AB+$, $AB-$, $O+$, y $O-$. Si bien la capacidad de sustituir diferentes tipos de sangre puede depender de la naturaleza de la operación, para la mayoría de los propósitos la sangre puede sustituirse de acuerdo con la Tabla 13.1.
| Donante \ Receptor | $AB+$ | $AB-$ | $A+$ | $A-$ | $B+$ | $B-$ | $O+$ | $O-$ |
|---|---|---|---|---|---|---|---|---|
| $AB+$ | X | |||||||
| $AB-$ | X | X | ||||||
| $A+$ | X | X | ||||||
| $A-$ | X | X | X | X | ||||
| $B+$ | X | X | ||||||
| $B-$ | X | X | X | X | ||||
| $O+$ | X | X | X | X | ||||
| $O-$ | X | X | X | X | X | X | X | X |
Tabla 13.1. Sustituciones de sangre permitidas para la mayoría de las operaciones, "X" significa que se permite una sustitución.
Una segunda característica importante de la sangre es su antigüedad. El almacenamiento de sangre está limitado a seis semanas, después de las cuales debe desecharse. Los hospitales necesitan anticipar si creen que podrán usar la sangre antes de que alcance este límite, ya que puede transferirse a centros de sangre que monitorean los inventarios de diferentes hospitales dentro de una región. Ayuda que un hospital pueda identificar la sangre que no necesitará lo antes posible, de modo que la sangre pueda transferirse a ubicaciones que están escaseando.
Enmarcando el problema
Las respuestas a nuestras tres preguntas de enmarcado son:
- Métricas: Maximizar la suma esperada de bonificaciones menos penalizaciones por asignar sangre de un tipo para satisfacer la demanda de otro tipo.
- Decisiones: Cuánta sangre de un tipo asignar a las demandas de sangre de otro tipo, junto con cuánta sangre mantener en inventario para cada tipo de sangre.
- Incertidumbres: Las demandas futuras de sangre de cada tipo, junto con las donaciones de cada tipo de sangre.
Modelo básico
Variables de estado
Podemos modelar el problema de la sangre como un problema de asignación de recursos heterogéneo. Vamos a comenzar con un modelo bastante básico que puede extenderse fácilmente sin casi ningún cambio en la notación. Comenzamos describiendo los atributos de una unidad de sangre almacenada usando
\[b = \begin{pmatrix} b_1 \\ b_2 \end{pmatrix} = \begin{pmatrix} \text{blood type } (A+, A-, \ldots) \\ \text{age (in weeks)} \end{pmatrix},\]y dejamos que $\Bcal$ sea el conjunto de todos los tipos de atributos de sangre. Limitaremos la antigüedad al rango $0 \leq b_2 \leq 6$. La sangre con $b_2 = 6$ (lo que significa sangre que ya tiene seis semanas) ya no es utilizable. Suponemos que las épocas de decisión se realizan en incrementos de una semana. Los inventarios de sangre se representan usando $R_{tb}$, las unidades de sangre de tipo $b$ disponibles para ser asignadas o retenidas en el tiempo $t$, con $R_t = (R_{tb})_{b\in\Bcal}$.
Los atributos de la demanda de sangre están dados por
\[a = \begin{pmatrix} a_1 \\ a_2 \\ a_3 \end{pmatrix} = \begin{pmatrix} \text{blood type of patient} \\ \text{surgery type: urgent or elective} \\ \text{is substitution allowed?} \end{pmatrix},\]y dejamos que $\Acal$ sea el conjunto de todos los tipos de atributos para las demandas de sangre. El atributo $a_3$ captura el hecho de que hay algunas operaciones donde un médico no permitirá ninguna sustitución. Un ejemplo es el parto, ya que los recién nacidos pueden no ser capaces de tolerar un tipo de sangre diferente, incluso si es un sustituto permitido. Para nuestro modelo básico, no permitimos que la demanda no atendida en una semana se mantenga para una semana posterior.
Luego definimos la demanda de sangre usando $D_{ta}$, el número de unidades de sangre requeridas para pacientes con atributo $a$ en el tiempo $t$, con $D_t = (D_{ta})_{a\in\Acal}$.
Las variables de estado están dadas por
\[S_t = (R_t,D_t).\]Variables de decisión
Actuamos sobre los recursos de sangre con decisiones dadas por $d$, un tipo de decisión, que incluye decisiones de dar sangre a un paciente con atributo $a\in\Acal$, o de no hacer nada y retener la sangre, lo cual representamos mediante $d^\phi$; y $\Dcal$, el conjunto de todas las decisiones posibles, $\Dcal = \Acal \cup d^\phi$.
Luego dejamos que $x_{tbd}$ sea el número de unidades de sangre con atributo $b$ sobre las cuales actuamos con una decisión de tipo $d$ en el tiempo $t$, con $x_t = (x_{tbd})_{b\in\Bcal,d\in\Dcal}$.
La región factible $\Xcal_t$ está definida por las siguientes restricciones:
\[\begin{align} \sum_{d\in\Dcal} x_{tbd} &= R_{tb}, \quad b\in\Bcal, \label{eq:blood1}\\ \sum_{b\in\Bcal} x_{tbd} &\leq \Dhat_{td}, \quad d\in\Dcal,\label{eq:blood2}\\ x_{tbd} &\geq 0. \label{eq:blood3} \end{align}\]Información exógena
La información que llega después de que hemos tomado una decisión está dada por las donaciones de sangre, que representamos usando $\Rhat_{t+1,b}$, el número de nuevas unidades de sangre de tipo $b$ donadas entre $t$ y $t+1$, con $\Rhat_{t+1} = (\Rhat_{t+1,b})_{b\in\Bcal}$.
Las nuevas demandas de sangre se modelan usando $\Dhat_{t+1,a}$, las unidades de demanda con atributo $a$ que surgieron entre $t$ y $t+1$, con $\Dhat_{t+1} = (\Dhat_{t+1,a})_{a\in\Acal}$.
Nuestra variable de información exógena sería
\[W_{t+1} = (\Rhat_{t+1}, \Dhat_{t+1}).\]Función de transición
La sangre que se retiene simplemente envejece una semana, pero limitamos la antigüedad a seis semanas. La sangre que se asigna para satisfacer una demanda puede modelarse como si se moviera a un sumidero de tipo de sangre, denotado, quizás, usando $b_{t,1} = \phi$ (el tipo de sangre nulo). La función de transición de atributos de sangre $b^M(b_t,d_t)$ está dada por
\[b_{t+1} = \begin{pmatrix} b_{t+1,1} \\ b_{t+1,2} \end{pmatrix} = \begin{cases} \begin{pmatrix} b_{t,1} \\ \min\{6,b_{t,2}+1\} \end{pmatrix}, & d_t = d^\phi, \\[8pt] \begin{pmatrix} \phi \\ - \end{pmatrix}, & d_t \in\Dcal. \end{cases}\]Para representar la función de transición, es útil definir
\[\delta_{b'}(b,d) = \begin{cases} 1 & b^x_t = b' = b^M(b_t,d_t),\\ 0 & \text{otherwise,} \end{cases}\]y dejar que $\Delta$ sea la matriz con $\delta_{b’}(b,d)$ en la fila $b’$ y la columna $(b,d)$.
Observamos que la función de transición de atributos es determinista. Un elemento aleatorio surgiría, por ejemplo, si las inspecciones de la sangre resultaran en que sangre de menos de seis semanas fuera juzgada como caducada. La función de transición de recursos ahora se puede escribir como
\[R^x_{tb'} = \sum_{b\in\Bcal}\sum_{d\in\Dcal} \delta_{b'}(b,d) x_{tbd}, \qquad R_{t+1,b'} = R^x_{tb'} + \Rhat_{t+1,b'}.\]En forma matricial, estas se escribirían como
\[\begin{align} R^x_t &= \Delta x_t, \label{eq:bloodresourcetransition1}\\ R_{t+1} &= R^x_t + \Rhat_{t+1}. \label{eq:bloodresourcetransition2} \end{align}\]Las demandas $D_{t+1}$ simplemente se observan a partir de las nuevas demandas $\Dhat_{t+1}$, por lo que escribimos esto como
\[D_{t+1} = \Dhat_{t+1}.\]La Figura 13.1 ilustra las transiciones que ocurren en la semana $t$. Debemos decidir qué tipo de sangre usar para satisfacer una demanda (Figura 13.1a), o retener la sangre hasta la semana siguiente. Si usamos sangre para satisfacer una demanda, se supone que se pierde del sistema. Si retenemos la sangre hasta la semana siguiente, se transforma en sangre que tiene una semana más de antigüedad. La sangre que tiene seis semanas de antigüedad no puede usarse para satisfacer ninguna demanda, por lo que podemos ver el grupo de sangre de seis semanas de antigüedad como un sumidero para sangre no utilizable (el valor de esta sangre sería cero). Nótese que se supone que las donaciones de sangre llegan con una antigüedad de 0.
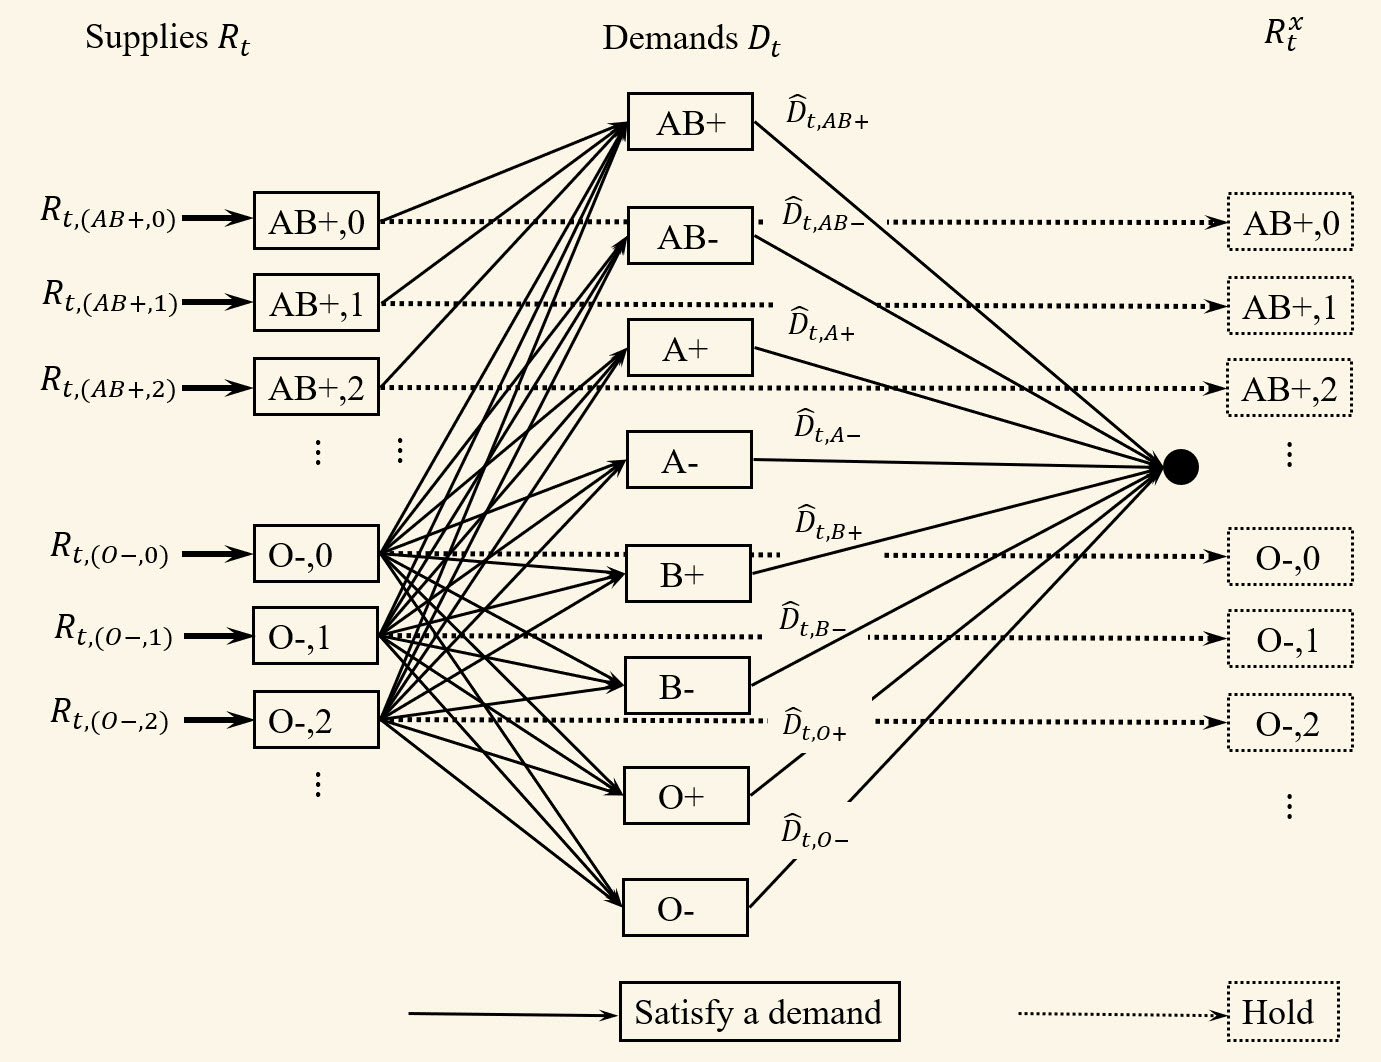
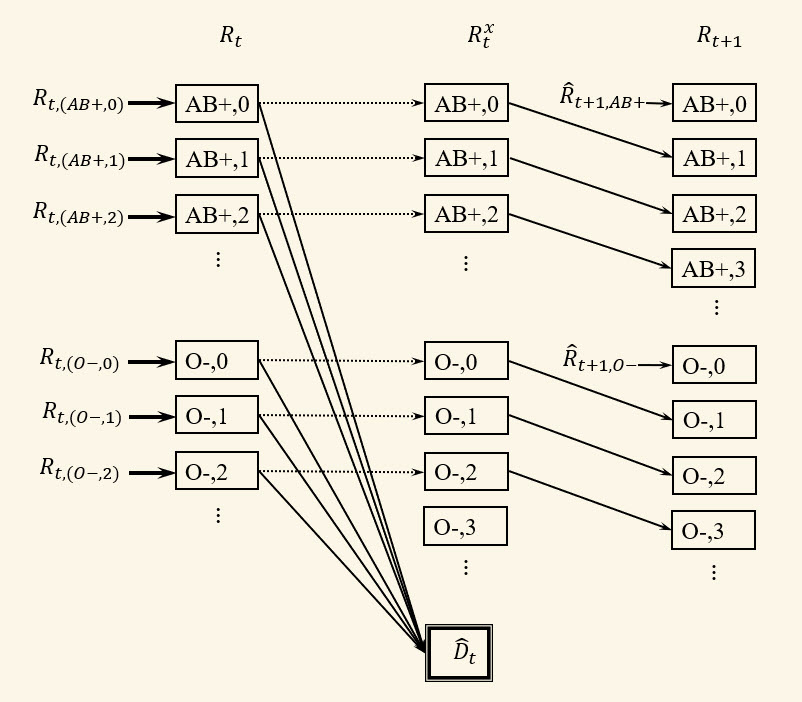
Los modelos representados por la Figura 13.1 son bastante útiles para los problemas de asignación de recursos. Hemos usado este modelo con bastante éxito para optimizar la asignación de productos manufacturados entre centros de distribución, y para optimizar la asignación de camiones, vagones de carga y locomotoras en el transporte de carga. Hay que tener cuidado al estimar las aproximaciones de la función de valor, pero una vez que se estiman, su uso produce secuencias de problemas de red muy pequeños que se muestran en la figura.
Función objetivo
No hay un “costo” real por asignar sangre de un tipo a la demanda de otro tipo (no estamos considerando pasos como gastar dinero para fomentar donaciones adicionales, o transportar inventarios de un hospital a otro). En cambio, usamos la función de contribución para capturar las preferencias del médico. Nos gustaría capturar la preferencia natural de que generalmente es mejor no sustituir, y que satisfacer una demanda urgente es más importante que una demanda electiva.
Por ejemplo, podríamos usar las contribuciones descritas en la Tabla 13.2. Así, si usamos sangre $O-$ para satisfacer las necesidades de un paciente electivo con sangre $A+$, obtendríamos una contribución de -$10 (penalización, ya que es negativa) por sustituir sangre, un +$5 por usar sangre $O-$ (algo que a los hospitales les gusta fomentar), y una contribución de +$20 por atender una demanda electiva, para una contribución total de +$15.
| Condición | Descripción | Valor |
|---|---|---|
| si $d = d^\phi$ | Retención | 0 |
| si $b_1 = b_1$ cuando $d\in\Dcal$ | Sin sustitución | 0 |
| si $b_1 \neq b_1$ cuando $d\in\Dcal$ | Sustitución | -10 |
| si $b_1 = O-$ cuando $d\in\Dcal$ | Sustitución $O-$ | 5 |
| si $d_2 = $ Urgente | Atendiendo demanda urgente | 40 |
| si $d_2 = $ Electiva | Atendiendo demanda electiva | 20 |
Tabla 13.2. Contribuciones para diferentes tipos de sangre y decisiones.
La contribución total (en el tiempo $t$) finalmente está dada por
\[C_t(S_t,x_t) = \sum_{b\in\Bcal}\sum_{d\in\Dcal} c_{tbd} x_{tbd}.\]Como antes, sea $X^\pi_t(S_t)$ una política (algún tipo de regla de decisión) que determina $x_t\in\Xcal_t$ dado $S_t$. Deseamos encontrar la mejor política resolviendo
\[\begin{align} \max_{\pi\in\Pi} \E \sum_{t=0}^T C_t(S_t,X^\pi(S_t)), \label{eq:bloodobjective} \end{align}\]donde $S_{t+1} = S^M(S_t,X^\pi(S_t),W_{t+1})$.
Modelando la incertidumbre
Las fuentes de incertidumbre en este problema son las donaciones de sangre y la llegada de nuevas cirugías que requieren donaciones de sangre. Algunas cuestiones que debemos considerar al modelar esta incertidumbre incluyen:
- No solo hay aleatoriedad en el número de unidades de sangre donadas, sino también en el tipo de sangre.
- Existen patrones tanto por día de la semana como estacionales en las donaciones de sangre, así como respuestas a llamamientos que, por supuesto, representan una decisión.
- La llegada de nuevas cirugías puede producirse en oleadas debido al clima o a la violencia.
- Existe una discordancia consistente entre los tipos de personas que donan sangre y los tipos de personas que necesitan cirugías, lo cual se manifiesta en diferencias en la distribución de los tipos de sangre.
- Un tema importante es gestionar la sustitución de tipos de sangre. Se presta mucha atención a la capacidad de usar sangre $O-$ para cualquiera, pero existen diferentes tipos de sustitución para todos los tipos de sangre.
Diseñando políticas
Vamos a comenzar con una política miope básica, y luego pasaremos a una que depende de aproximar el valor de los inventarios de sangre en el futuro.
Una política miope
La forma más obvia de resolver este problema es una simple política miope, en la que maximizamos la contribución en cada punto en el tiempo sin considerar el efecto de nuestras decisiones sobre el futuro. Podemos obtener una familia de políticas miopes ajustando las contribuciones de un período.
Por ejemplo, nuestra bonificación de $5 por usar sangre $O-$ (en la Tabla 13.2), es de hecho un tipo de política miope. Fomentamos el uso de sangre $O-$ ya que en general está más disponible que otros tipos de sangre. Al cambiar esta bonificación, obtenemos diferentes tipos de políticas miopes que podemos representar mediante el conjunto $\Pi^M$, donde para $\pi\in\Pi^M$ nuestra función de decisión estaría dada por
\[\begin{align} X^\pi_t(S_t) = \argmax_{x_t\in\Xcal_t} \sum_{b\in\Bcal} \sum_{d\in\Dcal} c_{tbd}x_{tbd}. \label{eq:bloodmyopic} \end{align}\]El problema de optimización en $\eqref{eq:bloodmyopic}$ es un simple programa lineal. Buscar entre políticas en el problema de optimización dado por la ecuación $\eqref{eq:bloodobjective}$ significa buscar entre diferentes valores de la bonificación por usar sangre $O-$.
Una política VFA
Como programa dinámico tradicional, el problema de optimización planteado en la ecuación $\eqref{eq:bloodobjective}$ es bastante desafiante. La variable de estado $S_t$ tiene $\vert \Acal\vert + \vert \Bcal\vert = 8 \times 6 + 8 \times 2 \times 2 = 80$ dimensiones. Las variables aleatorias $\Rhat$ y $\Dhat$ también tienen una combinación de 80 dimensiones. El vector de decisión $x_t$ tiene $27 + 8 = 35$ dimensiones.
Es natural usar aproximaciones de la función de valor para determinar el vector de asignación $x_t$ usando
\[\begin{align} x^n_t = \argmax_{x_t\in\Xcal^n_t} \big(C_t(S^n_t,x_t) + \Vbar^{x,n-1}_t(R^x_t) \big), \label{eq:adpblood} \end{align}\]donde $R^x_t = R^M(R_t,x_t)$ está dado por la ecuación $\eqref{eq:bloodresourcetransition1}$ y donde $\Xcal^n_t$ está definido por las restricciones $\eqref{eq:blood1}$–$\eqref{eq:blood3}$. La restricción clave es $\eqref{eq:blood1}$ que limita la disponibilidad de suministros de sangre de cada tipo.
El primer (y más importante) desafío que enfrentamos es identificar una estrategia de aproximación adecuada para $\Vbar^{x,n-1}_t(R^x_t)$. Una aproximación simple y efectiva es usar aproximaciones separables, lineales por tramos, es decir
\[\Vbar^x_t(R^x_t) = \sum_{b\in\Bcal} \Vbar^x_{tb}(R^x_{tb}),\]donde $\Vbar^x_{tb}(R^x_{tb})$ es una función escalar, lineal por tramos, en el inventario post-decisión $R^x_{tb}$ para cada tipo de sangre $b$.
Es fácil demostrar que la función de valor es cóncava (además de lineal por tramos), por lo que cada $\Vbar^x_{tb}(R^x_{tb})$ también debería ser cóncava. Sin pérdida de generalidad, podemos suponer que $\Vbar^x_{tb}(R^x_{tb}) = 0$ para $R^x_{tb} = 0$, lo que significa que la función está completamente caracterizada por su conjunto de pendientes. Podemos escribir la función usando
\[\begin{align} \Vbar^{n-1}_{tb}(R^x_{tb}) = \left(\sum_{r=1}^{\lfloor R^x_{tb}\rfloor} \vbar^{n-1}_{tb}(r-1) + (R^x_{tb} - \lfloor R^x_{tb}\rfloor) \vbar^{n-1}_{tb}(\lfloor R^x_{tb}\rfloor)\right), \label{eq:pwl} \end{align}\]donde $\lfloor R \rfloor$ es el mayor entero menor o igual que $R$. Como podemos ver, esta función está determinada por el conjunto de pendientes $(\vbar^{n-1}_{tb}(r))$ para $r = 0, 1, \ldots, R^{max}$, donde $R^{max}$ es una cota superior en el número de recursos de un tipo particular.
La forma en que estimamos las pendientes en $\Vbar_t(R_t)$ es crear la función objetivo para el problema en el tiempo $t$
\[\begin{align} \Vtilde_{t}(S_t) = \max_{x_t\in\Xcal^n_t} \big(C_t(S^{n}_t,x_t) + \Vbar^{x,n-1}_t(R^x_t) \big). \label{eq:bloodvtile} \end{align}\]Cuando resolvemos este programa lineal, obtenemos estimaciones del valor marginal de una unidad adicional de sangre de tipo $a$ dada por $R^n_{ta}$. Llamemos a este valor $\vhat^n_{ta}$, que está disponible de inmediato a partir de cualquier paquete de programación lineal (y obtenemos esto para todos los tipos de sangre $a$ al mismo tiempo).
Alternativamente, podríamos calcular el valor marginal con mayor precisión creando un vector de recursos perturbado $R^{n+}_{ta} = R^n_{ta} +1$. Sea $\Xcal^{n+}_t(a)$ la región factible (compuesta por las ecuaciones $\eqref{eq:blood1}$–$\eqref{eq:blood3}$) donde usamos $R^{n+}_{ta}$ en lugar de $R^n_{ta}$ para un único atributo $a$, y sea $\Vtilde^+_{ta}(S_t)$ igual a $\Vtilde_t(S_t)$ excepto con la región factible $\Xcal^{n+}_{ta}$ con el recurso perturbado $R^{n+}_{ta}$ en lugar de $R^n_{ta}$. Podemos entonces encontrar los valores marginales $\vhat^n_{ta}$ usando
\[\vhat^n_{ta} = \Vtilde^+_{ta}(S_t) - \Vtilde_t(S_t).\]Observe que tenemos que calcular $\Vtilde^+_{ta}(S_t)$ para cada $a$ (mientras que con las variables duales, obtenemos todo el conjunto de valores marginales de una sola vez).
Luego usamos $\vhat^n_{ta}$ para actualizar la aproximación de la función de valor post-decisión anterior $\vbar^{x,n}_{t-1,a}$, lo cual se hace con
\[\vbar^{x,n}_{t-1,a}(R^{x,n}_{t-1,a}) = (1-\alpha) \vbar^{x,n-1}_{t-1,a}(R^{x,n}_{ta}) + \alpha \vhat^n_{ta}.\]Podemos demostrar que las pendientes $\vbar^{x,n}_{ta}(R^{x,n}_{ta})$ disminuyen a medida que $R^{x,n}_{ta}$ aumenta, por lo que ayuda mantener esta propiedad. Podemos lograr esto con métodos como los algoritmos CAVE o Leveling (véase Reinforcement Learning and Stochastic Optimization, Sección 18.3).
Suponiendo que podemos estimar esta función, el problema de optimización que tenemos que resolver (ecuación $\eqref{eq:adpblood}$) es el programa lineal bastante modesto que se muestra en la Figura 13.2. Como en la Figura 13.1, tenemos que considerar tanto la asignación de diferentes tipos de sangre a diferentes tipos de demanda, como la decisión de retener sangre.
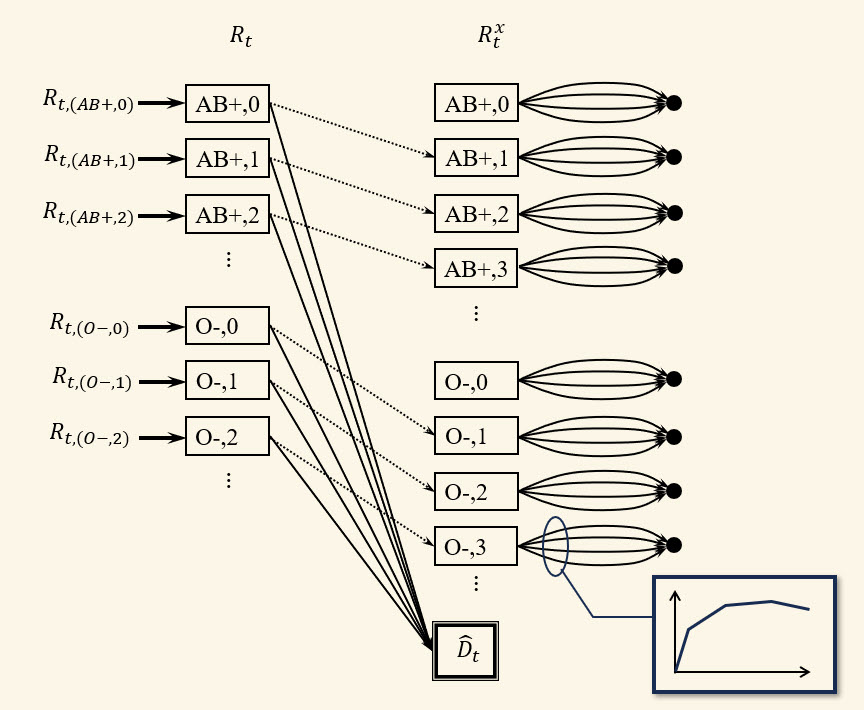
Para simplificar la figura, hemos colapsado la red de diferentes tipos de demanda en un único recuadro agregado con demanda $\Dhat_t$. Esta red, en realidad, se vería igual que la red de la Figura 13.1a. La decisión de retener sangre tiene que considerar el valor de un tipo de sangre (incluida su antigüedad) en el futuro, lo cual estamos aproximando usando funciones de valor separables, lineales por tramos.
Aquí, usamos un truco de modelado estándar que convierte las aproximaciones de la función de valor separables, lineales por tramos, en una serie de enlaces paralelos desde cada nodo que representa un elemento de $R^x_t$ hacia un supersumidero. Las funciones lineales por tramos no solo son fáciles de resolver (solo necesitamos acceso a un solucionador de programación lineal), sino que también son fáciles de estimar. Además, para muchas clases de problemas (aunque no todas), se ha demostrado que producen una convergencia muy rápida con soluciones de alta calidad.
Con esta función de decisión, vamos a usar un método llamado iteración de valor aproximada en el que simulamos hacia adelante iterativamente a través de los períodos de tiempo $t=0, \ldots, T$. Sea $n = 1, \ldots, N$ el contador de iteraciones, donde seguimos una trayectoria muestral de la información exógena $W^n_t,~t=0, \ldots, T$ (estas podrían extraerse del histórico, o muestrearse a partir de una distribución). En el tiempo $t$, iteración $n$, usamos la ecuación $\eqref{eq:adpblood}$ para tomar una decisión $x^n_t$ cuando estamos en el estado $S^n_t$. Luego observamos $W^n_{t+1}$ y usamos nuestra función de transición (ecuaciones $\eqref{eq:bloodresourcetransition1}$–$\eqref{eq:bloodresourcetransition2}$) para la transición de $R^n_t$ a $R^n_{t+1}$. Cuando estamos en el estado $S^n_t = (R^n_t, \Dhat^n_t)$, usamos nuestra política VFA en la ecuación $\eqref{eq:adpblood}$ para calcular $x^n_t$, y luego calculamos $\vhat^n_t$ para actualizar las pendientes $\vbar^{x,n}_{t-1}$. Luego observamos $W^n_{t+1}$ (que contiene $\Dhat^n_{t+1}$) para transicionar al estado $S^n_{t+1}$.
Para la mayoría de las aplicaciones operativas, este problema se resolvería sobre un horizonte finito (digamos, 10 semanas), lo que nos daría una recomendación de qué hacer en este momento. Podemos usar las aproximaciones de la función de valor $\Vbar^x_t(R^x_t)$ para simular la política un número de veces, lo cual puede usarse para producir una forma de pronóstico probabilístico de los inventarios futuros.
Extensiones
Este es un problema de asignación de recursos rico y complejo que puede extenderse de varias maneras. A continuación, se presentan algunos ejemplos.
1) Suponemos que cualquier demanda que no se satisfaga en el tiempo $t$ se pierde. Imagine que tenemos cirugías de emergencia que deben satisfacerse, y cirugías electivas que pueden retrasarse a un período de tiempo posterior. Escriba la variable de estado para el nuevo problema.
2) Suponga que las cirugías electivas pueden retrasarse. Considere usar una aproximación de la función de valor que sea lineal por tramos y separable en los inventarios de sangre (esta es la VFA sugerida anteriormente), junto con VFA lineales por tramos y separables para la cantidad de demanda retenida (por tipo de sangre). Usamos las variables duales para el inventario de sangre para actualizar la VFA para los suministros de sangre. ¿Cómo podríamos actualizar la VFA para la demanda retenida?
3) Incluya la presencia de sangre que ha sido congelada, y la decisión de congelar sangre, donde la sangre congelada que no se usa debe desecharse. Esto significa que tenemos que reconocer que la cantidad de sangre necesaria para una cirugía es desconocida antes de la cirugía, momento en el cual debe tomarse la decisión de descongelar la sangre.
4) Un hospital podría requerir entregas semanales de sangre de un banco de sangre comunitario para compensar escasez sistemática. Imagine que llega una cantidad fija (por ejemplo, 100 unidades) de sangre cada semana, pero la cantidad de sangre de cada tipo y antigüedad (la sangre puede haber estado ya en inventario durante varias semanas) podría ser aleatoria.
5) Presentamos un modelo que se centraba únicamente en los inventarios de sangre en un solo hospital. Podemos manejar múltiples hospitales y centros de distribución simplemente agregando un atributo de ubicación, y previendo una decisión de mover sangre (con un costo) de una ubicación a otra.
Este modelo también puede aplicarse a cualquier problema de inventario multiproducto donde existan diferentes tipos de producto y diferentes tipos de demandas, siempre que tengamos la capacidad de elegir qué tipo de producto se asigna a cada tipo de demanda. También suponemos que los productos no son reutilizables; una vez que el producto se asigna a una demanda, se pierde del sistema.
¿Qué aprendimos?
- Presentamos un problema de asignación de recursos multidimensional que tiene un espacio de estados extremadamente grande, pero que ofrece la estructura de concavidad que podemos explotar en la aproximación de funciones de valor.
- Mostramos cómo modelar un problema de asignación de recursos multiatributo, lo cual facilita bastante la introducción de atributos adicionales.
- Ilustramos una política miope básica en la que se ignora el impacto posterior de las decisiones tomadas ahora.
- Luego describimos una política VFA en la que explotamos la concavidad natural del problema para sugerir una aproximación basada en aproximaciones de la función de valor separables, lineales por tramos.
- Nuestra política VFA tendría que implementarse de forma continua, por lo que nuestra política es en realidad un DLA estocástico, usando una política VFA como política de anticipación. Esto es paralelo a nuestro uso de la programación dinámica para resolver el problema del camino más corto determinista, que representaba una aproximación de nuestro problema del camino más corto estocástico y dinámico en el Capítulo 6.
Ejercicios
Preguntas de repaso
- ¿Cuál es la dimensionalidad de la variable de estado $S_t$?
- ¿Cuál es la dimensionalidad del vector de decisión $x_t$?
- ¿Cuáles son las fuentes de incertidumbre?
- Describa la naturaleza de los costos en la función objetivo. ¿De dónde provienen estos?
- ¿Cuál es la limitación de una política puramente miope? ¿Qué comportamiento estaría buscando en una mejor política?
- ¿Cómo mejora la solución el uso de funciones de valor?
Preguntas de resolución de problemas
Gestión de sangre - Parte I: Modelado - Vamos a considerar el problema de gestión de sangre, pero vamos a suponer que hay solo un tipo de sangre, aunque todavía vamos a modelar el proceso de envejecimiento, donde la sangre puede tener de 0 a 5 semanas de antigüedad. Cualquier sangre de 5 semanas que se retenga debe desecharse. Como en el libro, hay dos tipos de pacientes: urgentes y electivos. Sea:
$R_{t\tau}$ Número de unidades de sangre disponibles en el tiempo $t$ que se han retenido durante $\tau$ períodos de tiempo, $\tau = 0, \ldots, 5$. $\Rhat_t$ Nuevas donaciones de sangre que llegan entre $t-1$ y $t$, donde $\Rhat_t$ es un escalar. $\Dhat^{urgent}_t$ Nuevas demandas urgentes que llegan en el tiempo $t$. $\Dhat^{elective}_t$ Nuevas demandas electivas que llegan en el tiempo $t$. En el tiempo $t$, tenemos que decidir:
$x^{urgent}_t$ Cantidad de sangre a asignar a pacientes urgentes. $x^{elective}_t$ Cantidad de sangre a asignar a pacientes electivos. $x^{hold}_t$ Cantidad de sangre a retener. $x_t$ $(x^{urgent}_t,x^{elective}_t,x^{hold}_t)$. Las demandas no tienen que cubrirse, aunque la cuestión real es si cubrir una demanda electiva ahora (suponiendo que hay suficiente sangre para cubrir todas las demandas urgentes) o retener la sangre para una posible demanda urgente en el futuro. Como antes, suponga que cualquier demanda que no se atienda sale del sistema.
Su objetivo es maximizar una función de utilidad que otorga un crédito de 10 por cada paciente urgente cubierto y 5 por cada paciente electivo cubierto.
- ¿Cuál es la variable de estado para este problema?
- ¿Cuáles son las variables de decisión y la información exógena?
- ¿Cuál es la función de transición?
- ¿Cuál es la función objetivo? Suponga que podemos simular la política en un simulador.
- Cree una función de costo con aproximación parametrizada que asigne los siguientes costos a cada decisión: $c^{urgent}$, penalización por no cubrir a un paciente urgente; $c^{elective}$, penalización por no cubrir a un paciente electivo; y $c^{discard}$, penalización por descartar sangre que exceda las 5 semanas de antigüedad. Como su política, suponga que va a minimizar estos costos en cada periodo de tiempo. Trate el vector $c=(c^{urgent},c^{elective},c^{discard})$ como un conjunto de parámetros ajustables. Describa cómo optimizar el vector $c$ utilizando un algoritmo de gradiente estocástico. Asegúrese de dar la ecuación para calcular el gradiente estocástico.
- Gestión de sangre - Parte II: Programación dinámica aproximada hacia atrás - Ahora vamos a diseñar una política basada en la idea de aproximar la función de valor mediante programación dinámica aproximada hacia atrás. Esto significa que usted tiene que especificar un modelo lineal para aproximar $V^x_t(S^x_t)$. Los detalles de este modelo no son tan importantes, pero podría usar algo como
$$
\Vbar^x_t(S^x_t) = \thetabar_{t0} + \sum_{age=0}^5 \theta_{t1,age} R^{urgent,x}_{t,age} + \sum_{age=0}^5 \theta_{t2,age} R^{elective,x}_{t,age}.
$$
Para los propósitos de este ejercicio, puede simplemente escribir $\Vbar^x_t(S^x_t) = (\theta_t)^T \phi(S^x_t)$ donde $\theta_t$ es un vector columna de coeficientes y $\phi(S^x_t)$ es un vector columna de características.
- Defina el estado post-decisión, y use esto para escribir la ecuación de Bellman que caracterice una política óptima. Necesitará escribir una expresión para el valor $V_t(S_t)$ de estar en el estado pre-decisión $S_t$ en el tiempo $t$ en términos del valor $V^x_t(S^x_t)$ de estar en el estado post-decisión $S^x_t$. Luego necesitará escribir una expresión para $V^x_t(S^x_t)$ en términos de $V_{t+1}(S_{t+1})$. Suponga que las unidades de sangre son siempre enteras.
- ¿Cuál es la dimensionalidad de las variables de estado pre- y post-decisión? ¿Nos importa qué tan grande sea el espacio de estados?
- Escriba pseudocódigo detallado que describa cómo estimar las aproximaciones de la función de valor para este problema a lo largo de un horizonte finito $0, \ldots, T$. Piense en esto como un ejercicio de programación sin la programación real. Debe ser lo suficientemente detallado como para que pudiera entregárselo a un compañero de clase (familiarizado con el material) que luego pudiera escribir el código.
- Escriba la política utilizando su expresión para la función de valor aproximada.
- Gestión de sangre - Parte III: Política de anticipación - Esta vez, vamos a suponer que tenemos pronósticos móviles de suministros y demandas. Sea $f^R_{tt'}$ el pronóstico de donaciones de sangre en el tiempo $t'$ realizado usando lo que sabemos en el tiempo $t$. Sean $f^{D,urgent}_{tt'}$ y $f^{D,elective}_{tt'}$ los pronósticos de nuevas demandas urgentes y electivas que llegan en el tiempo $t'$ dado lo que sabemos en el tiempo $t$. Suponga que los pronósticos se proporcionan de manera exógena (es decir, no tenemos que modelar cómo evolucionan los pronósticos de $t$ a $t+1$). Puede usar
$$
\begin{align*}
f^R_t &= (f^R_{tt'})_{t'=t+1}^T, \\
f^{D,urgent}_t &= (f^{D,urgent}_{tt'})_{t'=t+1}^T, \\
f^{D,elective}_t &= (f^{D,elective}_{tt'})_{t'=t+1}^T, \\
f_t &= (f^R_t,f^{D,urgent}_t,f^{D,elective}_t).
\end{align*}
$$
Sea $\sigma^R_{t'-t}$ la desviación estándar del error entre las donaciones reales $\Rhat_{tt'}$, la cual suponemos que se conoce con base en el desempeño pasado. Suponemos que esto es puramente una función de qué tan lejos en el futuro estamos planificando, dada por $t'-t$. De manera similar, sean $\sigma^{D,urgent}_{t'-t}$ y $\sigma^{D,elective}_{t'-t}$ las desviaciones estándar de los errores en los pronósticos de nuevas demandas urgentes y electivas.
- Modele los cinco elementos de un problema de decisión secuencial para este entorno. Debería poder copiar elementos de una de las partes anteriores a este problema. Siéntase libre de referenciar cualquier ecuación por su número si lo desea reutilizar. El cambio principal es la inclusión de los pronósticos.
- Escriba una política DLA usando una anticipación determinista con pronósticos como estimaciones puntuales de cualquier donación y demanda futuras.
- Ahora diseñe una política parametrizada donde reemplace cada pronóstico por uno que esté un cierto número de desviaciones estándar por encima (o por debajo) del pronóstico puntual. Use tres parámetros, que podría designar $\theta = (\theta^R, \theta^{urgent}, \theta^{elective})$. Escriba el problema de encontrar el mejor valor para $\theta$ como un problema de optimización. Explique cualquier suposición que tenga que hacer en su formulación.
- Su función objetivo en la parte (c) implica aproximar una esperanza. Puede hacer esto mediante simulación, donde simularía una trayectoria muestral $\omega$ a lo largo de un horizonte de $T$ periodos de tiempo. ¿Qué significa $\omega$?
- Dé las fórmulas para calcular la media y la varianza muestral del desempeño de una política a partir de $L$ simulaciones usando trayectorias muestrales $\omega^1, \ldots, \omega^L$.
- Suponga que representa el conjunto de posibles valores del vector $\theta$ mediante la muestra $\theta^1, \ldots, \theta^K$. Describa un método de búsqueda usando estimación de intervalos parametrizado por $\lambda^{IE}$ (en el libro usamos $\theta^{IE}$, pero esto crea demasiadas $\theta$). Necesitará describir su modelo de creencia y cómo se actualiza cada vez que ejecuta una simulación usando $\theta = \theta^k$. Suponga que tiene un presupuesto de $N$ simulaciones, y que $\lambda^{IE}$ es conocido.
Preguntas de programación
Estos ejercicios usan el módulo de Python BloodManagement en tinyurl.com/sdagithub.
Nuestro objetivo es gestionar la asignación de diferentes tipos de sangre a diferentes pacientes, quienes se caracterizan primero por su propio tipo de sangre, y segundo por si la cirugía es urgente o electiva.
Este ejercicio le hará trabajar con dos clases de políticas: una función de costo con aproximación paramétrica miope, y una política basada en aproximaciones de la función de valor.
Vamos a comenzar suponiendo que usted simplemente va a emparejar diferentes tipos de sangre con diferentes demandas. La sangre se describe por tipo de sangre (de los cuales hay ocho) y edad, que variará de 0 a 2 semanas (la sangre de 3 semanas de antigüedad se descarta). Los pacientes se describen por tipo de sangre y si la cirugía es urgente o electiva. Hay varias bonificaciones y penalizaciones que guían las asignaciones. Por ejemplo, hay bonificaciones positivas por cubrir a pacientes urgentes (esta es la más alta). También hay una bonificación por emparejar exactamente los tipos de sangre (por ejemplo, sangre A-positivo con un paciente A-positivo), y una penalización por descartar sangre después de que se vuelve demasiado vieja.
Si ignoramos el impacto de las decisiones actuales sobre el futuro, tenemos un programa lineal simple que empareja suministros y demandas, con costos dados por este conjunto de bonificaciones. El problema es que al ignorar el impacto de las decisiones actuales sobre el futuro, podemos encontrar que no estamos haciendo lo mejor que podemos. Un problema que surge es que cuando usamos sangre ahora para cirugía electiva, estamos ignorando que esto podría ser útil de conservar en caso de que nos quedemos sin sangre para cirugía urgente más adelante. Alternativamente, podemos usar sangre O- ahora en lugar de conservarla para el futuro cuando podríamos quedarnos sin otros tipos de sangre.
Sea $R_{ta}$ el suministro de sangre con atributo $a$ para la semana $t$, y sea $R_t = (R_{ta})_{a\in\Acal}$ donde $\Acal$ es el conjunto de todos los diferentes atributos de sangre (tipo de sangre y edad). De manera similar, sea $D_{tb}$ los atributos de un paciente donde $b$ captura el tipo de sangre y si la cirugía es urgente o electiva, y sea $D_t = (D_{tb})_{b\in\Bcal}$. El estado de nuestro sistema es $S_t = (R_t,D_t)$.
Ahora sea $\Rhat_{t+1,a}$ el número de unidades de sangre con atributo $a$ que fueron donadas entre las semanas $t$ y $t+1$. De manera similar, sea $\Dhat_{t+1,b}$ el número de nuevas llegadas de pacientes con atributo $b$. Escribiríamos
$$ W_{t+1} = (\Rhat_{t+1,a},\Dhat_{t+1,b}). $$Finalmente, sea $\omega$ representando una trayectoria muestral $W_1(\omega), \ldots, W_T(\omega)$ de donaciones y nuevos pacientes a lo largo de nuestro horizonte de $T$ semanas. Suponga que hemos creado un conjunto de simulaciones de $W_t$, y sea $\Omega=(\omega_1, \ldots, \omega_N)$ este conjunto de realizaciones muestrales.
- ¿Cuántas dimensiones tiene la variable de estado $S_t$?
- Sea $X^\pi(S_t\vert \theta)$ el resultado de resolver el programa lineal dado el estado $S_t$, donde $\theta$ es el vector de todas las bonificaciones y penalizaciones para las diferentes asignaciones. Sea $D^{urgent}_t(x_t)$ el número de pacientes urgentes que fueron cubiertos dado el vector de decisión $x_t$, y sea $D^{elective}_t(x_t)$ el número de pacientes electivos que fueron cubiertos. Escriba el problema de encontrar el mejor valor de $\theta$ como un problema de optimización, donde en lugar de nuestra esperanza usual lo va a escribir como un promedio sobre las trayectorias muestrales en $\Omega$.
- Vamos a considerar un conjunto de datos donde hay una probabilidad de que la demanda ocasionalmente tenga un aumento súbito. Puede establecer esta probabilidad en la hoja de cálculo. Establezca esta probabilidad de aumento súbito en 50 por ciento. Hay una penalización especial por usar sangre para cubrir cirugía electiva para incentivar al modelo miope a ahorrar sangre para cirugía urgente que podría tener un aumento en la demanda más adelante. Encuentre el mejor valor de esta penalización en el conjunto $\lbrace -4,-9,-14,-19,-24\rbrace $ después de ejecutar 20 iteraciones de prueba.
- Sin realizar ningún trabajo numérico adicional, imagine ahora que la penalización sobre la sangre O-negativo necesita depender de la semana para manejar variaciones estacionales. Dado que está simulando 15 semanas, describa un método para optimizar sobre un vector de 15 dimensiones (hemos descrito dos estrategias principales en tareas anteriores; puede elegir una, o inventar una nueva).
Ahora vamos a cambiar a una política basada en VFA, donde usamos el valor marginal de cada tipo de sangre (y edad) que se mantiene para el futuro. Esto se hará con un algoritmo de aprendizaje adaptativo que fue descrito en la sección de política VFA anterior (y es muy similar a nuestra estrategia de PDA para el problema del camino más corto, excepto que ahora lo hacemos para un problema donde la decisión es un vector).
Establezca la penalización por usar sangre en electivas en 0. Al usar una política basada en VFA, el VFA debería aprender que la sangre urgente en exceso del suministro podría necesitarse en el futuro. Cuando esté usando la política VFA, necesitará ejecutar 20 iteraciones de entrenamiento para estimar las funciones de valor. Después de que estas se estimen, ejecutará entonces 20 iteraciones de prueba para evaluar la calidad de la política.
Vamos a probar nuestras políticas para un conjunto de datos donde hay una probabilidad de que la demanda ocasionalmente tenga un aumento súbito. Puede establecer esta probabilidad en la hoja de cálculo. Comience estableciendo esta probabilidad de aumento súbito en 0.7.
- El algoritmo de aprendizaje adaptativo requiere estimar el valor marginal de cada tipo de sangre. Sea $\vhat^n_{ta}$ nuestra estimación del valor marginal del tipo de sangre $a$ para la semana $t$ mientras simulamos la trayectoria muestral $\omega^n$. Sea $\Vbar^{n-1}_t(R_{ta})$ nuestra estimación, después de $n-1$ iteraciones, del valor marginal de la $r$-ésima unidad de sangre donde $r = R^x_{ta}$ al final de la semana $t$ (esta es nuestra variable de estado "post-decisión"). Recuerde que usamos $\vhat^n_{ta}$ para actualizar la aproximación de la función de valor alrededor de la variable de estado post-decisión anterior. Escribimos este proceso de actualización como $$ \Vbar^n_{t-1,a}(R^{x,n}_{t-1,a}) = (1-\alpha) \Vbar^{n-1}_{t-1,a}(R^{x,n}_{t-1,a}) + \alpha \vhat^n_{ta}. $$ Nuestra primera tarea es que tenemos que ajustar $\alpha$. Ejecute el algoritmo de programación dinámica aproximada durante 20 iteraciones (así está configurada la hoja de cálculo) para $\alpha \in \lbrace 0, 0.05, 0.1, 0.2, 0.3\rbrace $ y reporte los resultados. Note que un tamaño de paso $\alpha = 0$ es lo mismo que mantener la aproximación de la función de valor igual a cero (en otras palabras, la política miope). Si $\alpha = 0$, no tiene que entrenar los VFA, así que solo tiene que ejecutar las 20 iteraciones de prueba para evaluar la política. ¿Qué tan bien se desempeña la política VFA en relación con la política miope (correspondiente a $\alpha = 0$)?
- Ahora cambie la probabilidad de aumento súbito a cero, y compare la política miope con la política VFA usando un tamaño de paso de $\alpha = 0.2$. ¿Cómo se comparan estos? ¿Puede explicar el comportamiento para este conjunto de datos en comparación con cuando había aumentos súbitos?