Capítulo 12: Optimización de clics en anuncios
Descripción general del capítulo
Este capítulo aborda el problema de optimizar la política para colocar ofertas y maximizar los retornos en plataformas de comercio electrónico como Google y Facebook. Estas plataformas ejecutan subastas sofisticadas para asegurarse de que se les pague el valor de mercado completo por los anuncios que muestran. El modelo del problema, y el diseño de las políticas, se complica por la necesidad de representar tres formas de incertidumbre: la probabilidad de que ganemos la oferta que hacemos por un anuncio, el resultado de si ganamos o no la oferta, y el ingreso obtenido por ganar la oferta.
Exploramos tres políticas. Las dos primeras son relativamente simples: una política voraz que elige la mejor oferta dadas nuestras estimaciones actuales de todas las cantidades inciertas, y una versión aleatorizada de la política voraz que fomenta la exploración. La tercera es más sofisticada: conocida como el “gradiente de conocimiento,” maximiza el valor de la información al colocar una oferta particular. Esto requiere encontrar una esperanza de la mejora a partir de lo que aprendemos de una oferta determinada. El gradiente de conocimiento implica cálculos de probabilidad relativamente sofisticados.
Narrativa
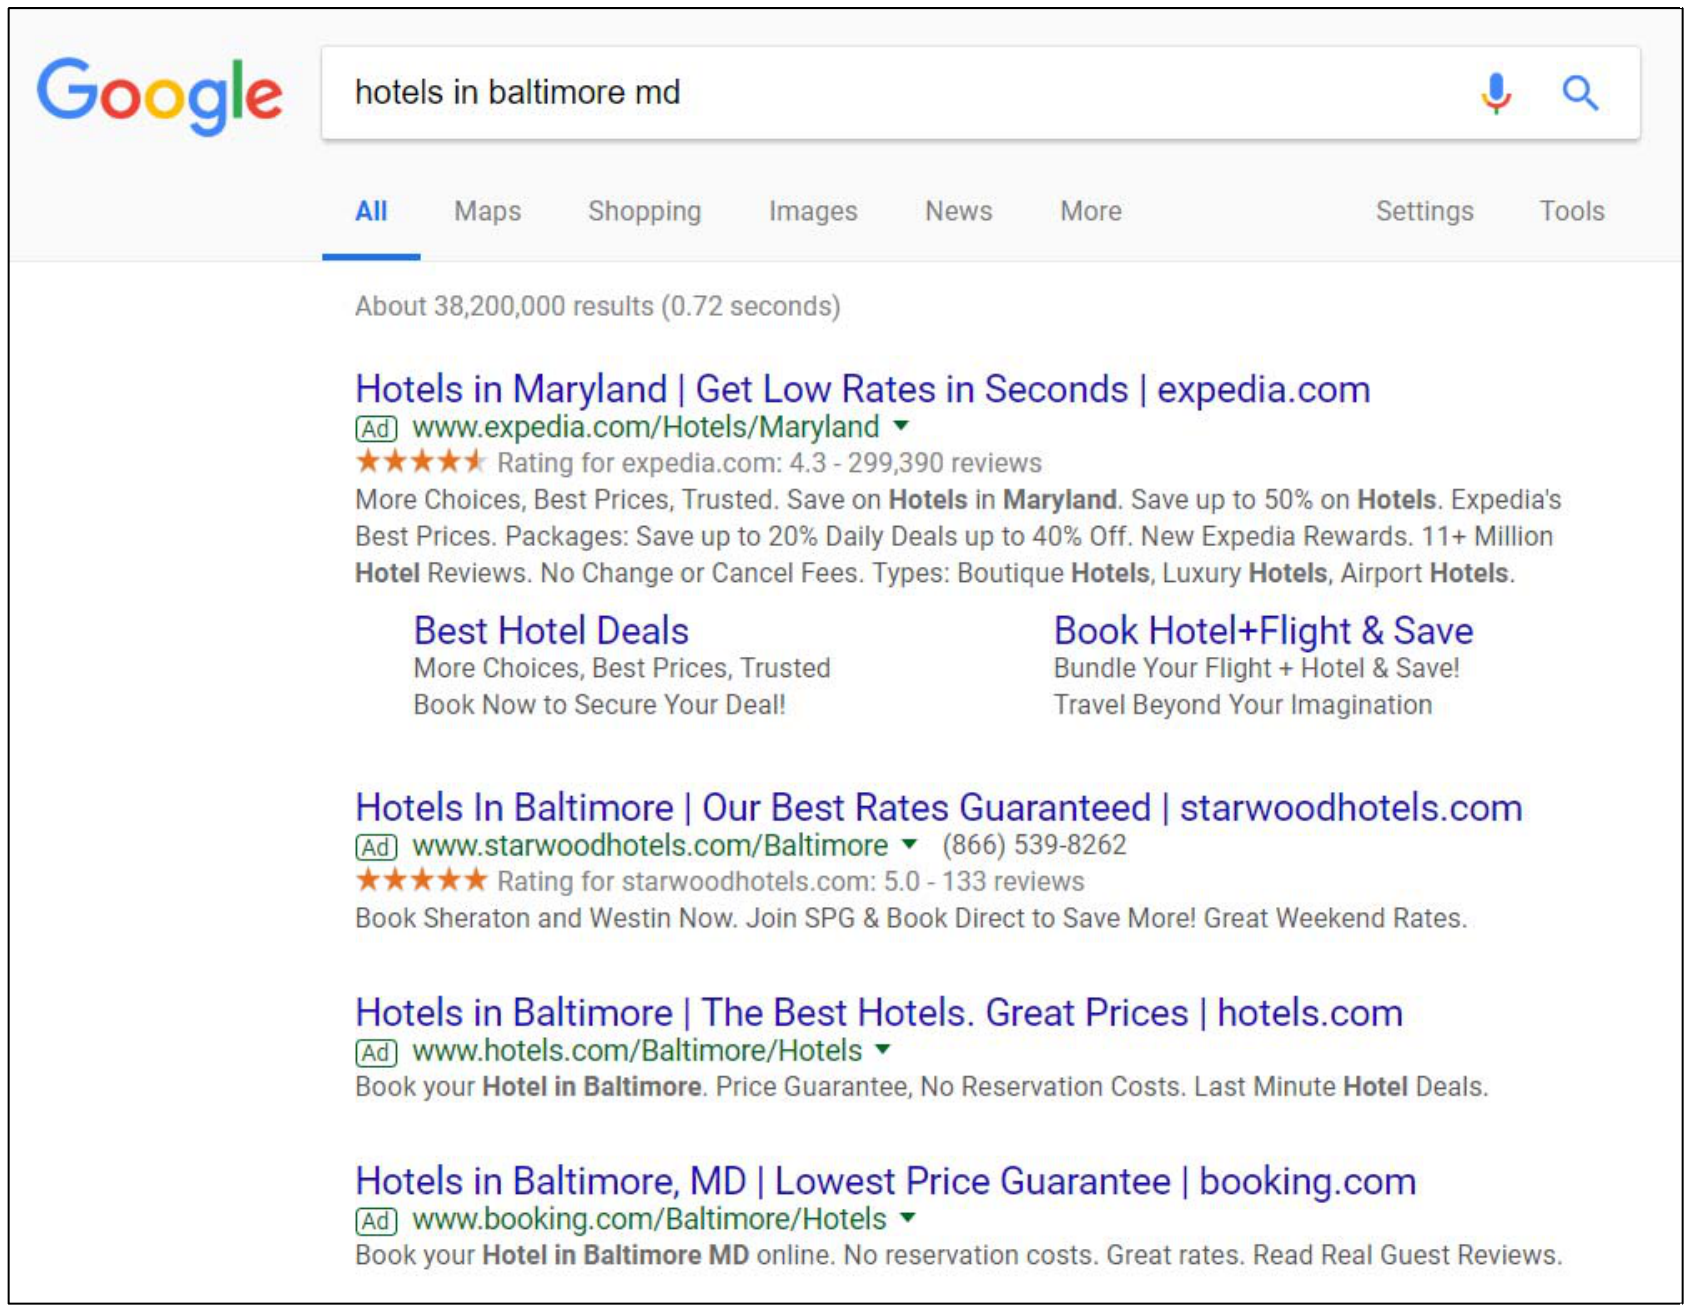
Las empresas que se anuncian en sitios de internet como Google tienen que ofertar para conseguir que sus anuncios aparezcan en una posición visible (es decir, en la parte superior de la lista de anuncios patrocinados). Cuando un cliente ingresa un término de búsqueda, Google identifica a todos los ofertantes que han incluido el mismo término de búsqueda (o similar) en su lista de palabras clave publicitarias. Google entonces toma todas las coincidencias, las ordena en función de cuánto ha ofertado cada participante, y ejecuta una subasta. Cuanto más alta sea la oferta, más probable es que el anuncio se coloque cerca de la parte superior de la lista de anuncios patrocinados, lo que aumenta la probabilidad de un clic. La Figura 12.1 es un ejemplo de lo que se produce al ingresar los términos de búsqueda “hotels in baltimore md.”
Si un cliente hace clic en el anuncio, hay un retorno esperado que refleja el monto promedio que un cliente gasta cuando visita el sitio web de la empresa. El problema es que no conocemos la curva de respuesta a la oferta. La Figura 12.2 refleja una familia de posibles curvas de respuesta. Nuestro desafío es probar diferentes ofertas para aprender cuál curva es la correcta.
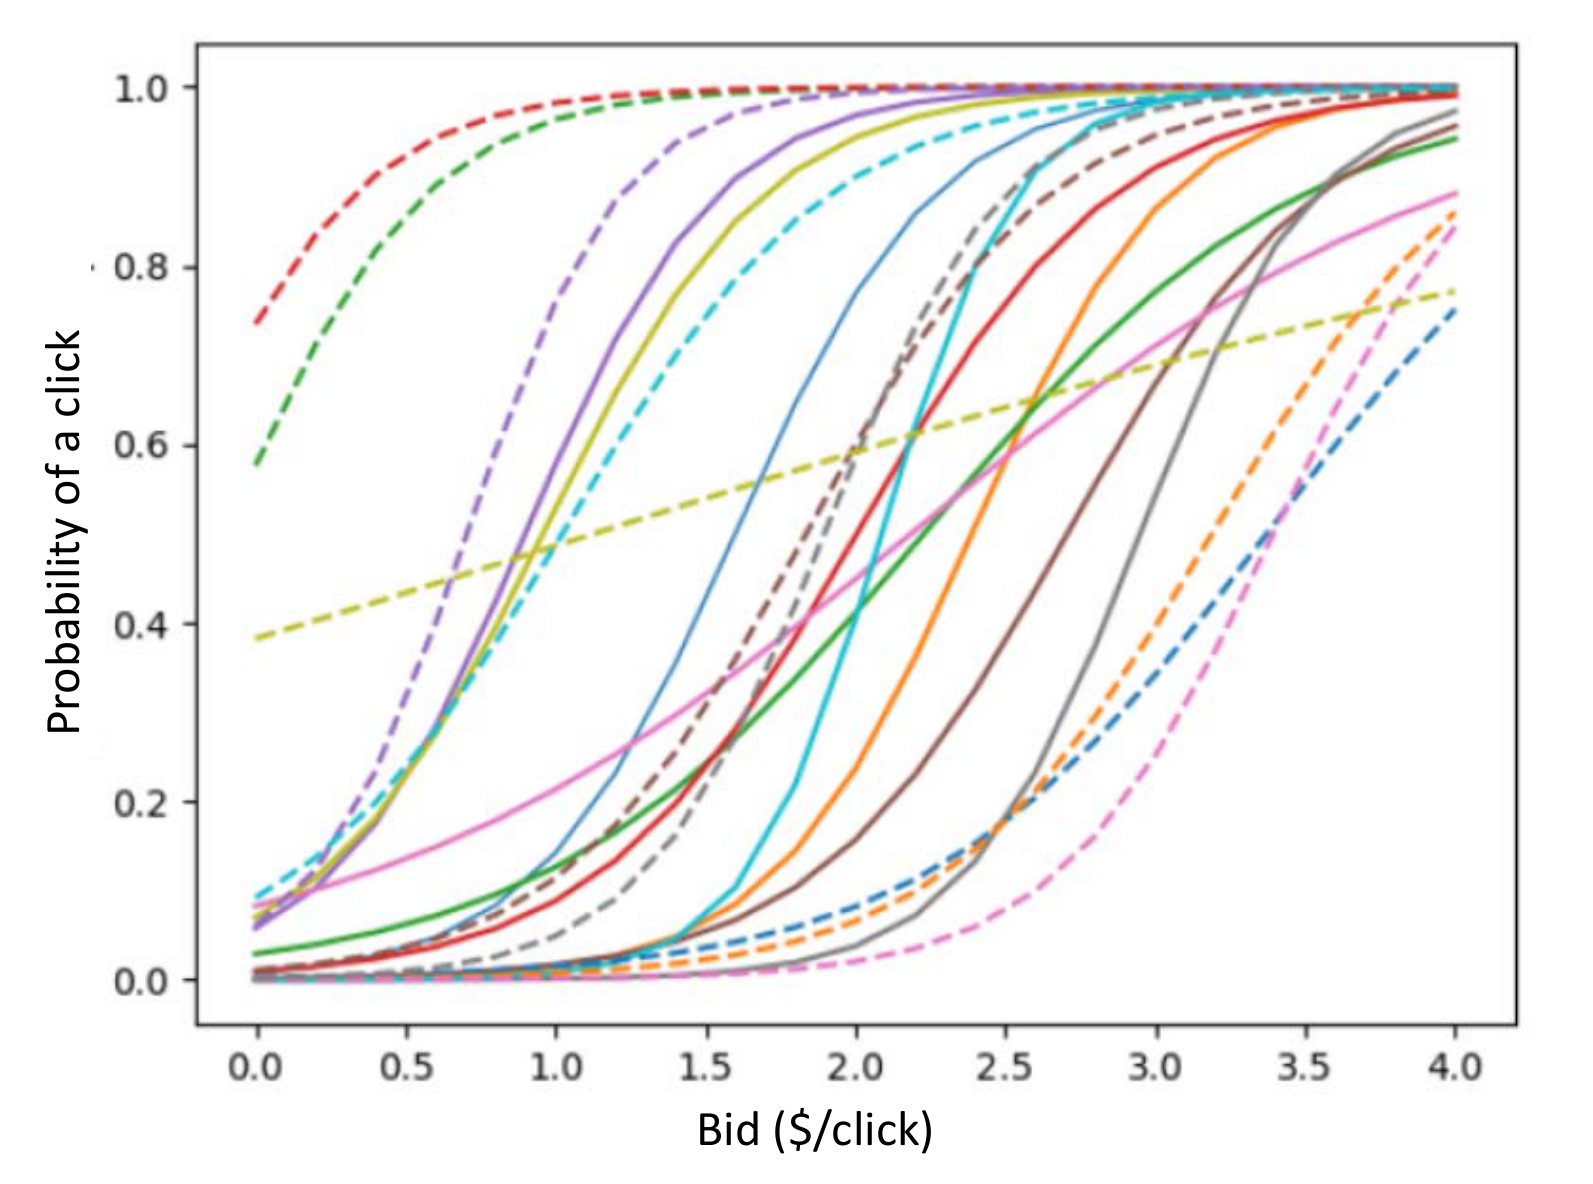
Comenzamos suponiendo que podemos ajustar la oferta después de cada subasta, lo que significa que solo aprendemos una única respuesta (el cliente hizo clic o no en el enlace). Es posible que el cliente haya visto un enlace mostrado y haya decidido no hacer clic en él, o que nuestra oferta haya sido tan baja que ni siquiera estuvimos en la lista de anuncios mostrados.
Nuestro desafío es diseñar una política para establecer las ofertas. El objetivo es maximizar el ingreso neto, incluyendo lo que ganamos por vender nuestros productos o servicios, menos lo que gastamos en clics publicitarios.
Enmarcando el problema
Las respuestas a nuestras tres preguntas de enmarcado son:
- Métricas: Maximizar el ingreso neto esperado por la venta de productos que se anuncian en la plataforma, menos el monto pagado por ejecutar el anuncio.
- Decisiones: Cuánto ofertar por el anuncio.
- Incertidumbres: Si una oferta tiene éxito, y el monto del ingreso recibido por una oferta exitosa.
Modelo básico
Vamos a suponer que usamos algún tipo de modelo parametrizado para capturar la probabilidad de que un cliente haga clic en un anuncio. Como mínimo, esta probabilidad dependerá de cuánto ofertemos por un anuncio: cuanto más ofertemos, más alto aparecerá el anuncio en la lista de anuncios patrocinados, lo que aumenta la probabilidad de que un cliente haga clic en él. Sea $K^n = 1$ si el $n$-ésimo cliente hace clic en el anuncio. Sea
\[P^{click}(\theta_k,x) = Prob[K^{n+1}=1\vert \theta=\theta_k,x]\]donde $Prob[K^{n+1}=1\vert \theta=\theta_k,x]$ se describirá mediante una función logística dada por
\[\begin{align} Prob[K^{n+1}=1\vert \theta=\theta_k,x^n, H^n] = \frac{e^{\theta^{const,n}_k + \theta^{bid,n}_k x^n}}{1+e^{\theta^{const,n}_k + \theta^{bid,n}_k x^n}}. \label{eq:adclicklogisticregression} \end{align}\]Esta función está parametrizada por $\theta = (\theta^{const}, \theta^{bid})$. No sabemos cuál es $\theta$, pero vamos a suponer que es uno de un conjunto muestreado $\Theta = \lbrace \theta_1, \ldots,\theta_K\rbrace $.
Variables de estado
El estado inicial $S^0$ incluye $\Theta = \lbrace \theta_1, \ldots, \theta_K\rbrace $, el conjunto de valores posibles que $\theta$ puede tomar; y $\Rbar^0$, la estimación inicial del ingreso obtenido cuando un cliente hace clic en un enlace.
Las variables de estado dinámicas $S^n$ incluyen $p^n_k$, la probabilidad de que el verdadero $\theta = \theta_k$, con $p^n = (p^n_k)_{k=1}^K$; y $\Rbar^n$, la estimación del ingreso obtenido por un clic publicitario después de $n$ subastas.
Nuestra variable de estado dinámica, entonces, es
\[S^n = (\Rbar^n, p^n).\]Nótese que podemos crear una estimación puntual de $\theta$ después de $n$ observaciones usando
\[\thetabar^n = \sum_{k=1}^K p^n_k \theta_k,\]pero esta es una estadística que podemos calcular a partir de la información en $S^n$, por lo que no incluimos $\thetabar^n$ en la variable de estado.
Variables de decisión
Nuestra única variable de decisión es la oferta que definimos como $x^n$, la oferta (en $ por clic) para la $(n+1)$-ésima subasta. Como antes, dejamos que $X^\pi(S^n)$ sea nuestra política genérica que nos da la oferta $x^n$ como función de la información disponible para nosotros, representada por $S^n$, lo que significa que escribiríamos
\[x^n = X^\pi(S^n).\]Suponemos que la política impone cualquier restricción, como asegurarse de que la oferta no sea negativa o algo demasiado grande.
Información exógena
En nuestro modelo inicial, solo observamos los resultados de una única subasta, que modelamos usando:
\[K^{n+1} = \begin{cases} 1 & \text{if the customer clicks on our ad,} \\ 0 & \text{otherwise.} \end{cases}\]y $\Rhat^{n+1}$, el ingreso obtenido de la $n+1$-ésima subasta. Esto significa que nuestra variable de información exógena completa es
\[W^{n+1} = (\Rhat^{n+1},K^{n+1}).\]Función de transición
La función de transición para este problema parecerá mucho más complicada que otras en este volumen, lo cual se debe a que estamos actualizando creencias sobre la incertidumbre en el vector de parámetros $\theta$. Necesitamos enfatizar que todas las ecuaciones de transición pueden codificarse con relativa facilidad.
Vamos a actualizar nuestro ingreso estimado cuando un cliente hace clic en el anuncio usando:
\[\begin{align} \Rbar^{n+1} = \begin{cases} (1-\alpha^{lrn}) \Rbar^n + \alpha^{lrn} \Rhat^{n+1} & \text{if } K^{n+1} = 1, \\ \Rbar^n & \text{otherwise.} \end{cases} \label{eq:adclicktransition1} \end{align}\]Por lo tanto, solo actualizamos nuestro ingreso estimado cuando obtenemos un clic. El parámetro $\alpha^{lrn}$ es un parámetro de suavizado (a veces llamado “tasa de aprendizaje”) entre 0 y 1 que fijamos de antemano.
A continuación abordamos la actualización de las probabilidades $p^n_k$. Dejamos que $H^n$ sea la historia de estados, decisiones e información exógena
\[H^n = (S^0,x^0,W^1, S^1, x^1, \ldots, W^n, S^n, x^n).\]Usamos esto para escribir
\[p^n_k = Prob[\theta=\theta_k\vert H^n].\]La forma de leer el condicionamiento sobre la historia $H^n$ es “$p^n_k$ es la probabilidad $\theta = \theta_k$ dado lo que sabemos después de $n$ observaciones.” Luego usamos el teorema de Bayes para escribir
\[\begin{align} p^{n+1}_k &= Prob[\theta=\theta_k\vert W^{n+1}, H^n] \nonumber\\ &= \frac{Prob[K^{n+1}\vert \theta=\theta_k,H^n]Prob[\theta=\theta_k\vert H^n]}{Prob[K^{n+1}\vert H^n]}. \label{eq:adclicktransition2} \end{align}\]Recuerde que la historia $H^n$ incluye la decisión $x^n$ que, dada una política para tomar estas decisiones, es directamente una función del estado $S^n$ (que a su vez es una función de la historia $H^n$). Ahora usamos nuestra curva logística en la ecuación $\eqref{eq:adclicklogisticregression}$ para escribir
\[\begin{align} Prob[K^{n+1}=1\vert \theta=\theta_k,H^n] &= Prob[K^{n+1}=1\vert \theta=\theta_k, x^n]\nonumber\\ &= \frac{e^{\theta^{const}_k + \theta^{bid}_k x^n}}{1+e^{\theta^{const}_k + \theta^{bid}_k x^n}}. \label{eq:adclicktransition2a} \end{align}\]Luego notamos que
\[\begin{align} Prob[\theta=\theta_k\vert H^n] = p^n_k. \label{eq:adclicktransition2b} \end{align}\]Finalmente, notamos que el denominador puede calcularse usando
\[\begin{align} Prob[K^{n+1}\vert H^n] = \sum_{k=1}^K Prob[K^{n+1}\vert \theta=\theta_k,H^n] p^n_k. \label{eq:adclicktransition2c} \end{align}\]Nuestro uso de una representación muestreada de los posibles resultados de $\theta$ nos está ayudando aquí. Incluso si $\theta$ tiene solo dos dimensiones (como es el caso aquí, pero solo por ahora), realizar una integral bidimensional sobre una distribución multivariante para $\theta$ sería problemático.
Las ecuaciones $\eqref{eq:adclicktransition2a}$–$\eqref{eq:adclicktransition2c}$ nos permiten calcular nuestra ecuación de actualización bayesiana para las probabilidades en $\eqref{eq:adclicktransition2}$. Las ecuaciones $\eqref{eq:adclicktransition1}$–$\eqref{eq:adclicktransition2}$ conforman nuestra función de transición
\[S^{n+1} = S^M(S^n,x^n,W^{n+1}).\]Función objetivo
Comenzamos escribiendo la función de ganancia de un solo período como
\[C(S^n,x^n,W^{n+1}) = (\Rhat^{n+1} - x^n) K^{n+1},\]lo que significa que no ganamos nada si el cliente no hace clic en el anuncio ($K^{n+1} = 0$). Si el cliente sí hace clic en el anuncio ($K^{n+1} = 1$), recibimos un ingreso dado por $\Rhat^{n+1}$, pero también tenemos que pagar lo que ofertamos por el clic publicitario, dado por nuestra oferta $x^n$.
Terminaremos tomando la contribución esperada, que escribimos como
\[\E \{C(S^n,x^n,W^{n+1})\vert S^n\} = \E \{(\Rhat^{n+1} - x^n) K^{n+1} \vert S^n\}.\]Hay tres variables aleatorias ocultas en la esperanza:
- $\theta$, con distribución $p^n = (p^n_1, \ldots, p^n_K)$ (contenida en $S^n$).
- $K^{n+1}$, donde $P^{click}(\theta,x) = Prob[K^{n+1}=1\vert \theta,x]$.
- $\Rhat^{n+1}$, que observamos a partir de alguna distribución desconocida si $K^{n+1}=1$, y donde $\Rhat^{n+1}=0$ si $K^{n+1}=0$ (no obtenemos ningún ingreso si el cliente no hace clic en el anuncio).
Podemos entonces descomponer la esperanza en tres esperanzas anidadas:
\[\E \{(\Rhat^{n+1} - x^n) K^{n+1} \vert S^n\} = \E_{\theta} \E_{K\vert \theta} \E_{\Rhat} \{(\Rhat^{n+1} - x^n) K^{n+1} \vert S^n\}.\]Comenzamos tomando la esperanza sobre $\Rhat$ donde simplemente usamos $\E \lbrace \Rhat^{n+1}\vert S^n\rbrace = \Rbar^n$ (recuerde que $\Rbar^n$ está en la variable de estado $S^n$), lo que nos permite escribir
\[\E \{(\Rhat^{n+1} - x^n) K^{n+1} \vert S^n\} = \E_{\theta} \E_{K\vert \theta} \{(\Rbar^n - x^n) K^{n+1} \vert S^n\}.\]A continuación vamos a tomar la esperanza sobre $K^{n+1}$ para un $\theta$ dado usando
\[\E_{K\vert \theta} \{(\Rbar^n - x^n) K^{n+1} \vert S^n\} = (\Rbar^n - x^n) P^{click}(\theta,x).\]donde hemos utilizado el hecho de que $(\Rbar^n - x^n) K^{n+1}=0$ si $K^{n+1}=0$.
Finalmente tomamos la esperanza sobre $\theta$ usando
\[\E_{\theta} \{(\Rbar^n - x^n) P^{click}(\theta,x^n) \vert S^n\} = \sum_{k=1}^K (\Rbar^n - x^n) P^{click}(\theta=\theta_k,x^n) p^n_k.\]Vamos a dejar que $\Cbar(S^n,x)$ sea la contribución esperada, es decir
\[\Cbar(S^n,x) = \E_{\theta} \E_{K\vert \theta} \{(\Rbar^n - x^n) K^{n+1} \vert S^n\}.\]Nuestra función objetivo ahora puede escribirse como
\[\max_\pi \E_{S^0} \E_{W^1, \ldots, W^n\vert S^0} \left\{\sum_{n=0}^N C(S^n,X^\pi(S^n),W^{n+1})\vert S_0\right\}.\]Nótese que el condicionamiento sobre $S_0$ es cómo comunicamos nuestra creencia previa $p^0_k = Prob[\theta=\theta_k]$ al modelo. Como antes, aproximaríamos la esperanza promediando sobre muestras simuladas del valor verdadero de $\theta$, y los clics observados $K^n$ y los ingresos $R^n$.
Modelado de la incertidumbre
Tenemos tres formas de incertidumbre: el clic publicitario $K^{n+1}$, el ingreso que recibimos $\Rhat^{n+1}$ si $K^{n+1}=1$, y luego el valor verdadero de $\theta$. Vamos a suponer que simplemente observamos $\Rhat^{n+1}$ a partir de un flujo de datos real, lo que significa que no necesitamos un modelo de probabilidad formal para estas variables aleatorias. Suponemos que $K^{n+1}$ se describe mediante nuestra función logística
\[\begin{align} P^{click}(\theta,x) &= P[K^{n+1} = 1\vert \theta,x=x^n] \nonumber \\ &= \frac{e^{\theta^{const} + \theta^{bid} x}}{1+e^{\theta^{const} + \theta^{bid} x}}, \label{eq:adclicklogistic} \end{align}\]pero es importante reconocer que esta es solo una curva ajustada. Los valores de $K^{n+1}$ se observan a partir de datos, lo que significa que no tenemos ninguna garantía de que la distribución coincida precisamente con nuestra regresión logística.
Finalmente, suponemos que $\theta \in \Theta = \lbrace \theta_1, \ldots, \theta_K\rbrace $ lo cual también es una aproximación. Hay formas de relajar el requisito de un conjunto muestreado, pero la lógica se vuelve algo más complicada sin agregar mucho valor educativo.
Diseño de políticas
Vamos a explorar tres políticas para el aprendizaje:
- Explotación pura – Aquí siempre colocamos la oferta que parece ser la mejor dadas nuestras estimaciones actuales.
- Una política de excitación – Introducimos exploración en nuestra política de explotación agregando un término de ruido aleatorio que fuerza al sistema a explorar en regiones cercanas a las áreas que consideramos mejores (esto es popular en ingeniería donde los estados y las decisiones son continuos).
- Una política de valor de información – Vamos a maximizar el valor de la información al colocar una oferta y aprender el resultado.
Explotación pura
El punto de partida de cualquier política en línea debería ser la explotación pura, lo que significa hacer lo mejor que podamos. Para calcular esto comenzamos usando
\[\E \{\Rhat^{n+1} K^{n+1}\} = \E \{\Rhat^{n+1}\vert K^{n+1} = 1\} Prob[K^{n+1}=1\vert \theta=\theta_k] = \Rbar^n P^{click}(\theta,x).\]Para encontrar la mejor oferta, encontramos (después de un poco de álgebra) la derivada con respecto a la oferta $x$
\[\frac{d \Cbar(x)}{d x} = (\Rbar^n - x)\frac{d P^{click}(\theta,x)}{d x} - P^{click}(\theta,x)\]donde
\[\frac{d P^{click}(\theta,x)}{d x} = \frac{\theta_1 e^{-\theta_0 - \theta_1 x}}{(1+e^{-\theta_0 - \theta_1 x})^2}.\]Ahora queremos encontrar la oferta $x^\ast $ donde
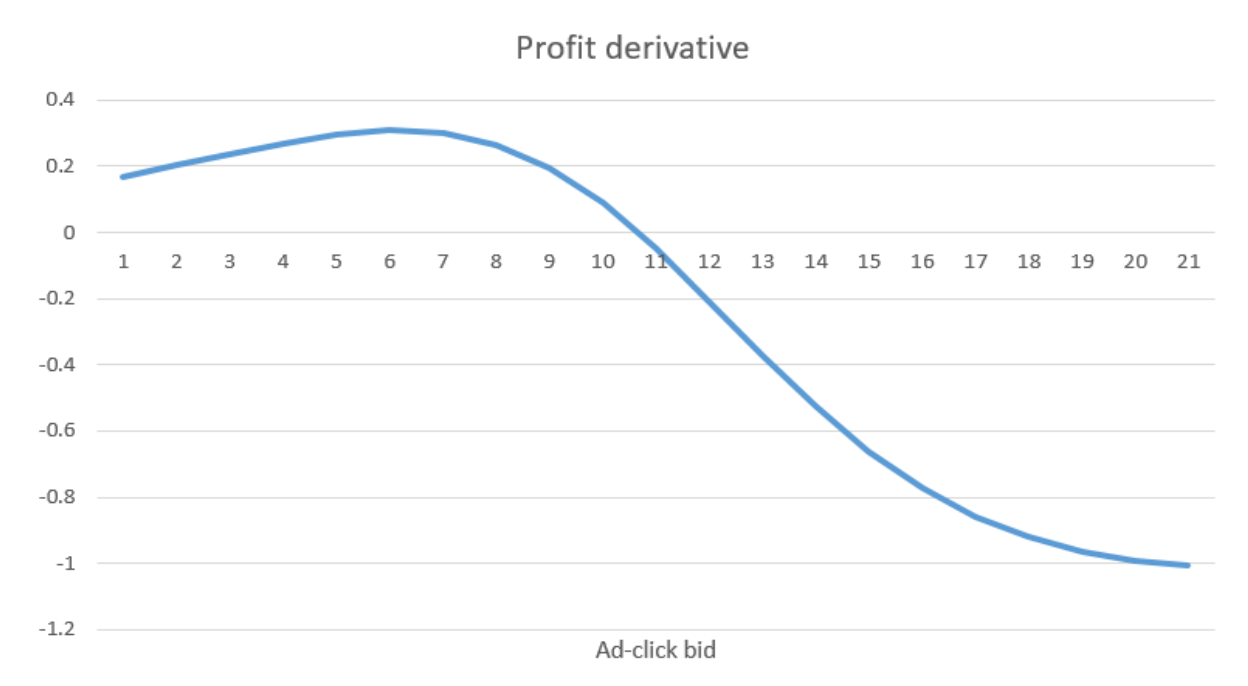
\[\left.\frac{d \Cbar(x)}{d x}\right\vert _{x=x^\ast } = 0.\]La Figura 12.3 muestra $\frac{d \Cbar(x\vert \theta)}{d x}$ versus la oferta $x$, mostrando el comportamiento de que comienza positiva y transiciona a negativa. El punto donde es igual a cero sería la oferta óptima, un punto que puede encontrarse numéricamente con bastante facilidad. Sea $X^{explt}(S^n)$ la oferta $x^\ast $ que satisface $d \Cbar(x)/dx = 0$.
Esto significa que tenemos que ejecutar un algoritmo numérico para calcular la política. Esta es una política voraz que cae dentro de la clase CFA, pero sin ningún parámetro ajustable.
Una política de excitación
Una limitación potencial de nuestra política de explotación pura es que ignora el valor de probar un rango más amplio de ofertas para ayudar con el proceso de aprender los valores correctos de $\theta$. Una estrategia popular es agregar un término de ruido, conocido en ingeniería como “excitación,” lo que nos da la política
\[X^{excite}(S^n\vert \rho) = X^{explt}(S^n) + \varepsilon(\rho)\]donde $\varepsilon(\rho) \sim N(0,\rho^2)$. En esta política, $\rho$ es nuestro parámetro ajustable que controla la cantidad de exploración en la política. Si es demasiado pequeño, puede que no haya suficiente exploración. Si es demasiado grande, elegiremos ofertas que estén lejos de lo óptimo, posiblemente sin ningún beneficio del aprendizaje.
Una política de valor de información
Las políticas de pura explotación y excitación que acabamos de introducir son ambas relativamente simples. Ahora vamos a considerar una política que maximiza el valor de la información en el futuro. Esto parece una idea razonable, pero requiere que pensemos en cómo la información ahora afecta la decisión que podríamos tomar en el futuro, y esto será un poco más difícil.
Nuestra política de explotación asume que los parámetros estimados $\theta^n$ después de $n$ experimentos son el valor correcto, y elige una oferta basada en esta estimación. Ahora imaginemos que ofertamos $x^n=x$ y observamos $K^{n+1}$ y $\Rhat^{n+1}$, y usamos esta información para obtener una estimación actualizada de $\theta^{n+1}$ así como de $\Rbar^{n+1}$. Luego podemos usar estas estimaciones actualizadas para tomar una mejor decisión. Queremos elegir la oferta $x$ que nos dé la mayor mejora en el valor de la información de una decisión, reconociendo que no conocemos el resultado de $W^{n+1} = (\Rhat^{n+1},K^{n+1})$ hasta que realmente coloquemos la oferta.
Sea $\theta^{n+1}(x^n,W^{n+1})$ la estimación actualizada de $\theta$ asumiendo que ofertamos $x^n=x$ y observamos $W^{n+1} = (\Rhat^{n+1},K^{n+1})$. Esta es una variable aleatoria, porque estamos pensando en colocar una oferta $x^n=x$ para la $n+1$-ésima subasta, pero aún no hemos colocado la oferta, lo que significa que aún no hemos observado $W^{n+1}$.
Para simplificar nuestro análisis, vamos a asumir que la variable aleatoria $K^{n+1} = 1$ con probabilidad $P^{click}(\theta,x)$ y $K^{n+1} = 0$ con probabilidad $1-P^{click}(\theta,x)$. Luego vamos a asumir que nuestra estimación del ingreso que recibimos por un clic en el anuncio se ha estabilizado, lo que significa que $\Rbar^{n+1} \approx \Rbar^n$.
Podemos pensar en esto como un modelo de anticipación aproximado, donde $\Rbar^n$ no cambia. Entonces escribiríamos nuestra información exógena en nuestro modelo de anticipación como
\[\Wtilde^{n,n+1}=\Ktilde^{n,n+1},\]donde el doble superíndice $(n,n+1)$ significa que esta es la información en un modelo de anticipación creado en el tiempo $n$, mirando lo que podría suceder en el tiempo $n+1$. La variable aleatoria $\Ktilde^{n,n+1}$ es el clic en el anuncio que estamos simulando que podría suceder en nuestro modelo de anticipación, en lugar de la observación real de si alguien hizo clic en el anuncio. Solo recuerde que usamos la tilde para cualquier variable en nuestro modelo de anticipación, y estas variables estarán indexadas por $n$ (el tiempo en el que estamos iniciando el modelo de anticipación), y $n+1$ (ya que estamos mirando un periodo de tiempo hacia adelante en el modelo de anticipación).
A continuación usamos nuestra ecuación de actualización $\eqref{eq:adclicktransition2}$ para las probabilidades $p^n_k = Prob[\theta=\theta_k\vert H^n]$. Podemos escribir estas probabilidades actualizadas como $\ptilde^{n,n+1}_k(\Ktilde^{n,n+1})$ para capturar la dependencia de la actualización en $\Ktilde^{n,n+1}$ (la ecuación $\eqref{eq:adclicktransition2}$ está escrita para $\Ktilde^{n,n+1}=1$). Dado que $\Ktilde^{n,n+1}$ puede tomar dos resultados (0 o 1) tendremos dos valores posibles para $\ptilde^{n,n+1}_k(\Ktilde^{n,n+1})$.
Ahora imaginemos que ejecutamos nuestra política de pura explotación $X^{explt}(S^n\vert \theta^n)$ que describimos anteriormente, pero vamos a hacerlo en nuestro modelo de anticipación aproximado (aquí es donde ignoramos los cambios en $\Rbar^n$). Sea $\Stilde^{n,n+1}$ que representa nuestro estado en el modelo de anticipación dado por
\[\Stilde^{n,n+1}(\Ktilde^{n,n+1}) = (\Rbar^n, \ptilde^{n,n+1}(\Ktilde^{n,n+1})).\]Recuerde: dado que $\Ktilde^{n,n+1}$ es una variable aleatoria (todavía estamos en el tiempo $n$), $\Stilde^{n,n+1}(\Ktilde^{n,n+1})$ también es una variable aleatoria, razón por la cual escribimos su dependencia explícita del resultado $\Ktilde^{n,n+1}$.
La forma de pensar en este modelo de anticipación es como si estuviera jugando un juego (como el ajedrez) donde piensa en un movimiento (para nosotros, esa sería la oferta $x^n$) y luego, antes de hacer el movimiento, piensa en lo que podría suceder en el futuro. En este problema, nuestro futuro solo tiene dos resultados (si un cliente hace clic o no en el anuncio), lo que significa dos valores posibles de $\Stilde^{n,n+1}$, que producen dos conjuntos de probabilidades actualizadas $\ptilde^{n,n+1}(K^{n+1})$.
Finalmente, esto significa que habrá dos valores de la oferta miope óptima (usando nuestra política de pura explotación) $X^{explt}(\Stilde^{n,n+1})$. La contribución esperada que obtendríamos en el futuro está entonces dada por $\Ctilde(\Stilde^{n,n+1},\xtilde^{n,n+1})$ donde $\xtilde^{n,n+1}$ (esta es la decisión que estamos pensando en tomar en el futuro) está dada por
\[\xtilde^{n,n+1} = X^{explt}(\Stilde^{n,n+1}).\]Esto significa que hay dos posibles decisiones óptimas, lo que implica dos valores diferentes de la contribución esperada $\Ctilde(\Stilde^{n,n+1},X^{explt}(\Stilde^{n,n+1}))$. Por compacidad, llamemos a estos $\Ctilde^{n,n+1}(1)$ (si $\Ktilde^{n,n+1} = 1$) y $\Ctilde^{n,n+1}(0)$ (si $\Ktilde^{n,n+1} = 0$). Piense en estos como las contribuciones esperadas que podrían ocurrir en el futuro dado lo que sabemos ahora. Finalmente, podemos tomar la esperanza sobre $\Ktilde^{n,n+1}$ para obtener la contribución esperada de colocar una oferta $x^n=x$ ahora mismo, que podemos calcular usando
\[\Cbar^n(x) = \sum_{k=1}^K \big(P^{click}(\theta=\theta_k,x) \Ctilde^{n,n+1}(1) + (1-P^{click}(\theta=\theta_k,x)) \Ctilde^{n,n+1}(0)\big) p^n_k.\]Nuestra política, entonces, es elegir la oferta $x$ que maximiza $\Cbar^n(x)$. Suponga que discretizamos nuestras ofertas en un conjunto $\Xcal = \lbrace x_1, \ldots, x_M\rbrace $. Nuestra política de valor de la información se escribiría como
\[X^{VoI}(S^n) = \argmax_{x\in\Xcal} \Cbar^n(x).\]Notamos que esta es una clase de política de aproximación de anticipación directa (DLA).
Las políticas de valor de la información son bastante poderosas. Son más difíciles de calcular, pero no tienen parámetros ajustables. Imagine, por ejemplo, hacer este cálculo cuando hay más de dos resultados. Por ejemplo, si no hubiéramos hecho nuestra simplificación de mantener $\Rbar^n$ constante, tendríamos que reconocer que esta variable de estado también está cambiando.
Notamos solo de paso que hemos ejecutado muchas comparaciones de diferentes políticas de aprendizaje, y la política de valor de la información de anticipación a un paso a menudo funciona bastante bien. Usamos este entorno porque hizo que las derivaciones fueran mucho más simples.
Se debe hacer una advertencia. Los problemas de aprendizaje donde el resultado es 0 o 1 son problemas donde un solo experimento proporciona muy poca información. En su lugar, es mejor asumir que tomamos nuestra decisión (es decir, fijamos la oferta) y luego la observamos durante, digamos, $M$ subastas. Esto significa que $\Ktilde^{n,n+1}$ ahora podría ser un número entre 0 y $M$. El número $M$ se convierte en un parámetro ajustable, y los cálculos se volvieron un poco más complejos (tenemos que sumar sobre $M+1$ realizaciones en lugar de solo dos), pero este enfoque puede funcionar bastante bien.
Extensión: Clientes con atributos simples
Supongamos que conocemos la ubicación de un cliente hasta una región o la ciudad principal más cercana, que designamos por $L$. Si pensamos que el comportamiento de cada región es diferente, podríamos indexar $\theta$ por $\theta_\ell$ si el cliente proviene de la ubicación $L=\ell$. Esto significa que si hay 1,000 ubicaciones, entonces tenemos que estimar 1,000 modelos, lo que significa 1,000 valores de $\theta = (\theta^{const},\theta^{bid})$.
Un enfoque alternativo sería especificar un modelo de la forma
\[Prob^n[K^{n+1}=1\vert \theta] = \frac{e^{U(x,L\vert \theta)}}{1+e^{U(x,L\vert \theta)}}.\]donde ahora vamos a usar como nuestra función de utilidad
\[U(x,L\vert \theta) = \theta^{const} + \theta^{bid}x + \sum_{\ell=1}^L \theta^{loc}_\ell I_{\ell=L}.\]Este es un modelo más compacto porque ahora asumimos que el término constante $\theta^{const}$ y el coeficiente de oferta $\theta^{bid}$ no dependen de la ubicación. En cambio, simplemente estamos añadiendo un desplazamiento $\theta^{loc}_\ell$. Entonces, todavía tenemos 1,000 parámetros que estimar (los coeficientes de ubicación), pero antes teníamos 2,000 parámetros que estimar: $\theta^{const}_\ell$ y $\theta^{bid}_\ell$ para cada ubicación $\ell \in \lbrace 1, \ldots, L\rbrace $.
¿Qué aprendimos?
- Este es otro problema de puro aprendizaje (nuestro problema de la diabetes en el Capítulo 4 era un problema de puro aprendizaje) pero esta vez estamos usando un modelo de creencia no lineal, con un modelo muestreado para el parámetro desconocido $\theta$ que determina la respuesta al precio.
- La función de transición incluye la actualización bayesiana de las creencias sobre las probabilidades $p^n_k$ de que el parámetro desconocido $\theta$ sea igual a un valor específico $\theta_k$.
- Hay tres formas de incertidumbre: si alguien hará clic en un anuncio dado el precio de la oferta; los ingresos obtenidos al hacer clic en el anuncio (por ejemplo, si el cliente compró el producto), y la incertidumbre sobre la respuesta del mercado capturada por el parámetro desconocido $\theta$.
- Ilustramos una política de pura explotación, una política de excitación (que simplemente aleatoriza el precio recomendado por la política de explotación), y una política de gradiente de conocimiento que maximiza el valor de la información.
Ejercicios
Preguntas de repaso
- ¿Qué modelo probabilístico se asume para la variable aleatoria $K^n$ que indica si un cliente hizo clic en el anuncio o no?
- ¿Qué modelo probabilístico asumimos para el vector de parámetros desconocido (y por lo tanto incierto) $\theta$?
- ¿Qué distribución de probabilidad asumimos para el ingreso $\Rhat^{n+1}$ que recibimos cuando el cliente hace clic en un anuncio?
- Indique los números de las ecuaciones que constituyen la función de transición.
- ¿Qué información probabilística está en el estado inicial $S^0$?
- ¿Qué se logra al añadir el término de ruido $\varepsilon(\rho)$ para crear la política de excitación? ¿Qué parámetro(s) específico(s) nos ayuda esto a identificar?
- Describa en palabras la lógica detrás de la política de valor de la información. ¿Cuál es el valor si saber si un cliente hace clic o no en el anuncio no cambia lo que vamos a ofertar?
Preguntas de resolución de problemas
Sistema de recomendación parte I - Modelo de creencia - Va a ayudar a diseñar un sistema de recomendación que recomienda productos para anunciar cuando un cliente está desplazándose por un sitio web. Dado que el cliente tiene que iniciar sesión, podemos identificar al $n$-ésimo cliente mediante un vector de atributos $a=a^n$ que incluye:
$a_1$ Género (2 tipos). $a_2$ Rango de edad $(0$–$10, 11$–$20, \ldots, 70$–$100)$ (8 tipos). $a_3$ Tipo de dispositivo (smartphone, laptop, tableta) (3 tipos). $a_4$ Región (200). $a_5$ ID único (dirección de correo electrónico) (100 millones). Imagine que estamos recomendando artículos de texto. Suponga que el artículo que recomendamos para el $n$-ésimo cliente tiene atributos $b=b^n$ que incluyen:
$b_1$ Noticias, deportes, arte, negocios, cocina, bienes raíces (6 tipos). $b_2$ Subcategoría: si es noticias, entonces internacional, nacional (por país), regional (región dentro de un país); si es deportes, entonces por deporte, y luego por equipo (o atleta); y así sucesivamente (un total de 500). $b_3$ Fuente (sitio web, periódico, ...) (5 fuentes). $b_4$ Autor (2,000). $b_5$ ID único del artículo (6 millones). Nos gustaría estimar:
$P(b^n\vert a^n)$ = Probabilidad de que el $n$-ésimo cliente con atributo $a^n$ haga clic en el enlace de un artículo con atributo $b^n$.
Cuando llega el cliente $a^n$, vamos a suponer que tenemos que elegir un artículo de noticias de un conjunto $\Bcal^n$, que es el conjunto de artículos disponibles cuando llega el $n$-ésimo cliente (este conjunto cambia con el tiempo). Nos gustaría elegir un artículo con atributo $b\in\Bcal^n$ que maximice la probabilidad de que nuestro cliente haga clic en este artículo de noticias. Nuestra política tiene que elegir un artículo particular con atributo $b^n$.
Idealmente, queremos $P(b^n_5\vert a^n_5)$ que es la probabilidad de que el usuario $a^n_5$ seleccione el artículo $b^n_5$, pero hay demasiados usuarios y demasiados artículos para obtener estimaciones razonables de esta probabilidad. Si solo consideramos los elementos $a_1, a_2, a_3$ y $a_4$, habría 9,600 combinaciones, con un promedio de aproximadamente 10,000 personas para cada uno de estos primeros cuatro elementos. A continuación, vamos a suponer que solo usamos $a_1$ y $a_2$, lo que significa 16 tipos de personas.
Vamos a crear un conjunto de características $\Fcal$ que se construyen a partir de los elementos de $a$ y $b$ que deseamos considerar. Vamos a usar solo los elementos $\lbrace a_1,a_2,b_1,b_2,b_3\rbrace $ a partir de los cuales vamos a construir un conjunto de variables de características $\phi_f(a,b),~f\in\Fcal$. Dado que estos cinco elementos son todos categóricos, las características más elementales son variables indicadoras. Por ejemplo, para el atributo de género $a_1$ tenemos dos géneros a partir de los cuales creamos dos características:
$$ \phi_{male}(a) = \begin{cases} 1 & \text{if } a_1 = male, \\ 0 & \text{otherwise.} \end{cases} \qquad \phi_{female}(a) = \begin{cases} 1 & \text{if } a_1 = female, \\ 0 & \text{otherwise.} \end{cases} $$Si nos restringimos a estas características elementales, tendríamos una característica para cada valor posible de cada elemento de los atributos $a_1,a_2,b_1,b_2,b_3$.
Nuestro proceso comienza cuando el primer cliente inicia sesión con el vector de atributos $a^1$, momento en el cual tenemos que decidir los atributos de un artículo $b^1$ para mostrar a este usuario, y luego observamos $Y^1$, donde $Y^1 = 1$ si el cliente hace clic en el artículo o 0 en caso contrario. Esta información se usa para crear un estado actualizado $S^1$, después de lo cual observamos al cliente $a^2$.
Si $a^n$ son los atributos del $n$-ésimo cliente, entonces nuestra decisión es elegir $b^n$ usando lo que sabemos, lo cual designamos como $S^n$. Nuestro objetivo es modelar este problema y diseñar una política $B^\pi(S^n)$ que determine $b^n$.
Nuestro primer desafío es desarrollar un modelo de creencia:
- Si usamos un modelo de creencia de tabla de consulta para $P(b\vert a)$ usando los atributos $\lbrace a_1,a_2, b_1,b_2,b_3\rbrace $, ¿cuántos parámetros estamos tratando de estimar?
- En cambio, considere usar una regresión logística. Primero defina una función de utilidad $$ U(a,b\vert \theta) = \sum_{f\in\Fcal} \theta_f \phi_f(b\vert a), $$ donde $\Fcal$ es el conjunto de características elementales que podemos construir a partir de los elementos $\lbrace a_1,a_2,b_1,b_2,b_3\rbrace $. Ahora cree un modelo de regresión logística para la probabilidad de hacer clic en un artículo usando $$ P(Y=1\vert a,b,\theta) = \frac{e^{U(a,b\vert \theta)}}{1+e^{U(a,b\vert \theta)}}. $$ ¿Cuál es la dimensionalidad del vector $\theta$ suponiendo que solo usamos variables indicadoras elementales?
- Reconociendo que el número de parámetros en el modelo paramétrico de la parte (b) es mucho menor que el número de parámetros en el modelo de tabla de consulta de la parte (a), ¿por qué alguien usaría un modelo de creencia de tabla de consulta en lugar de un modelo paramétrico como la regresión logística? Discuta las ventajas y desventajas de cada tipo de modelo de creencia.
- Ahora necesitamos estimar $\theta$. Suponga que generamos una muestra de valores posibles del vector $\theta$ que representamos como $\lbrace \theta_1, \ldots, \theta_k, \ldots, \theta_K\rbrace $, donde cada $\theta_k$ es un vector con elemento $\theta_{kf},~f\in\Fcal$. Comience con la probabilidad previa $p^0_k = 1/K$. A continuación, suponga que observamos los atributos del primer cliente $a^1$, y luego tomamos la decisión de mostrar un artículo con atributo $b^1$ (esta es nuestra variable de decisión). Suponiendo que conoce $p^n_k$, escriba el teorema de Bayes para calcular $p^{n+1}_k$ después de observar a un cliente con atributo $a^{n+1}$, y luego elegir un artículo con atributo $b^{n+1}$, tras lo cual observa el resultado $Y^{n+1} = 1$.
- Sistema de recomendación parte II - Modelo del sistema - Ahora vamos a modelar los cinco elementos del problema.
- Dé los elementos del estado pre-decisión $S^n$ y del estado post-decisión $S^{b,n}$.
- Hay dos formas de información exógena en este proceso. ¿Cuáles son?
- Escriba la secuencia de estados (pre- y post-), decisiones y las diferentes formas de información exógena comenzando con lo que sabemos en el tiempo 0 y procediendo hasta (pero sin incluir) la llegada del tercer cliente. Escríbalos en el orden en que ocurren, con la indexación adecuada (por ejemplo, $n$ frente a $n+1$).
- Escriba las ecuaciones que representan la función de transición.
- Escriba la función objetivo para encontrar la mejor política $B^\pi(S^n)$ (sin especificar el tipo de política).
- Sistema de recomendación parte III - Diseño de políticas - Finalmente vamos a intentar diseñar políticas. Suponga que tenemos $K=20$ valores posibles de $\theta$.
- Comience suponiendo que sabemos que $\theta = \theta_k$. Escriba una política de pura explotación donde elegimos el atributo $b\in\Bcal^n$ que maximiza la probabilidad de ser elegido, dado que $\theta = \theta_k$.
- A continuación, suponga que no sabemos que $\theta=\theta_k$. En cambio, $\theta=\theta_k$ con probabilidad $p^n_k$. Reescriba su política de la parte (a) donde tiene que tratar $\theta$ como una variable aleatoria. Necesitará insertar una esperanza en algún lugar.
- La política en (b) podría considerarse demasiado costosa de calcular. Puede simplificarla reemplazando la variable aleatoria $\theta$ por su esperanza $$ \thetabar^n = \E^n \theta_k = \sum_{k=1}^K \theta_k p^n_k. $$ Reescriba su política de la parte (b) usando esta estimación puntual. Suponga que solo está considerando artículos donde la probabilidad de hacer clic en un artículo es mayor que 0.5. ¿Cómo cree que se compararía la probabilidad de hacer clic en un artículo calculada usando la estimación puntual en (c) con la estimación proporcionada usando la esperanza en (b)?
- La política de estimación por intervalos utiliza, digamos, el percentil 95 de la estimación del valor de una elección. Sea $\rho$ el percentil deseado, y suponga que debe redondearse a 0.05 (porque hemos elegido $K=20$ valores posibles para $\theta$). Muestre cómo diseñar una política que elija el vector de atributos $b$ que maximiza la $\rho$-ésima probabilidad (en lugar de la estimación puntual), y dé la función objetivo para encontrar el mejor valor de $\rho$ que maximice el número total de clics en anuncios.