Capítulo 1: Modelado de problemas de decisión secuencial
El proceso de resolver cualquier problema físico (y en particular cualquier problema de decisión secuencial) en la computadora requiere construir un modelo matemático, tal como se ilustra en la Figura 1.1. Durante décadas, la comunidad de investigación ha utilizado un marco matemático estándar para problemas de decisión donde todos los datos se conocen de antemano (conocido como optimización determinista). Una versión simple de un problema de optimización determinista, conocido como programa lineal, podría escribirse
\[\begin{align} \min_x c^T x, \label{eq:linearprogram1} \end{align}\]donde $x$ es un vector de elementos que deben satisfacer un conjunto de restricciones que típicamente se escriben
\[\begin{align} A x & = b, \label{eq:linearprogram2}\\ x & \geq 0. \label{eq:linearprogram3} \end{align}\]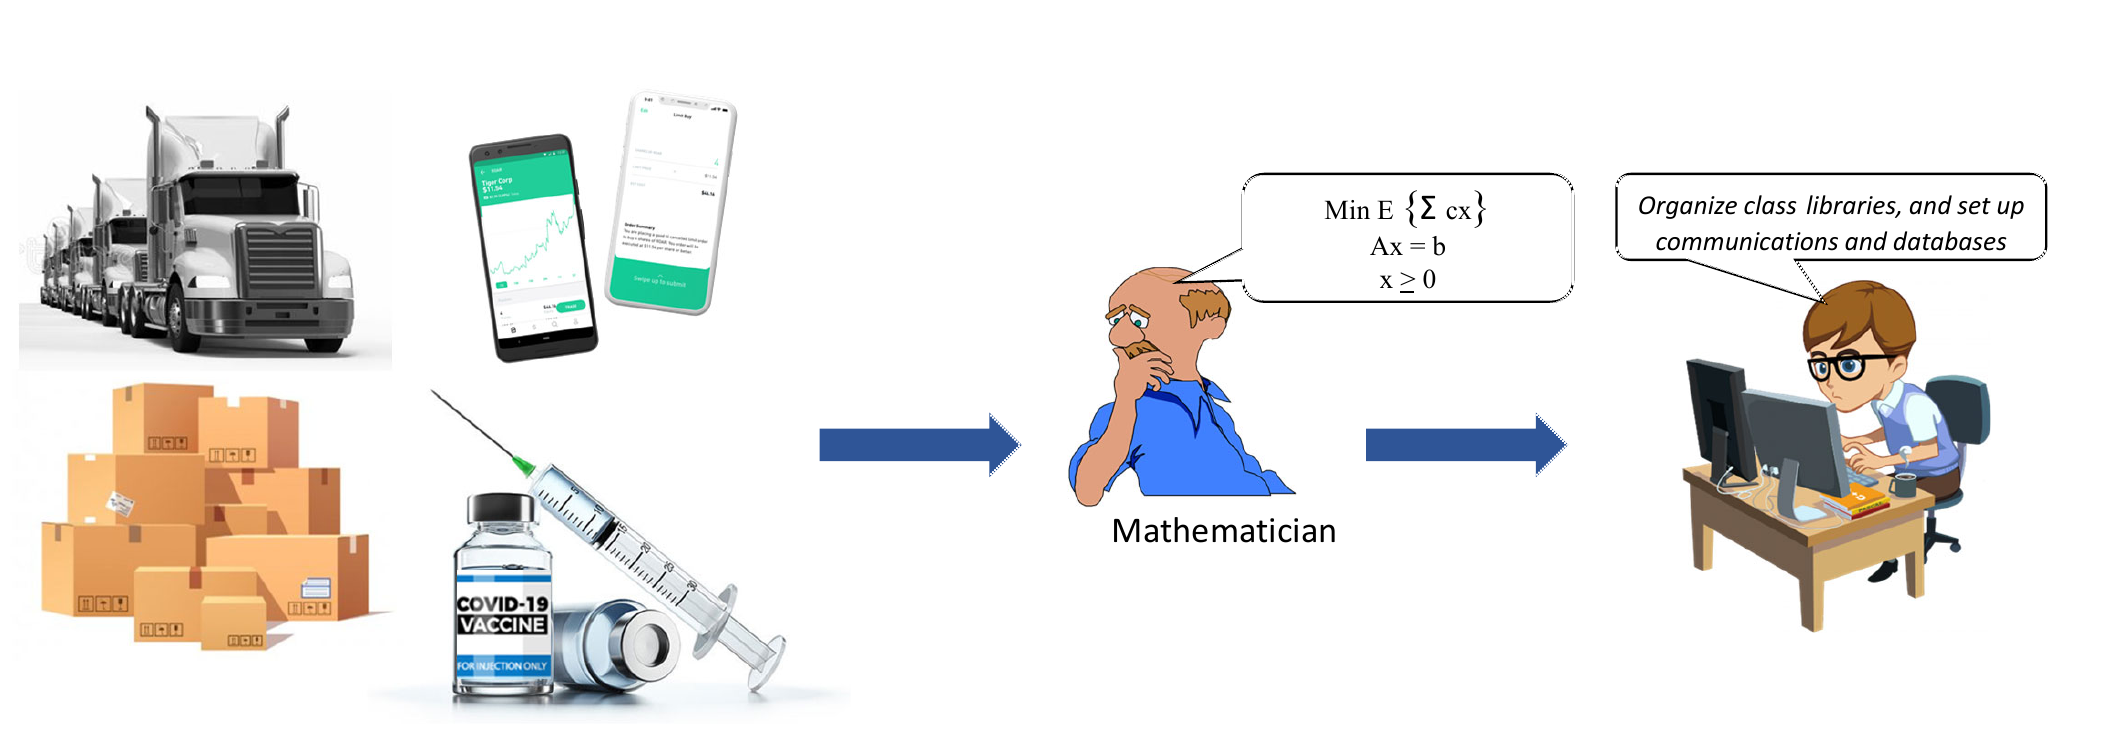
No es necesario entender las ecuaciones $\eqref{eq:linearprogram1}$–$\eqref{eq:linearprogram3}$ (lo cual requiere un conocimiento básico de álgebra lineal), pero miles de estudiantes se graduán cada año de cursos donde aprenden esta notación, y también aprenden a traducir una amplia gama de problemas físicos a esta notación. Luego, existen paquetes de software que traducen problemas en este formato a una solución. Lo más importante es que este lenguaje de notación se habla en todo el mundo. La misma afirmación puede hacerse sobre el modelado estadístico/aprendizaje automático, que hoy en día es una comunidad mucho más grande que la de las personas que entienden las ecuaciones $\eqref{eq:linearprogram1}$–$\eqref{eq:linearprogram3}$.
No podemos hacer la misma afirmación sobre los problemas de decisión secuencial, que son una clase de problemas estudiada por al menos 15 comunidades diferentes que utilizan ocho estilos de notación fundamentalmente distintos, a menudo empleando matemáticas que requieren una formación avanzada. En este libro, usamos un estilo de enseñanza mediante ejemplos para mostrar cómo modelar la clase increíblemente rica de problemas que llamamos problemas de decisión secuencial. Aunque nos centramos en problemas relativamente más simples, nuestro marco puede utilizarse para modelar cualquier problema de decisión secuencial. Además, el modelo resultante puede traducirse directamente a software.
El fundamento analítico de este libro está contenido en Reinforcement Learning and Stochastic Optimization: A unified framework for sequential decisions (RLSO), que es un texto de nivel de posgrado centrado en la metodología. De vez en cuando haremos referencia al material de ese libro para los lectores que puedan estar interesados en una mayor profundidad, y animamos a los lectores con inclinación técnica a usar RLSO como referencia. Sin embargo, no es necesario. Este libro está diseñado para proporcionar el contexto de fondo en forma de una serie de ejemplos que deberían permitir a los lectores pensar de manera clara y precisa sobre los problemas de decisión secuencial, incluso si nunca van a escribir una línea de código.
Este libro está dirigido a estudiantes de nivel universitario o de maestría que hayan tomado un curso de probabilidad y estadística (no se necesita conocimiento de programación lineal, aunque tenemos un ejemplo que requiere resolver un programa lineal). Todos los capítulos están construidos alrededor de ejemplos específicos, con la excepción del capítulo 1, que ofrece una visión general de todo el marco de modelado, y el capítulo 7, donde nos detenemos y utilizamos los primeros seis capítulos para ilustrar algunos principios importantes.
La presentación no debería requerir matemáticas más allá de lo que se esperaría en un primer curso de probabilidad y estadística. Dicho esto, el libro se centra en mostrar cómo describir problemas de decisión secuencial utilizando una notación lo suficientemente precisa como para que pueda ser la base de un software de computadora.
Módulos de Python acompañan a la mayoría de los capítulos; estos módulos fueron escritos alrededor del marco de modelado que recorre todo el libro. Al mismo tiempo, cualquier paquete de software que simule un problema de decisión secuencial, independientemente de cómo se esté resolviendo, puede traducirse directamente al marco de modelado que utilizamos. Por esta razón, animamos a los lectores a considerar cualquier pieza de notación como una variable en un programa de computadora.
Primeros pasos
Los problemas de decisión secuencial siempre pueden escribirse como
\[decision,\ information, \ decision, \ information, \ decision, \ldots\]Cada vez que tomamos una decisión, incurrimos en un costo o recibimos una contribución o recompensa (hay muchas formas de medir el desempeño). Las decisiones se toman con un método al que nos referiremos como política. Un objetivo principal que constituye un enfoque central de este libro es diseñar políticas efectivas que funcionen bien a lo largo del tiempo, en presencia de la incertidumbre de información que aún no ha llegado.
Los problemas de decisión secuencial son omnipresentes y surgen en prácticamente todos los procesos humanos. La Tabla 1.1 proporciona una lista de muestra de campos, con ejemplos de algunas de las decisiones que podrían surgir. La mayoría de estos campos probablemente tienen muchos tipos diferentes de decisiones, que van en complejidad desde cuándo vender un activo o adoptar un nuevo diseño web, hasta elegir el mejor medicamento, material o instalación para diseñar, o gestionar cadenas de suministro complejas o despachar una flota de camiones.
| Campo | Preguntas |
|---|---|
| Negocios | ¿Qué productos deberíamos vender, con qué características? ¿Qué proveedores deberíamos usar? ¿Qué precio deberíamos cobrar? |
| Economía | ¿Qué tasa de interés debería cobrar la Reserva Federal dado el estado de la economía? ¿Qué niveles de liquidez del mercado deberían proporcionarse? |
| Finanzas | ¿En qué acciones debería invertir una cartera? ¿Cómo debería un operador cubrir un contrato ante un posible riesgo a la baja? |
| Internet | ¿Qué anuncios deberíamos mostrar para maximizar los clics en los anuncios? ¿Qué películas atraen más atención? ¿Cuándo/cómo deberían enviarse avisos masivos? |
| Ingeniería | ¿Cómo diseñar dispositivos, desde latas de aerosol hasta vehículos eléctricos, puentes hasta sistemas de transporte, transistores hasta computadoras? |
| Salud pública | ¿Cómo deberíamos realizar pruebas para estimar la progresión de una enfermedad? ¿Cómo deberían asignarse las vacunas? ¿Qué grupos de población deberían ser el objetivo? |
| Investigación médica | ¿Qué configuración molecular producirá el medicamento que elimine más células cancerosas? ¿Qué conjunto de pasos se requieren para producir nanotubos de pared simple? |
| Gestión de la cadena de suministro | ¿Cuándo deberíamos hacer un pedido de inventario desde China? ¿Qué proveedor debería utilizarse? |
| Transporte de carga | ¿Qué conductor debería mover una carga? ¿Qué cargas debería comprometerse a mover un transportista de carga completa? ¿Dónde deberían domiciliarse los conductores? |
| Recolección de información | ¿Adónde deberíamos enviar un dron para recopilar información sobre incendios forestales o especies invasoras? ¿Qué medicamento deberíamos probar para combatir una enfermedad? |
| Sistemas multiagente | ¿Cómo debería una gran empresa en un mercado oligopólico ofertar en contratos, anticipando la respuesta de sus competidores? |
| Algoritmos | ¿Qué regla de tamaño de paso deberíamos usar en un algoritmo de búsqueda? ¿Cómo determinamos el siguiente punto para evaluar una función costosa? |
Tabla 1.1. Una muestra de diferentes campos y decisiones que deben tomarse dentro de cada campo.
Aún más desafiante que enumerar todos los tipos de decisiones es identificar las diferentes fuentes de incertidumbre que surgen en muchas aplicaciones. El comportamiento humano, los mercados, los procesos físicos, las redes de transporte, los sistemas energéticos y la amplia gama de incertidumbres que surgen en la salud sugieren la diversidad de diferentes fuentes de incertidumbre.
Mientras se escribe este libro, la humanidad está lidiando con la propagación de variantes del COVID-19. Enfrentar esta pandemia ha sido descrito como “asombrosamente complejo” [USA Today, 8 de septiembre de 2020], pero esto es realmente el resultado de no haber pensado el problema de manera estructurada. Vamos a mostrar al lector cómo descomponer los problemas en una serie de componentes básicos que conducen a soluciones prácticas.
Nuestro enfoque comienza identificando algunos elementos centrales, como métricas de desempeño, decisiones y fuentes de incertidumbre, lo que luego conduce a la creación de un modelo matemático del problema. El siguiente paso suele ser (aunque no siempre) implementar el modelo en la computadora, pero habrá muchos problemas donde el proceso de construir un modelo computacional sea impráctico por diversas razones. Por esta razón, también consideraremos problemas donde debamos probar y evaluar ideas en el campo. Para mejorar el desempeño, primero necesitamos aprender a tomar buenas decisiones a lo largo del tiempo (así es como controlamos el sistema). Luego, pasamos al diseño del sistema.
En este momento, la comunidad académica no ha adoptado un proceso de modelado estándar para los problemas de decisión secuencial. Esto contrasta fuertemente con el ámbito de los problemas de optimización estática y determinista, que han seguido un marco estricto desde la década de 1950 (las ecuaciones $\eqref{eq:linearprogram1}$–$\eqref{eq:linearprogram3}$ representan una muestra de este marco). Nuestro proceso de modelado se basa en la presentación de RLSO, que es un libro dirigido a una audiencia técnica principalmente interesada en desarrollar e implementar modelos en la computadora.
Por el contrario, este libro está dirigido a una audiencia más amplia que está interesada, ante todo, en aprender a pensar sobre los problemas de decisión secuencial. Utiliza un estilo de enseñanza mediante ejemplos que se centra en comunicar el proceso de modelado, el cual creemos que puede ser útil incluso sin llegar a crear modelos computacionales. Central a nuestro enfoque es la creación de un modelo matemático que elimina la ambigüedad al describir problemas en lenguaje llano. Para los lectores interesados en desarrollar modelos computacionales, la notación es el trampolín hacia la escritura de software. Sin embargo, vamos a utilizar principalmente la notación matemática para crear claridad al describir un problema, incluso si el lector nunca tiene la intención de escribir una línea de código.
Nuestra presentación procede de la siguiente manera:
- El Capítulo 1 ofrece una introducción ligera al marco de modelado universal, ilustrado mediante dos problemas de inventario (uno simple y otro un poco más complejo), seguido de una breve discusión sobre el modelado de la incertidumbre. Luego proporciona una introducción a las cuatro clases de políticas que cubren todos los métodos para tomar decisiones.
- Los Capítulos 2–6 describen cada uno un problema de decisión secuencial específico para ilustrar el marco de modelado utilizando un estilo de enseñanza mediante ejemplos. Estas aplicaciones se eligieron para resaltar cada una de las cuatro clases de políticas.
- El Capítulo 7 vuelve al marco de modelado universal con mayor detalle. Se ofrece una discusión mucho más cuidadosa de las cuatro clases de políticas, así como de los diferentes tipos de variables de estado, utilizando los ejemplos de los capítulos 2–6 para proporcionar contexto.
- Los Capítulos 8–14 ofrecen ejemplos adicionales, utilizando entornos más complejos para ilustrar conceptos de modelado más avanzados, abarcando tanto el modelado de la incertidumbre (en particular el modelado de los precios de la electricidad en el Capítulo 8) como un conjunto más rico de políticas.
Los capítulos de aplicación (2–6 y 8–14) siguen todos el mismo esquema. Pueden abordarse en cualquier orden, teniendo en cuenta que las aplicaciones de los capítulos 2–6 son más simples y fueron elegidas para ilustrar cada una de las cuatro clases de políticas. Los lectores interesados en temas de modelado específicos (como las variables de estado, el modelado de la incertidumbre o ver diferentes ejemplos de políticas) pueden hojear los capítulos, saltando directamente a los temas que les interesen.
Cada capítulo termina con una serie de ejercicios divididos en tres categorías:
- Preguntas de repaso – Son preguntas sencillas que se pueden usar para reforzar una comprensión básica a partir de la lectura del capítulo.
- Preguntas de resolución de problemas – Estas introducen desafíos de modelado que requieren habilidades de resolución de problemas.
- Preguntas de programación – La mayoría de los capítulos tienen ejercicios de programación que se basan en un conjunto de módulos de Python. Los módulos de Python originales, escritos en Python 2, se beneficiaron de una importante actualización realizada por el profesor Dennis Djanka, profesor de la Universidad de Karlsruhe en Alemania. La nueva biblioteca puede descargarse desde tinyurl.com/sdagithub. Algunas de estas preguntas requieren realizar modificaciones de programación al código Python.
Entonces, ¿qué es una decisión?
Existe una larga historia, que se remonta a más de 2.000 años atrás, a la época de Sócrates, Aristóteles y Platón, que documenta el estudio de cómo las personas toman decisiones. Luego existe una literatura sustancial, en su mayoría desde la década de 1950 (pero con algunos trabajos importantes anteriores), sobre las matemáticas de la toma de decisiones óptimas, que consiste en muchos miles de artículos y libros. Lo que esta literatura parece pasar por alto es la pregunta básica:
¿Qué es una decisión?
Comenzamos con la observación de que una decisión es una forma de información que afecta el comportamiento de algún “sistema” que buscamos controlar. Implícito en este sistema hay una o más medidas que cuantifican cuán bien está funcionando nuestro sistema. Luego tenemos que identificar un agente que controla algún aspecto de nuestro sistema.
Dado este fundamento, es útil identificar tres clases de información:
- El estado de conocimiento – Esta es información que tenemos en este momento y que es relevante para el desempeño de nuestro sistema.
- Información que cambia el estado de conocimiento que nosotros controlamos (esto requiere identificar un agente controlador para nuestro sistema).
- Información que llega a nuestro sistema y que cambia el estado de conocimiento, pero que está fuera de nuestro control.
Nos referimos a la información de la clase 2 como decisiones. Esto sugiere una definición formal de una decisión, basada en Bridging Decision Problems, Volume I: Framing the Problem:
Definición (formal): Una decisión es una clase de información endógenamente controlable.
Una definición informal podría ser:
Definición (informal): Una decisión es información que controlamos.
Estas definiciones ofrecen un punto de partida, pero no aprendemos mucho de ellas. Mucho más interesante es identificar ejemplos específicos de decisiones, lo cual haremos a continuación.
Tipos de decisiones
Hemos identificado 10 tipos de decisiones basándonos en los contextos y las herramientas que podríamos usar para determinar las mejores decisiones. Estos son:
1) Decisiones físicas y financieras – Estas decisiones surgen en la gestión de recursos físicos y financieros, como personas, equipos, instalaciones, productos, agua, energía, así como recursos financieros como efectivo o inversiones. Las decisiones incluyen comprar, vender y modificar recursos, donde una modificación podría significar moverlo de un lugar a otro, reparar equipo, capacitar a una persona, o combinar ingredientes para hacer un pastel.
2) Decisiones complejas/estratégicas – Son decisiones que pueden realizar múltiples cambios en un sistema (cambiando recursos, parámetros, creencias), y que típicamente implican fuentes significativas de incertidumbre. Estas decisiones normalmente se evalúan una sola vez, pero puede existir la opción de esperar y tomar la decisión más adelante.
3) Decisiones de adquisición/observación de información – Estas incluyen decisiones como realizar experimentos en el laboratorio, pruebas de campo o simulaciones por computadora. Podría incluir realizar estudios de mercado, contratar a un experto, o consultar a un modelo de lenguaje grande.
4) Decisiones de comunicación/intercambio de información – Estas se presentan en dos formas:
- a) Mensajería – Esto refleja lo que decimos en texto, video y/o audio.
- b) Canales y temporización – Esto cubre la elección de cómo enviar la información: texto/correos electrónicos, publicación (impresa o en línea), redes sociales, o canales publicitarios. También requiere elegir el momento y la frecuencia.
5) Métricas de desempeño y objetivos – Estas representan la elección crítica de cuantificar lo que estamos tratando de lograr, como maximizar ingresos, minimizar costos, minimizar enfermedades, o maximizar los votos recibidos.
6) Elección de funciones – Estas pueden ser métodos para tomar decisiones (políticas), la formulación de modelos de optimización, la elección de métricas de desempeño, métodos de pronóstico o estimación, o el diseño de funciones de transición (como la forma en que se propaga una enfermedad).
7) Establecimiento de parámetros – A menudo hay una serie de parámetros que afectan el desempeño de un sistema. Estos podrían ser precios, los coeficientes de un modelo estadístico, la temperatura utilizada en un proceso de fabricación. Podrían ser el peso otorgado a una métrica de desempeño, o los objetivos de desempeño.
8) Estimación o identificación – Podríamos necesitar identificar a una persona, pronosticar la demanda, o nombrar una enfermedad.
9) Características y comportamientos – Cómo diseñar un producto, qué características debe tener un paquete de software, qué servicios se deben ofrecer a un cliente, o la carrera de un estudiante, que determina con qué habilidades se graduará.
10) Decidir qué decidir – Aunque generalmente no usamos un análisis formal para esta última decisión, es importante reconocer cuándo estamos tomando una decisión, y si queremos abordarla formalmente usando análisis de datos y modelado.
Implícito en la identificación de decisiones está la comprensión de cómo la decisión afecta el desempeño del sistema. Mover recursos físicos (tipo 1) tiene un costo, mientras que satisfacer demandas genera ingresos. Una decisión puede tener un impacto inmediato en una o más métricas de desempeño (como suele ocurrir con la gestión de recursos), pero a menudo las decisiones deben evaluarse a lo largo del tiempo, y dependen de información que no se conoce cuando se toma la decisión. Por esta razón, con frecuencia estamos evaluando cómo estamos tomando las decisiones (es decir, el método) en lugar de la decisión misma.
Encuadre del problema
El primer paso al abordar un problema de decisión implica responder tres preguntas:
- ¿Cuáles son las métricas de desempeño?
- ¿Qué tipos de decisiones se están tomando (y quién las toma)?
- ¿Cuáles son las incertidumbres que afectan el desempeño?
Nótese que las respuestas a estas preguntas son fundamentales para cualquier problema de decisión. En este libro, estas preguntas parecerán bastante simples, porque las respondemos en el contexto de los modelos que ya hemos diseñado para resolver un problema. En aplicaciones reales, las listas de métricas de desempeño, decisiones e incertidumbres pueden ser bastante largas.
Como indicio de la riqueza que puede alcanzar el encuadre de un problema, animamos al lector a consultar la monografía Framing the Problem, dedicada precisamente a este tema. La monografía tiene capítulos enteros dedicados a cada una de estas preguntas, que se ilustran usando una docena de aplicaciones diferentes.
El objetivo del proceso de encuadre es identificar lo que importa, comenzando con las métricas de desempeño, donde incluso un problema simple de inventario puede describirse con más de 20 métricas de desempeño, 30 tipos diferentes de decisiones y más de 30 tipos de incertidumbres. La hoja de cálculo que las enumera se puede encontrar en tinyurl.com/PowellInventoryDecisions. Esto no significa que realmente vayamos a construir un modelo con toda esta complejidad. Por esta razón, el libro introduce un dispositivo llamado matrices de interacción, donde un experto del dominio prioriza las métricas, y luego usa su juicio para identificar las decisiones y las incertidumbres que tienen el mayor impacto en las métricas más importantes.
Este libro asume que ya hemos reducido un problema a un pequeño número de métricas, decisiones e incertidumbres, y usa estas para enfocar el desarrollo de un modelo matemático.
El proceso de modelado
El modelado es un arte, pero es un arte guiado por un marco matemático que garantiza que obtengamos un problema bien definido que podamos poner en la computadora y resolver. Esto puede verse como la construcción de un puente desde un problema del mundo real, desordenado y mal definido, hacia algo con la claridad que una computadora puede entender, incluso si su objetivo final no es ponerlo en la computadora.
Históricamente, si un esfuerzo de modelado implicaba intentar tomar decisiones, la gente recurría al marco bien conocido de la optimización determinista, que a menudo se parece al modelo dado por las ecuaciones $\eqref{eq:linearprogram1}$–$\eqref{eq:linearprogram3}$, el cual consiste en variables de decisión $x$, una función objetivo $cx$, y las restricciones dadas por $\eqref{eq:linearprogram2}$–$\eqref{eq:linearprogram3}$.
El problema con este marco de modelado clásico es lo que deja fuera:
- Asume que todos los datos (contenidos en las variables $A$, $b$ y $c$) que caracterizan al modelo se conocen perfectamente.
- La mayoría de las decisiones ocurren repetidamente a lo largo del tiempo, y sin embargo no hay reconocimiento de esto.
- No hay manera de representar el flujo de información hacia el sistema.
- Como consecuencia, la solución óptima de este modelo no puede anticipar eventos que afecten el desempeño de $x$ en la práctica.
- No hay manera de representar el riesgo, un tema importante en muchas aplicaciones.
- Se asume un único tomador de decisiones.
Los modelos matemáticos deben, ante todo, proporcionar un camino que nos indique cómo pensar sobre los problemas. Los modelos clásicos de optimización determinista que siguen el formato de las ecuaciones $\eqref{eq:linearprogram1}$–$\eqref{eq:linearprogram3}$ ignoran por completo todo lo relacionado con la evolución de nuestro problema a lo largo del tiempo.
Este libro está diseñado enteramente alrededor de un enfoque de modelado llamado el marco de modelado universal. En pocas palabras, aspira a representar cualquier aspecto de un sistema controlable. Nuestro modelo predeterminado asumirá que el sistema evoluciona con el tiempo, a medida que llega nueva información.
En esta sección, vamos a proporcionar una versión muy compacta del marco de modelado universal. Luego vamos a ilustrar el marco, inicialmente usando un problema de inventario muy simple, pero luego introduciendo algunas extensiones modestas. Después de presentar estos ejemplos, vamos a regresar a una presentación más detallada del marco de modelado universal.
Una presentación compacta de un modelo dinámico
Comenzamos observando que podemos modelar cualquier problema de decisión secuencial usando la secuencia
\[(S_0,x_0,W_1,S_1,x_1,W_2, \ldots, S_t, x_t, W_{t+1}, \ldots, S_T),\]donde:
- $S_t$ son las variables de estado que capturan todo lo que necesitamos para:
- a) Tomar una decisión en el tiempo $t$.
- b) Calcular las métricas de desempeño en el tiempo $t$.
- c) Cualquier otra información necesaria para calcular (a) o (b) en cualquier momento futuro.
Es mejor pensar en $S_t$ como el estado de información o, más generalmente, el estado de conocimiento, en el tiempo $t$.
- $x_t$ representa las variables de decisión que capturan los elementos que controlamos, como si vender una casa, la ruta a través de una red, la elección del medicamento para un tratamiento, el precio al que se vende un producto, o la elección del camión para transportar una carga de mercancía.
-
$W_{t+1}$ es la información que llega después de que tomamos la decisión $x_t$, que podría ser el precio final de venta de una casa, los tiempos de viaje a través de una red, cómo responde un paciente a un medicamento, las ventas de un producto a un precio determinado, y las cargas de mercancía que se solicitan después de que hacemos las asignaciones iniciales. Consideramos que la información en $W_{t+1}$ proviene de fuera de nuestro sistema, lo que significa que está fuera de nuestro control. Por esta razón, nos referimos a ella como información exógena.
Hay muchos contextos en los que es mejor pensar en $W_{t+1}$ como una función $W_{t+1}(S_t,x_t)$ que depende del estado actual $S_t$ y/o de la decisión $x_t$. Discutimos esto con más detalle a continuación. Vamos a usar $W_{t+1}$ como nuestra notación predeterminada, pero con el entendimiento de que puede estar influenciada por el estado $S_t$ o la decisión $x_t$.
La decisión $x_t$ es determinada por algún método al que nos referimos como política, que denotamos $X^\pi(S_t)$. La notación $\pi$ lleva información sobre la estructura de la función, que representamos mediante $f$ en un conjunto de funciones potenciales $\Fcal$, y cualesquiera parámetros ajustables $\theta\in\Theta^f$, que quedan definidos por la estructura de la función. Por ejemplo, una política de inventario podría consistir en ordenar $\theta^{order}$ unidades cada vez que el inventario cae por debajo de $\theta^{min}$, lo que significa que los parámetros ajustables son $\theta = (\theta^{order}, \theta^{min})$. La estructura de la función sería un ejemplo de una función $f$.
Suponemos que contamos con una función de transición que toma como entrada el estado $S_t$, la decisión $x_t$, y la información exógena $W_{t+1}$, y nos entrega el estado actualizado $S_{t+1}$. Las funciones de transición son un conjunto de ecuaciones que actualizan cada elemento de la variable de estado $S_t$, que podría tener un solo elemento, o decenas de miles (o mucho más).
Incurrimos en una contribución (o costo) $C(S_t,x_t)$ cuando tomamos la decisión $x_t=X^\pi(S_t)$ dada la información en el estado $S_t$. Nuestro objetivo es encontrar la política que maximice alguna función objetivo que dependa de las contribuciones $C(S_t,x_t)$ donde $x_t=X^\pi(S_t)$. Para configuraciones más complejas, $C(S_t,x_t)$ puede ser en realidad un conjunto de métricas de desempeño, aunque necesitaremos combinarlas de alguna manera para identificar qué decisión $x_t$ elegir.
Esta es una descripción muy compacta de un problema de decisión secuencial. A continuación describimos un conjunto de pasos a seguir en el proceso de modelado.
Los pasos en el proceso de modelado
Es posible dividir todo el proceso de modelado en siete pasos (para nuestros propósitos). Antes de estos pasos (etiquetado a continuación como “Paso 0”) hay un breve resumen de la complejidad técnica de la aplicación para orientar a los lectores.
Paso 0. Resumen del capítulo – Abrimos cada capítulo con un resumen de lo que este va a cubrir y, en algunos casos, cómo se relaciona con el material de otros capítulos. Los resúmenes indican qué enfoques se usan para modelar la incertidumbre y las políticas que se emplean.
Paso 1. La narrativa – Esta será una descripción del problema en inglés sencillo. La narrativa no proporcionará toda la información necesaria para crear un modelo matemático; más bien, es un primer paso que debería darle al modelador el panorama general sin perderse en la notación.
Paso 2. Enmarcando el problema – Esto consiste en responder tres preguntas:
- ¿Cuáles son las métricas de desempeño?
- ¿Qué tipos de decisiones se están tomando (y en algunos casos, qué agente las está tomando)?
- ¿Cuáles son las fuentes de incertidumbre que afectan el desempeño?
Paso 3. Identificando los elementos centrales del problema, con especial énfasis en tres dimensiones de cualquier problema de decisión secuencial. Estos elementos se describen sin usar matemáticas:
- ¿Qué métricas estamos tratando de impactar? Los campos individuales (como la gestión de la cadena de suministro, salud, energía, finanzas) se caracterizarán cada uno por una serie de métricas que podrían describirse usando términos como costos, ingresos, ganancias, recompensas, beneficios, pérdidas, desempeño y riesgo.
- ¿Qué decisiones se están tomando? Identificar las decisiones es bastante fácil para muchos problemas como los videojuegos, pero si abordamos un problema complejo como responder a un proceso de salud pública, reducir la huella de carbono, o gestionar una cadena de suministro, entonces identificar todas las decisiones puede ser bastante desafiante.
- ¿Cuáles son las diferentes fuentes de incertidumbre? ¿Sobre qué somos inciertos antes de empezar? ¿Qué información llega de forma exógena a lo largo del tiempo (es decir, llega después de que tomamos una decisión)? La Tabla 1.2 ilustra diferentes fuentes de incertidumbre para un modelo de la distribución de vacunas COVID (véase RLSO, Capítulo 10, para una presentación de 12 clases de incertidumbre).
Nos referimos al proceso de responder estas tres preguntas como enmarcar el problema.
| Tipo de incertidumbre | Descripción |
|---|---|
| 1) Errores de observación | Observar personas con síntomas; errores al clasificar a personas con síntomas como portadoras de COVID |
| 2) Incertidumbre exógena | Reportes de nuevos casos, muertes; disponibilidad de UCIs; producción real de vacunas |
| 3) Incertidumbre pronóstica | Ingresos hospitalarios; desempeño futuro de las vacunas; respuesta de la población a las vacunas |
| 4) Incertidumbre inferencial | Estimaciones de tasas de infección; estimaciones de la efectividad de las vacunas |
| 5) Incertidumbre experimental | Desempeño de fármacos en un ensayo clínico; número de personas vacunadas |
| 6) Incertidumbre del modelo | Tasas de transmisión de la enfermedad; propagación geográfica de las infecciones |
| 7) Incertidumbre transicional | Adiciones/retiros a/de los inventarios de vacunas |
| 8) Incertidumbre de control | Qué grupos de población fueron vacunados; asignaciones de vacunas |
| 9) Incertidumbre de implementación | Fallas en la vacunación |
| 10) Errores de comunicación | Errores de reporte desde el terreno; falla en notificar cuándo vacunarse |
| 11) Incertidumbre de objetivos | Desacuerdos sobre quién debería ser vacunado |
| 12) Incertidumbre ambiental | Si/cuándo se aprobará una vacuna; asignación de vacunas a diferentes estados, países |
Tabla 1.2. Ilustración de diferentes tipos de incertidumbre que surgen en la respuesta de vacunación a la pandemia de COVID.
Paso 4. El modelo matemático – Aquí construimos sobre los primeros tres elementos del Paso 2, pero ahora tenemos que crear un modelo matemático que consista de cinco dimensiones que aplican a todo problema de decisión secuencial:
- Variables de estado $S_t$ – La variable de estado captura todo lo que necesitas saber en el momento $t$ para tomar una decisión en el momento $t$, calcular costos y restricciones, y si es necesario, simular tu camino hasta el momento $t+1$. Las variables de estado pueden incluir información sobre recursos físicos (inventarios o la ubicación de un vehículo que entran al problema a través de restricciones), otra información (como costos o precios que entran a la función objetivo), y creencias sobre cantidades y parámetros que no conocemos perfectamente (como pronósticos o estimaciones de cómo respondería un paciente a un fármaco).
-
Variables de decisión $x_t$ – Estas describen cómo vamos a diseñar o controlar nuestro sistema. Las decisiones tienen que satisfacer restricciones que escribimos como $x_t \in \Xcal$ donde $\Xcal$ podría ser un conjunto de opciones discretas, o un conjunto de ecuaciones lineales. Las decisiones serán determinadas por políticas que son funciones (o reglas) que designamos por $X^\pi(S_t)$ que determinan $x_t$ dado lo que contiene la variable de estado. Las políticas pueden ser muy simples (comprar barato, vender caro) o bastante complejas.
El índice $\pi$ lleva información sobre el tipo de función que se usa para tomar decisiones, y cualesquiera parámetros ajustables. Sea $f\in\Fcal$ la estructura de la función, $\Fcal$ el conjunto de funciones posibles, y sea $\theta\in\Theta^f$ cualesquiera parámetros ajustables para la función $f$. Nuestra política se representaría entonces como $\pi = (f,\theta)$. A menudo escribiremos la política como $X^\pi(S_t\vert \theta)$ para indicar la dependencia de los parámetros ajustables.
Volveremos a esto con considerable detalle más adelante en este capítulo, y a lo largo del libro. Cada uno de los ejemplos dados en el libro ha sido elegido para ayudar a ilustrar tipos específicos de políticas.
- Información exógena $W_{t+1}$ – Esta es información nueva que llega después de que tomamos la decisión $x_t$ (pero antes de que decidamos $x_{t+1}$) tal como cuánto vendemos después de fijar un precio, o el tiempo para completar la ruta que elegimos. Cuando tomamos una decisión en el momento $t$, la información en $W_{t+1}$ es desconocida, por lo que la tratamos como una variable aleatoria cuando estamos eligiendo $x_t$.
- La función de transición $S^M(S_t,x_t,W_{t+1})$ – Estas son las ecuaciones que describen cómo evolucionan las variables de estado a lo largo del tiempo. Para muchos problemas reales, las funciones de transición capturan toda la dinámica del problema, y pueden ser bastante complejas. En algunos casos, ni siquiera conocemos las ecuaciones, y debemos depender únicamente de las variables de estado que podemos observar. Escribimos la evolución de las variables de estado $S_t$ usando nuestra función de transición como
donde $S^M(\cdot)$ se conoce como el modelo de transición de estado (o del sistema) (de ahí el $M$ en el superíndice). La función de transición describe cómo cambia cada elemento de la variable de estado dadas las decisiones $x_t$ y la información exógena $W_{t+1}$. En problemas complejos, la función de transición puede requerir miles de líneas de código para implementarse.
-
La función objetivo – Esta captura las métricas de desempeño que usamos para evaluar nuestro rendimiento, y proporciona la base para buscar entre políticas. Sea $C(S_t,x_t)$ la contribución (si maximizamos) o costo (si minimizamos) de la decisión $x_t$ que puede depender de la información en $S_t$. En algunas configuraciones es más natural escribir la función de contribución de un solo período como $C(S_t,x_t,W_{t+1})$, la función de contribución evaluada al final del intervalo de tiempo $(t,t+1)$, después de que $W_{t+1}$ ha sido observado. Por ejemplo, podríamos hacer un pedido de $x_t$ que llega de inmediato para satisfacer la demanda incierta contenida en $W_{t+1}$.
Nuestro objetivo es encontrar la mejor política $X^\pi(S_t)$ para optimizar alguna métrica tal como:
- Maximizar la suma esperada de las contribuciones sobre algún horizonte.
- Maximizar el desempeño esperado de un diseño final que aprendimos a lo largo de una serie de experimentos u observaciones.
- Minimizar el riesgo asociado con un diseño final.
Nuestra forma más común de escribir la función objetivo es
donde “$\E$” se llama el operador de esperanza, lo que significa que está tomando un promedio sobre cualquier cosa aleatoria, lo que podría incluir información incierta en el estado inicial $S_0$, así como el proceso de información exógena $W_1, \ldots, W_T$. Es estándar escribir el operador de esperanza, pero nunca podemos realmente calcularlo. Más adelante mostramos cómo aproximarlo ejecutando una serie de simulaciones y tomando un promedio, u observando un proceso en el campo.
Se debe tener precaución al interpretar el operador de esperanza “$\E$” en la ecuación $\eqref{eq:baseobjectivefunction}$. Lo que este operador literalmente significa es “tomar un promedio sobre cualquier cosa que sea incierta.” La pieza de incertidumbre más obvia es el proceso de información exógena $W_1, W_2, \ldots, W_t, \ldots, W_T$.
La transición del problema real (guiada por la narrativa) a los elementos del modelo matemático es quizás el paso más difícil, ya que a menudo implica solicitar información de una fuente no técnica.
Notamos que hemos presentado todo el modelo sin especificar cómo tomamos decisiones, lo cual está representado por la política $X^\pi(S_t)$. Llamamos a esto “primero el modelo, después la solución” y representa una desviación importante de la vasta literatura que trata sobre problemas de decisión secuencial. Es difícil comunicar cuán importante es abordar los problemas de decisión secuencial de esta manera.
Paso 5. El modelo de incertidumbre – Esta es la forma en que modelamos los diferentes tipos de incertidumbre. Hay dos maneras de introducir la incertidumbre en nuestro modelo:
- A través del estado inicial $S_0$ que podría especificar una distribución de probabilidad para parámetros inciertos tales como cómo podría responder un paciente a un fármaco o cómo podría responder el mercado al precio.
- A través del proceso de información exógena $W_1, \ldots, W_T$.
Tenemos tres maneras de modelar el proceso de información exógena:
- Crear un modelo matemático de $W_1, W_2, \ldots, W_T$.
- Usar observaciones históricas, tales como precios pasados, ventas, o eventos climáticos.
- Ejecutar el sistema en el campo, observando $W_t$ a medida que ocurren.
Paso 6. Diseñando políticas – Las políticas son funciones, así que tenemos que buscar la mejor función. (¡Sí, las políticas son funciones para elegir la mejor decisión, pero elegir la política también es una decisión!) Hacemos esto identificando dos estrategias centrales para diseñar políticas:
- Buscar entre una familia de funciones para encontrar la que funcione mejor, en promedio, a lo largo del tiempo.
- Crear una política estimando el costo o contribución inmediato de una decisión $x_t$, más una aproximación de los costos o contribuciones futuros, y luego encontrando la elección $x_t$ que optimiza la suma de los costos o contribuciones actuales y futuros. Google Maps decide si girar a la izquierda o a la derecha optimizando sobre el tiempo requerido para atravesar el siguiente enlace en la red más el tiempo restante para llegar al destino. Una decisión de inventario podría optimizar sobre el costo de un pedido más el valor estimado de mantener cierta cantidad de inventario hacia adelante.
Vamos a ser mucho más explícitos sobre cómo identificar estas políticas. Una sección posterior describe cuatro clases de políticas que incluirán cualquier método para tomar decisiones (estas son meta-clases).
Paso 7. Evaluación de políticas – Encontrar la mejor política significa evaluar políticas para determinar cuál es la mejor. Hay dos maneras de evaluar una política:
- Probar la política en un simulador de computadora. Esto requiere programar todas las ecuaciones en el modelo de transición de estado $S^M(S_t,x_t,W_{t+1})$ necesario para actualizar la variable de estado $S_t$. También significa poder generar muestras de $W_{t+1}$, lo cual es a menudo el aspecto más sutil de un simulador.
- Observar cómo funciona la política en el campo.
Los simuladores pueden ser complejos y difíciles de construir, y aún están sujetos a aproximaciones de modelado. Por esta razón, la gran mayoría de los problemas prácticos que se encuentran en la práctica tienden a implicar pruebas en el campo, lo cual es lento (toma un día simular un día) y requiere convivir con los resultados de los experimentos.
La única manera de sentirse cómodo con un modelo matemático es verlo ilustrado usando un ejemplo familiar. Comenzamos con un problema universal que todos encontramos en la vida cotidiana: la gestión de inventarios.
Algunos problemas de inventario
Vamos a ilustrar nuestro marco de modelado usando dos variaciones de un problema clásico de inventario, que es ampliamente usado como aplicación para ilustrar ciertos métodos para resolver problemas de decisión secuencial. Comenzamos con un ejemplo simple de inventario que transmite los elementos centrales de nuestro marco de modelado, pero nos permite ignorar muchas de las complejidades que estaremos explorando en el resto del libro.
Luego, vamos a transicionar hacia un problema de inventario ligeramente más complicado que nos permitirá ilustrar algunos principios de modelado. A lo largo del libro, también vamos a usar la idea de comenzar con una versión básica de un problema, y luego introducir extensiones que insinúan los tipos de complicaciones que pueden surgir en aplicaciones reales.
Un problema simple de inventario
Uno de los problemas de decisión secuencial más familiares que todos experimentamos cada vez que visitamos una tienda es un problema de inventario. Vamos a usar una versión simple de este problema para ilustrar los seis pasos de nuestro proceso de modelado que introdujimos anteriormente:
Paso 1: Narrativa – Un restaurante de pizza tiene que decidir cuántas libras de salchicha ordenar de su distribuidor de alimentos. El restaurante tiene que tomar la decisión al final del día $t$, comunicar el pedido que luego llega la mañana siguiente para satisfacer los pedidos de mañana. Si sobra salchicha, se puede conservar para el día siguiente. El costo de la salchicha, y el precio al que se venderá al día siguiente, se conocen de antemano, pero la demanda no.
Paso 2: Los elementos centrales del problema son:
- Métricas – Queremos maximizar las ganancias dadas por las ventas de salchicha menos el costo de comprar la salchicha.
- Decisiones – Tenemos que decidir cuánto ordenar al final de un día, llegando al comienzo del siguiente.
- Fuentes de incertidumbre – La única fuente de incertidumbre en este modelo simple es la demanda de salchicha al día siguiente.
Paso 3: El modelo matemático – Este consiste en cinco elementos.
1) La variable de estado $S_t$ – Distinguimos entre la variable de estado inicial $S_0$, y la variable de estado dinámica $S_t$ para $t > 0$. La variable de estado inicial $S_0$ consiste en parámetros fijos y valores iniciales de variables que cambian con el tiempo, dándonos
\[S_0 = (R^{inv}_0, (p, c), (\Dbar, \sigmabar^D)).\]Hemos dividido el estado inicial en tres tipos de variables:
- Valores iniciales del estado del recurso $R^{inv}_0$.
- Valores de parámetros constantes $c$ y $p$.
- Nuestra creencia sobre las demandas, dada por una distribución normal con media $\Dbar$ y desviación estándar $\sigmabar^D$.
La variable de estado dinámica $S_t$ es nuestro inventario que vamos a llamar $R^{inv}_t$. Por ahora, este es el único elemento de la variable de estado dinámica, así que
\[S_t = R^{inv}_t.\]Más adelante vamos a introducir elementos adicionales a nuestra variable de estado.
2) La variable de decisión $x_t$ es cuánto ordenamos en el tiempo $t$, que asumimos (por ahora) llega de inmediato. Tomamos nuestras decisiones con una política $X^\pi(S_t)$ que diseñamos más adelante.
3) La información exógena es la demanda aleatoria de nuestro producto que vamos a denotar $\Dhat_{t+1}$, así que $W_{t+1} = \Dhat_{t+1}$.
4) Nuestra función de transición captura cómo evoluciona el inventario $R_t$ a lo largo del tiempo, la cual está dada por
\[\begin{align} R^{inv}_{t+1} = \max\{0, R^{inv}_t+x_t-\Dhat_{t+1}\}. \label{eq:inventoryexampleequation} \end{align}\]5) Nuestra función objetivo. Para nuestro problema de inventario, es más natural calcular la contribución incluyendo el costo de compra del producto $x_t$ y el ingreso por satisfacer la demanda $\Dhat_{t+1}$, lo que significa que nuestra función de contribución de un solo período se escribiría
\[C(S_t,x_t,\Dhat_{t+1}) = -cx_t + p \min\{R^{inv}_t+x_t, \Dhat_{t+1}\},\]donde $x_t = X^\pi(S_t)$. Dada una secuencia de demandas $\Dhat_1, \ldots, \Dhat_T$, el valor de una política $\Fhat^\pi$ sería
\[\Fhat^\pi(S_0) = \sum_{t=0}^T C(S_t,X^\pi(S_t),\Dhat_{t+1}).\]Nuestras ganancias $\Fhat^\pi(S_0)$ son aleatorias porque dependen de una secuencia particular de demandas aleatorias $\Dhat_1, \ldots, \Dhat_T$. Finalmente promediamos sobre estas demandas aleatorias tomando la esperanza:
\[\begin{align} F^\pi(S_0) = \E \left\{\sum_{t=0}^T C(S_t,X^\pi(S_t),\Dhat_{t+1})\vert S_0\right\}. \label{eq:inventoryobjective} \end{align}\]Aquí, el condicionamiento en el estado inicial $S_0$ puede leerse como diciendo “tomar la esperanza dado lo que sabemos inicialmente.” El condicionamiento en $S_0$ es implícito cada vez que tomamos una esperanza, y como resultado muchos autores lo omiten. Sin embargo, vamos a incluir el condicionamiento en $S_0$ para dejar claro que si nuestras entradas iniciales (incluyendo creencias) cambian, esto puede tener un efecto en cómo se desempeña una política.
Paso 4. El modelo de incertidumbre – El enfoque más simple para modelar la incertidumbre es simplemente usar datos históricos. El problema que podríamos encontrar es que si nos quedamos sin salchicha, podríamos no observar la demanda completa de salchicha ese día. Si somos capaces de capturar esta demanda perdida, entonces este es un enfoque razonable.
Una alternativa es construir un modelo matemático. Podríamos asumir que nuestra demanda se distribuye normalmente con alguna media $\Dbar$ y desviación estándar $\sigmabar^D$. Si asumimos que ambas son conocidas, podemos escribir nuestra demanda como
\[\Dhat_{t+1} \sim N(\Dbar,(\sigmabar^D)^2),\]y aprovechar paquetes que puedan muestrear de la distribución normal (por ejemplo, en Excel esto se llama Norm.inv$(Rand(),\Dbar,\sigmabar)$ para generar una observación aleatoria con media $\Dbar$ y desviación estándar $\sigmabar$.
Usando este modelo, podemos crear un conjunto de demandas $(\Dhat_1, \Dhat_2, \ldots, \Dhat_T)$. Luego, podemos repetir esto $N$ veces para crear $N$ secuencias de $T$ demandas, dándonos la secuencia $(\Dhat^n_1, \Dhat^n_2, \ldots, \Dhat^n_T)$ para $n=1, \ldots, N$ que necesitamos para estimar el valor de la política (usamos esto más abajo en el Paso 6).
Paso 5. Diseño de políticas – A continuación tenemos que diseñar un método para determinar nuestros pedidos. Una estrategia comúnmente usada para problemas de inventario se conoce como una política de “pedir hasta” que se ve así
\[\begin{align} X^\pi(S_t\vert \theta) = \begin{cases} \theta^{max} - R_t & \text{if } R_t < \theta^{min}, \\ 0 & \text{otherwise,}\end{cases} \label{eq:introorderupto} \end{align}\]donde $\theta = (\theta^{min},\theta^{max})$ es un conjunto de parámetros que necesitan ser ajustados. Se llama “pedir hasta” ya que colocamos un pedido para llevar el inventario “hasta” el límite superior $\theta^{max}$.
Paso 6. Evaluación de políticas – Hay una variedad de estrategias que podríamos usar. En la práctica, no podemos calcular la esperanza en la función objetivo en la ecuación $\eqref{eq:inventoryobjective}$, así que tomamos una serie de muestras de demandas. Sea $\Dhat^n_1, \ldots, \Dhat^n_T$ una muestra de demandas sobre $t=1, \ldots, T$, y asumamos que podemos generar $N$ de estas. Ahora podemos estimar nuestras ganancias esperadas de la política $X^\pi(S_t)$ promediando sobre las muestras para $n=1, \ldots, N$, lo cual se calcula usando
\[\Fbar^\pi(\theta\vert S_0) = \frac{1}{N} \sum_{n=1}^N \sum_{t=0}^T C(S_t,X^\pi(S_t\vert \theta),\Dhat^n_{t+1}).\]En términos simples, estamos simulando la política $X^\pi(S_t\vert \theta)$ $N$ veces usando las muestras simuladas (u observadas del historial) de demandas $\Dhat^n_1, \ldots, \Dhat^n_T$, y luego promediando el desempeño para obtener $\Fbar^\pi(\theta\vert S_0)$. Luego enfrentamos el problema de encontrar el mejor valor de $\theta$. Una estrategia simple sería generar $K$ valores posibles $\theta_1, \ldots, \theta_K$, simulando cada uno para encontrar $\Fbar^\pi(\theta_k\vert S_0)$ para cada $k$, y luego elegir el valor de $\theta_k$ que funcione mejor. Esta no es una estrategia óptima, pero proporciona un punto de partida simple y práctico.
Un problema ligeramente más complicado
El problema simple de inventario anterior es un escenario clásico para demostrar un método particular para resolver problemas de decisión secuencial conocido como programación dinámica, el cual depende de tener una variable de estado simple que a) sea discreta y b) no tenga demasiados valores posibles. En nuestro problema de inventario ligeramente más complicado, vamos a ilustrar tres sabores diferentes de variables de estado que representarían una complicación seria para un método popular de resolver problemas de decisión secuencial, pero no tiene efecto en la política que hemos elegido.
Paso 1: Narrativa – Nuevamente tenemos nuestro restaurante de pizza que tiene que ordenar salchicha, pero vamos a permitir que el precio que pagamos por la salchicha varíe de un día a otro, donde asumimos que el precio en un día es independiente del precio en el día anterior. Luego, también vamos a asumir que aunque la demanda de salchicha de mañana es aleatoria, se nos dará un pronóstico de la demanda de mañana que, aunque no es perfecto, es mejor que no tener un pronóstico. De lo contrario, todo sobre nuestro problema más complicado es igual a como era antes.
Paso 2: Elementos centrales – Estos son:
- Métricas – Queremos maximizar las ganancias dadas por las ventas de salchicha menos el costo de comprar la salchicha, donde el costo varía de un día a otro.
- Decisiones – Al igual que con nuestro problema de inventario más simple, tenemos que decidir cuánto ordenar al final de un día, llegando al comienzo del siguiente.
- Fuentes de incertidumbre – Ahora hay tres fuentes de incertidumbre: la diferencia entre la demanda real y el pronóstico, la evolución de los pronósticos de un día al siguiente, y el precio que pagamos por la salchicha.
Paso 3: Modelo matemático – Todavía tenemos los mismos cinco elementos, pero ahora el problema es un poco más rico:
1) Para construir la variable de estado, necesitamos listar la información (específicamente, información que evoluciona con el tiempo) que se necesita en tres partes diferentes del modelo: (1) la función objetivo, (2) la política para tomar decisiones (que incluye las restricciones), y (3) la función de transición. Por supuesto, aún no hemos introducido ninguna de estas funciones, así que tienes que leer hacia adelante, y verificar que nuestra variable de estado contenga toda la información necesaria para calcular cada una de estas funciones. Piensa en esto como un diccionario de la información que necesitaremos.
Comenzamos con el estado inicial $S_0$ que consiste en parámetros constantes, y valores iniciales de cantidades y parámetros que cambian con el tiempo. Estos son:
- Inventario inicial – Comenzamos con un inventario inicial $R_0$.
- Costo de compra inicial – $c_0$.
- Precio – Asumimos que vendemos nuestra salchicha a un precio fijo $p$.
- Pronóstico inicial – Asumimos que nuestro primer pronóstico $f^D_{0,1}$ está dado, donde $f^D_{0,1}$ es el pronóstico conocido en el tiempo 0 para la demanda en el tiempo 1.
- Estimación inicial de la desviación estándar de la demanda – $\sigmabar^D_0$.
- Estimación inicial de la desviación estándar del pronóstico – $\sigmabar^f_0$.
Esto significa que nuestra variable de estado inicial es
\[S_0 = (R_0,c_0, p, f^D_{0,1}, \sigmabar^D_0, \sigmabar^f_0).\]Luego tenemos la información que evoluciona con el tiempo que compone nuestra variable de estado dinámica $S_t$:
- Inventario actual $R^{inv}_t$ – El inventario para el comienzo del intervalo de tiempo $(t,t+1)$.
- Costo de compra $c_t$ – Este es el costo de la salchicha comprada en el tiempo $t$ que se nos da en el tiempo $t$.
- Pronóstico de demanda $f^D_{t,t+1}$ – Este es el pronóstico de $\Dhat_{t+1}$ dado lo que sabemos en el tiempo $t$.
- Estimación actual de la desviación estándar de la demanda – $\sigmabar^D_t$.
- Estimación actual de la desviación estándar del pronóstico – $\sigmabar^f_t$.
Nuestra variable de estado dinámica está entonces dada por
\[S_t = (R^{inv}_t, c_t, f^D_{t,t+1}, \sigmabar^D_t, \sigmabar^f_t).\]2) La variable de decisión $x_t$ es cuánto pedimos en el tiempo $t$, lo cual asumimos (por ahora) que llega de inmediato. Tomamos nuestras decisiones con una política $X^\pi(S_t)$ que diseñamos más adelante.
3) La información exógena ahora consiste en:
- Costos de compra $\chat_{t+1}$ – Este es el costo de compra de la salchicha en el día $t+1$, el cual se especifica exógenamente.
- Pronósticos – En cada periodo se nos da un nuevo pronóstico. Sea $\varepsilon^f_{t+1}$ el cambio en el pronóstico entre el tiempo $t$ y $t+1$.
- Demandas – Finalmente, asumimos que la demanda real es una desviación aleatoria respecto del pronóstico, la cual podríamos escribir
Nuestro conjunto completo de variables de información exógena ahora puede escribirse
\[W_{t+1} = \big(\chat_{t+1}, \varepsilon^f_{t+1}, \varepsilon^D_{t+1}\big).\]4) Función de transición – Esto especifica cómo evoluciona en el tiempo cada una de las variables de estado (dinámicas) $S_t$. Actualizamos nuestro inventario usando:
\[\begin{align} R^{inv}_{t+1} &= \max\{0, R^{inv}_t + x_t - \Dhat_{t+1}\}. \label{eq:introcomplexinventorytransition1} \end{align}\]La demanda es la demanda pronosticada más la desviación $\varepsilon^D_{t+1}$ respecto del pronóstico, lo que nos da la ecuación:
\[\begin{align} \Dhat_{t+1} &= f^D_{t,t+1} + \varepsilon^D_{t+1}. \label{eq:introcomplexinventorytransition2} \end{align}\]Asumimos que nuestro pronóstico se actualiza usando
\[\begin{align} f^D_{t+1,t+2} &= f^D_{t,t+1} + \varepsilon^f_{t+1}. \label{eq:introcomplexinventorytransition3} \end{align}\]A continuación, vamos a estimar de manera adaptativa la varianza en la demanda y en el pronóstico de demanda:
\[\begin{align} (\sigmabar^D_{t+1})^2 &= (1-\alpha)(\sigmabar^D_t)^2 + \alpha (f^D_{t,t+1} - \Dhat_{t+1})^2, \label{eq:introcomplexinventorytransition4}\\ (\sigmabar^f_{t+1})^2 &= (1-\alpha)(\sigmabar^f_t)^2 + \alpha (f^D_{t,t+1} - f^D_{t+1,t+2})^2, \label{eq:introcomplexinventorytransition5} \end{align}\]donde $0 < \alpha < 1$ es un factor de suavizamiento.
Finalmente, actualizamos el costo $c_{t+1}$ con el “costo observado” $\chat_{t+1}$, el cual escribimos simplemente como
\[\begin{align} c_{t+1} = \chat_{t+1}.\label{eq:introcomplexinventorytransition6} \end{align}\]La ecuación $\eqref{eq:introcomplexinventorytransition6}$ es un ejemplo de una variable de estado que observamos en lugar de calcular, como hicimos con el inventario $R^{inv}_t$ en $\eqref{eq:introcomplexinventorytransition1}$. La ecuación $\eqref{eq:introcomplexinventorytransition1}$ a veces se denomina “basada en modelo,” ya que refleja la física de cómo se actualizan los inventarios, mientras que la ecuación $\eqref{eq:introcomplexinventorytransition6}$ se denomina “libre de modelo,” ya que no hacemos ningún intento por modelar el proceso subyacente que produce el cambio en los costos.
Nuestra función de transición $S_{t+1} = S^M(S_t,x_t,W_{t+1})$ consiste en las ecuaciones $\eqref{eq:introcomplexinventorytransition1}$–$\eqref{eq:introcomplexinventorytransition6}$.
5) Finalmente, nuestra función de contribución de un solo periodo ahora se escribiría
\[C(S_t,x_t,\Dhat_{t+1}) = -c_tx_t + p \min\{R_t+x_t, \Dhat_{t+1}\},\]donde la única diferencia con el problema de inventario más simple es que el costo $c$ ahora depende del tiempo $c_t$. Nos apartamos de nuestra convención de escribir la contribución como $C(S_t,x_t)$ y permitimos que incluya ingresos provenientes de las demandas $\Dhat_{t+1}$.
Ahora enunciamos formalmente nuestra función objetivo como
\[\begin{align} \max_{\pi=(f,\theta)} \E \left\{\sum_{t=0}^T C(S_t,X^\pi(S_t\vert \theta),\Dhat_{t+1})\vert S_0\right\}. \label{eq:introcomplexinventoryobjective} \end{align}\]La optimización $\max_\pi$ significa que estamos buscando entre todas las políticas posibles representadas por $(f,\theta)$, lo cual literalmente significa buscar entre las distintas funciones que podríamos usar para tomar una decisión. Los ejemplos de este libro van a demostrar cómo vamos a buscar entre funciones.
Recuerde que arriba establecimos que el índice $\pi$ lleva información sobre el tipo de función $f\in\Fcal$, y cualquier parámetro ajustable $\theta\in\Theta^f$. En la práctica, la búsqueda entre los tipos de funciones $f\in\Fcal$ tiende a ser ad hoc (un analista con conocimiento elige funciones que tienen sentido para un problema), mientras que un algoritmo de computadora realiza la búsqueda del mejor valor de $\theta\in\Theta^f$.
Paso 4. El modelo de incertidumbre – Vamos a asumir que los cambios exógenos $\varepsilon^D_{t+1}$ y $\varepsilon^f_{t+1}$ se describen mediante distribuciones normales con media 0 y varianzas $(\sigmabar^D_t)^2$ y $(\sigmabar^f_t)^2$, lo cual expresamos escribiendo
\[\varepsilon^D_t \sim N(0, (\sigmabar^D_t)^2), \quad \varepsilon^f_t \sim N(0, (\sigmabar^f_t)^2).\]Los modelos de incertidumbre pueden llegar a ser bastante complejos, pero este servirá como ilustración.
Paso 5. Diseño de políticas – A continuación tenemos que diseñar un método para determinar nuestros pedidos. En lugar de la política de pedido hasta un nivel de nuestro modelo más simple, vamos a sugerir la idea de pedir lo suficiente para satisfacer la demanda esperada de mañana, con un ajuste. Podríamos escribir esto como
\[\begin{align} X^\pi(S_t\vert \theta) = \max\{0,f^D_{t,t+1}-R_t\} + \theta. \label{eq:adjustedforecastpolicy} \end{align}\]Si tuviéramos un pronóstico perfecto, entonces todo lo que tendríamos que pedir sería $f^D_{t,t+1}$ (nuestro pronóstico de $\Dhat_{t+1}$) menos el inventario disponible. Sin embargo, debido a la incertidumbre vamos a agregar un ajuste $\theta$ para tener algo de margen y evitar desabastecimientos.
Paso 6. Evaluación de políticas – Esta vez tenemos que generar muestras de todas las variables aleatorias en la secuencia $W_1, W_2, \ldots, W_T$. Nuevamente, podríamos generar $N$ muestras de la secuencia completa para poder estimar el desempeño de una política usando
\[\Fbar^\pi(\theta) = \frac{1}{N} \sum_{n=1}^N \sum_{t=0}^T C(S_t,X^\pi(S_t\vert \theta),\Dhat^n_{t+1}).\]Nuevamente nos enfrentamos al problema de encontrar el mejor valor de $\theta$, pero volveremos a ese desafío más adelante.
El marco de modelado universal
Ahora estamos listos para describir con más detalle los elementos del marco de modelado universal (UMF, por sus siglas en inglés). Observamos que el UMF puede modelar cualquier problema de decisión secuencial. Esta afirmación bastante amplia se hará evidente conforme los elementos se desarrollen, ya que simplemente estamos aplicando notación a la formulación general de un problema de decisión secuencial.
Los cinco elementos del UMF
El UMF consiste en los siguientes elementos:
- Las variables de estado $S_t$.
- Las variables de decisión $x_t$.
- El proceso de información exógena $W_t$.
- El modelo de transición de estado $S^M(S_t,x_t,W_{t+1})$.
- La función objetivo.
Describimos estos con más detalle a continuación:
Variables de estado – El estado $S_t$ del sistema en el tiempo $t$ contiene toda la información necesaria y suficiente para modelar nuestro sistema desde el tiempo $t$ en adelante. Más específicamente, esta información consiste en:
- a) La información necesaria para tomar una decisión en el tiempo $t$.
- b) La información necesaria para calcular las métricas de desempeño en el tiempo $t$.
- c) Cualquier información necesaria ahora para calcular (a) y (b) en el futuro.
Hay tres tipos de información en $S_t$:
- El estado físico, $R_t$, captura cantidades físicas como inventarios, personas, máquinas disponibles, instalaciones, agua, medicamentos, energía y dinero (en sus diversas formas). $R_t$ también incluirá las solicitudes de los clientes por productos o servicios. En muchas aplicaciones $R_t$ describe el recurso que se está gestionando, y un error bastante común es equiparar “estado” con “estado físico.”
- El estado de información, $I_t$, que contiene las funciones que se están utilizando (cuando hay una elección) y cualquier parámetro ajustable. $I_t$ podría especificar cómo estamos pronosticando las demandas, y los parámetros usados para ajustar el pronóstico, además de cualquier otro parámetro que controle la evolución del sistema.
- El estado de creencia, $B_t$, que contiene estimaciones o creencias sobre cantidades y parámetros que no se conocen perfectamente. Así, $B_t$ podría capturar la media y la varianza estimadas de una distribución normal (como con nuestro pronóstico de demanda anterior). Alternativamente, podría ser un vector de probabilidades que evolucionan en el tiempo.
El estado físico $R_t$ podría ser la cantidad de dinero en una cuenta de efectivo, mientras que $I_t$ podría ser el estado actual de los mercados de acciones y bonos. Si estamos viajando por una red dinámica, $R_t$ podría ser nuestra ubicación en la red, mientras que $I_t$ podría ser lo que sabemos acerca de los tiempos de viaje en cada enlace. Si planificamos una ruta y luego deseamos penalizar las desviaciones respecto del plan, entonces el plan se incluiría en la variable de estado a través de $I_t$.
Las variables de estado típicamente no son obvias. Emergen durante el proceso de modelado, en lugar de ser algo que se pueda simplemente escribir de inmediato. El hecho de que la escribamos primero no significa que siempre se puedan enumerar todos los elementos de la variable de estado de inmediato. Pero al final, aquí es donde se almacena toda la información que se necesita para modelar el sistema desde el tiempo $t$ en adelante.
Variables de decisión – Diferentes comunidades usan notaciones distintas para la decisión, como $a_t$ para una acción (típicamente discreta) o $u_t$ para un control (típicamente continuo) en ingeniería. Usamos $x_t$ como nuestra opción predeterminada ya que es ampliamente utilizada por la comunidad de programación matemática.
Las variables de decisión vienen en diferentes formas:
- Binarias (por ejemplo, para modelar si vender un activo o no, o para pruebas A/B de diferentes diseños web).
- Discretas (por ejemplo, elección de medicamento, qué producto anunciar).
- Escalares continuas (precios, temperaturas, concentraciones).
- Vectores (discretos o continuos, como asignaciones de suministros de sangre entre hospitales).
- Categóricas (por ejemplo, qué características destacar en un anuncio de producto).
Observamos que hay clases de algoritmos determinadas por la naturaleza de la variable de decisión.
Asumimos que las decisiones se toman con una política, la cual podríamos denotar $X^\pi(S_t)$ si usamos $x_t$ como nuestra decisión. Asumimos que una decisión $x_t = X^\pi(S_t)$ es factible en el tiempo $t$, lo que significa $x_t \in \Xcal_t$ para algún conjunto (o región) $\Xcal_t$, que puede depender de $S_t$.
Dejamos que “$\pi$” lleve la información sobre el tipo de función $f\in\Fcal$ (por ejemplo, un modelo lineal con variables explicativas específicas), y cualquier parámetro ajustable $\theta \in \Theta^f$.
Información exógena – Dejamos que $W_{t+1}$ sea cualquier información nueva que se conoce por primera vez en el tiempo $t+1$ (es decir, entre $t$ y $t+1$), donde la fuente de la información proviene de fuera de nuestro sistema (razón por la cual es “exógena”). Al modelar variables específicas, usamos “sombreros” para indicar información exógena. Así, $\Dhat_{t+1}$ podría ser la demanda que surge entre $t$ y $t+1$, o podríamos dejar que $\phat_{t+1}$ sea el cambio en el precio entre $t$ y $t+1$.
El proceso de información exógena puede ser estacionario o no estacionario, puramente exógeno o dependiente del estado (y posiblemente de la acción) (si decidimos vender una gran cantidad de acciones, podría hacer bajar los precios).
Dejamos que $\omega$ represente una trayectoria de muestra $W_1, \ldots, W_T$, la cual representa una secuencia de resultados de cada $W_t$. A menudo, crearemos un conjunto $\Omega$ de muestras discretas, donde cada muestra representa una secuencia particular de los resultados de nuestro proceso $W_t$, la cual podríamos escribir como $W_1(\omega), \ldots, W_T(\omega)$. Si tenemos 20 trayectorias de muestra, podemos pensar en $\omega$ como un número entre 1 y 20, lo que nos permite buscar la trayectoria de muestra.
Función de transición – Denotamos la función de transición como
\[\begin{align} S_{t+1} = S^M(S_t,x_t,W_{t+1}), \label{eq:transition} \end{align}\]donde $S^M(\cdot)$ también se conoce por nombres como modelo de transición de estado, modelo de sistema, modelo de planta, ecuación de planta, ecuación de estado, y función de transferencia.
La ecuación $\eqref{eq:transition}$ es la forma clásica de una función de transición que da las ecuaciones desde el estado $S_t$ hasta el estado $S_{t+1}$. La ecuación $\eqref{eq:inventoryexampleequation}$ fue la única ecuación de transición para nuestro ejemplo simple de inventario, mientras que las ecuaciones $\eqref{eq:introcomplexinventorytransition1}$–$\eqref{eq:introcomplexinventorytransition6}$ conformaron la función de transición para nuestro ejemplo más complicado.
La función de transición podría capturar cualquiera de los siguientes tipos de actualizaciones:
- Cambios en recursos físicos tales como agregar inventario, mover personas, o modificar equipo.
- Actualizaciones a la información tales como cambios en precios y clima.
- Actualizaciones a nuestras creencias sobre cantidades o parámetros inciertos.
La función de transición puede ser un conjunto de ecuaciones conocido, o desconocido, como cuando describimos el comportamiento humano o la evolución del CO2 en la atmósfera. Cuando las ecuaciones son desconocidas, el problema a menudo se describe como “libre de modelo” o “impulsado por datos,” lo que significa que solo podemos observar cambios en una variable, en lugar de usar un modelo físico. La ecuación $\eqref{eq:introcomplexinventorytransition6}$, donde “observamos” el costo $c_{t+1} = \chat_{t+1}$, sin tener idea de cómo evolucionamos desde $c_t$, es un ejemplo de una transición libre de modelo.
Las funciones de transición pueden ser lineales, no lineales continuas o funciones escalonadas. Cuando el estado $S_t$ incluye un estado de creencia $B_t$, entonces la función de transición tiene que incluir las ecuaciones de actualización (ilustramos esto más adelante en el libro).
Dada una política $X^\pi(S_t)$, un proceso exógeno $W_{t+1}$ y una función de transición, podemos escribir nuestra secuencia de estados, decisiones e información como
\[(S_0, x_0, W_1, S_1, x_1, W_2, \ldots, x_{T-1}, W_T, S_T).\]Funciones objetivo – Hay varias maneras de escribir funciones objetivo. Una de las más comunes, que usaremos como predeterminada, maximiza las contribuciones totales esperadas a lo largo de un horizonte $t=0, \ldots, T$
\[\begin{align} \max_{\pi=(f,\theta)} F^\pi(S_0) = \E \left\{\sum_{t=0}^T C_t(S_t,X^\pi_t(S_t\vert \theta))\vert S_0\right\}, \label{eq:objectivecumulativereward} \end{align}\]donde
\[\begin{align} S_{t+1} = S^M(S_t,X^\pi_t(S_t),W_{t+1}). \label{eq:basetransition} \end{align}\]El modelo queda completamente especificado cuando también contamos con un modelo del estado inicial $S_0$, y un modelo del proceso exógeno $W_1, W_2, \ldots$. Escribimos toda la información exógena como
\[\begin{align} (S_0, W_1, W_2, \ldots, W_T). \label{eq:basestochasticmodel} \end{align}\]Las ecuaciones $\eqref{eq:objectivecumulativereward}$, $\eqref{eq:basetransition}$ y $\eqref{eq:basestochasticmodel}$ constituyen un modelo de un problema de decisión secuencial.
De aquí en adelante, por compacidad vamos a usar $\max_\pi$ para representar una búsqueda entre los tipos de funciones $f\in\Fcal$ y parámetros ajustables $\theta\in\Theta^f$.
La ecuación $\eqref{eq:objectivecumulativereward}$ usa una esperanza $\E$ que significa tomar un promedio sobre todos los resultados posibles de $W_1, \ldots, W_T$. Esto prácticamente nunca es posible de hacer computacionalmente. En su lugar, dejemos que $\omega$ represente un único resultado de la secuencia $W_1, \ldots, W_T$, la cual podríamos escribir $W_1(\omega), \ldots, W_T(\omega)$. Supongamos que podemos crear $N$ resultados posibles de esta secuencia, y dejemos que $\omega^n$ represente cómo indexamos la secuencia $n^{th}$.
Si estamos siguiendo una trayectoria muestral $\omega$, entonces reescribiríamos nuestra función de transición en $\eqref{eq:basetransition}$ utilizando
\[\begin{align} S_{t+1}(\omega) = S^M(S_t(\omega),X^\pi_t(S_t(\omega)),W_{t+1}(\omega)). \label{eq:basetransition2} \end{align}\]Indexamos cada variable en la ecuación $\eqref{eq:basetransition2}$ por $\omega$ para indicar que estamos siguiendo una única trayectoria muestral de valores de $W_t$.
Ahora podemos reemplazar nuestra función objetivo basada en la esperanza con un promedio que podemos escribir
\[\begin{align} \max_\pi \Fbar^\pi(S_0) = \frac{1}{N}\sum_{n=1}^N \sum_{t=0}^T C_t(S_t(\omega^n),X^\pi_t(S_t(\omega^n))). \label{eq:objectivecumulativerewardaverage} \end{align}\]A menudo, trabajamos solo con una única trayectoria muestral, posiblemente proveniente de la historia. En este caso, estamos aproximando el desempeño de la política usando esta única trayectoria muestral, que podemos escribir como
\[\begin{align} \max_\pi \Fhat^\pi(\omega\vert S_0) = \sum_{t=0}^T C_t(S_t(\omega),X^\pi_t(S_t(\omega))). \label{eq:objectivecumulativerewardsample} \end{align}\]Cada vez que escribamos una función objetivo usando una esperanza como en $\eqref{eq:objectivecumulativereward}$, recuerde que lo que realmente haríamos es usar un promedio como en $\eqref{eq:objectivecumulativerewardaverage}$ o una muestra como en $\eqref{eq:objectivecumulativerewardsample}$.
La esperanza también puede necesitar reflejar la incertidumbre en el estado inicial $S_0$, que podría capturar creencias sobre pronósticos inciertos, o estimaciones inciertas sobre el estado de una enfermedad en un paciente. En este caso, la trayectoria muestral $\omega$ necesita incluir muestras de estas distribuciones iniciales.
Habrá algunos entornos donde tiene más sentido usar un contador $n$ en lugar del tiempo. En este caso, dejamos que $S^n$ sea el estado después de $n$ observaciones (estas pueden ser experimentos, llegadas de clientes, iteraciones de un algoritmo). Usaremos el tiempo $t$ como nuestro índice predeterminado.
Las variables de estado iniciales $S_0$
Necesitamos distinguir entre el estado inicial $S_0$ y los estados subsiguientes $S_t$ para $t > 0$:
- $S_0$ – El estado inicial $S_0$ captura i) parámetros determinísticos que nunca cambian, ii) valores iniciales de cantidades o parámetros que sí cambian (posiblemente debido a decisiones), y iii) creencias sobre cantidades o parámetros que no conocemos perfectamente (esto podría ser los parámetros de una distribución de probabilidad), tales como cómo respondemos a una vacuna o cómo responderá el mercado al precio. Las creencias pueden permanecer estáticas, o podemos actualizarlas a medida que aprendemos de las observaciones.
- $S_t$ – Esta es toda la información que necesitamos en el tiempo $t$ de la historia para modelar el sistema desde el tiempo $t$ en adelante. $S_t$ para $t > 0$ solo incluye variables que cambian a lo largo del tiempo, lo que significa que en el tiempo $t$ también podemos estar usando información estática contenida en $S_0$.
Escribimos la dependencia explícita del desempeño de la política respecto al estado inicial $S_0$, ya sea que usemos $F^\pi(S_0)$, $\Fbar^\pi(S_0)$ o $\Fhat^\pi(\omega\vert S_0)$. Aunque esto debería ser obvio, con frecuencia se pasa por alto. El estado inicial incluye elementos tales como:
- Valores iniciales de las cantidades de recursos físicos o financieros $R_0$ – Esto podría ser inventarios iniciales, la ubicación inicial de un vehículo, las máquinas disponibles, y el conjunto inicial de instalaciones. También incluye cualquier valor estático, como una red de transporte, el tamaño de un almacén (que no cambia), y el número de camiones en una flota.
- Valores iniciales de parámetros, junto con cualquier función utilizada para modelar el problema $I_0$ – Esto podría ser un precio inicial, el nivel de medicación en un paciente, junto con la elección de funciones para realizar pronósticos o modelar la evolución de una enfermedad en una población.
- Creencias o estimaciones iniciales de cualquier cantidad o parámetro $B_0$ – Esto podría ser un pronóstico de demanda, la estimación de cómo responden los mercados a los precios, cómo está en las encuestas un candidato presidencial, o creencias sobre el desempeño de un proceso de manufactura.
Notamos que ayuda separar los valores iniciales que nunca cambian de aquellos que evolucionan con el tiempo, ya sea directamente como resultado de decisiones o de información exógena. Los valores que nunca cambian se almacenan en $S_0$, pero no se representan en $S_t$ para $t > 0$. La razón de esto es el deseo de mantener a $S_t$ lo más compacto posible.
Supongamos que nuestra política $X^\pi(S_t\vert \theta)$ tiene parámetros ajustables. Por ejemplo, podríamos estar gestionando un sistema de inventario donde usamos la conocida política de “pedido hasta el nivel” (conocida en la literatura de inventarios como una política $(s,S)$) dada por
\[X^\pi(S_t\vert \theta) = \begin{cases} \theta^{max} - R_t & R_t < \theta^{min},\\ 0 & \text{otherwise.}\end{cases}\]donde $\theta = (\theta^{min},\theta^{max})$. Por simplicidad, podríamos suponer que cuando hacemos un pedido este llega de inmediato (una suposición estándar de libro de texto que nunca es cierta en la práctica), lo que nos permite escribir la evolución de nuestro estado físico $R_t$ (la cantidad en inventario justo antes de hacer nuestro pedido instantáneo) usando
\[R_{t+1} = \max\{0,R_t + x_t - \Dhat_{t+1}\}\]donde $x_t = X^\pi(S_t\vert \theta)$ y $\Dhat_{t+1}$ es la demanda de nuestro producto durante el intervalo $(t,t+1)$ (esta es nuestra información exógena $W_{t+1}$). Finalmente, sea $C(S_t,x_t,W_{t+1})$ nuestra ganancia neta durante el intervalo $(t,t+1)$ (lo cual no es importante por ahora).
Ahora imaginemos que tenemos un proceso de demanda histórico $W_1, W_2, \ldots, W_t, \ldots, W_T$ que nos permite ejecutar una simulación de nuestro sistema. Sea $\omega$ esta secuencia histórica de demandas (o cualquier información exógena). Escribiríamos el problema de encontrar el mejor conjunto de parámetros de pedido $\theta$ usando
\[\begin{align} \max_\theta \Fhat^\pi(\omega,\theta\vert S_0) = \sum_{t=0}^T C_t(S_t(\omega),X^\pi_t(S_t(\omega))), \label{eq:optimizingtheta} \end{align}\]donde la variable de estado evoluciona de acuerdo con
\[S_{t+1}(\omega) = S^M(S_t(\omega), X^\pi_t(S_t(\omega)), W_{t+1}(\omega)).\]Sea $\theta^\ast $ el valor de $\theta$ que encontramos al optimizar $\eqref{eq:optimizingtheta}$. La forma correcta de escribir este valor óptimo es como una función $\theta^\ast (S_0)$ que depende de la información en $S_0$ (también depende de la trayectoria muestral $\omega$). Esto ayuda a comunicar la realidad de que si cambiamos los datos de entrada de nuestro problema, representados por $S_0$, esto puede tener un impacto en los mejores valores de nuestros parámetros de política $\theta$. ¡De hecho, podríamos incluso tener que cambiar nuestra elección de política!
Variaciones
Hay dos variaciones importantes de nuestro modelo matemático básico:
-
Del tiempo $t$ a la iteración $n$ – Hay entornos de problemas donde resulta más natural usar un contador $n$ que el tiempo $t$. Hacemos más que simplemente cambiar $t$ por $n$, ya que vemos las variables que cambian con las iteraciones de manera diferente a una evolución a lo largo del tiempo. Específicamente, colocamos el índice $n$ en el superíndice, tal como $S^n$, $x^n$ y $W^{n+1}$.
Una razón para esto es que vemos un conjunto de variables a lo largo del tiempo $x_1, x_2, \ldots, x_t, \ldots, x_T$ como un vector $x=(x_1, x_2, \ldots, x_t, \ldots, x_T)$, lo cual es útil al modelar problemas determinísticos (podríamos optimizar sobre todo el vector $x$ a la vez). En contraste, vemos $x^n$ como una función que va evolucionando en el tiempo.
De manera más práctica, colocar $n$ en el superíndice nos permite escribir simulaciones iterativas. Así, escribiríamos el proceso de información a lo largo del tiempo para la iteración $n$ usando
Si estamos buscando iterativamente la mejor política, podríamos escribir nuestra política para la iteración $n$ usando $X^{\pi,n}(S_t)$, lo cual produce entonces
\[S^n_0, x^n_0, W^n_1, \ldots, S^n_t, x^n_t, W^N_{t+1}, \ldots, S^N_T,\]donde $x^n_t = X^{\pi,n}(S^n_t\vert \theta)$.
-
Optimización de la recompensa final – Un entorno común es aquel en el que estamos realizando una búsqueda estocástica, como sucedería al buscar la mejor política. Cada iteración para evaluar el algoritmo podría requerir una simulación a lo largo del tiempo, aunque esto no siempre es el caso.
Ahora supongamos que nuestra variable de decisión es el parámetro $\theta$, y que tenemos un algoritmo $\Theta^\pi(S^{\theta,n})$ que funciona igual que una política $X^\pi(S_t\vert \theta)$, pero donde $S^{\theta,n}$ captura el “estado” del algoritmo en la $n$-ésima iteración.
Los algoritmos de búsqueda son todos problemas de decisión secuencial, pero a diferencia de la mayoría de los problemas de decisión secuencial a lo largo del tiempo, queremos ejecutar $N$ iteraciones, y solo nos importa nuestra solución al final. Sea $\theta^{\pi,N}$ el valor de $\theta^n$ después de $N$ iteraciones, siguiendo el “algoritmo” (política) $\pi$.
El valor $\theta^{\pi,N}$ depende de la secuencia específica de nuestro proceso de información $W^1, \ldots, W^t, \ldots, W^N$, pero luego tenemos que evaluarlo usando un nuevo conjunto de muestras que vamos a llamar $\What$.
Evaluamos el desempeño de nuestro algoritmo usando una función objetivo de recompensa final, que escribimos como
Dicho de manera simple, evaluamos nuestra política de aprendizaje para $\theta$, que denotamos $\Theta^\pi(S^{\theta,N})$, simulando a través de $N$ iteraciones usando observaciones de $W^n$ (que puede ser una simulación completa a lo largo del tiempo $t$). Cuando obtenemos nuestra estimación final del parámetro $\theta$, a la que llamamos $\theta^{\pi,N}$, evaluamos el desempeño de este valor usando una simulación separada donde fijamos $\theta = \theta^{\pi,N}$ y luego creamos un nuevo conjunto de observaciones aleatorias que llamamos $\What^m$ para $m=1, \ldots, M$.
Modelado de la incertidumbre
Para muchos problemas complejos (las cadenas de suministro, los sistemas de energía y la salud pública son solo algunos ejemplos), identificar y modelar las diferentes formas de incertidumbre puede ser un ejercicio rico y complejo. Vamos a insinuar los problemas que surgen, pero no vamos a intentar una discusión exhaustiva de esta dimensión.
La incertidumbre se comunica a nuestro modelo a través de dos mecanismos: el estado inicial $S_0$, que es donde modelaríamos los parámetros de las distribuciones de probabilidad que describen cantidades y parámetros que no conocemos perfectamente, y el proceso de información exógena $W_1, \ldots, W_T$.
Incertidumbre en el estado inicial
La variable de estado inicial puede contener parámetros determinísticos o valores iniciales de cantidades y parámetros que varían dinámicamente. Si esto es todo lo que hay en el estado inicial, entonces no está capturando ninguna forma de incertidumbre.
Hay muchos problemas donde no conocemos algunas cantidades o parámetros, pero podemos representar lo que sí sabemos a través de los parámetros de una distribución de probabilidad. Algunos ejemplos son:
- La respuesta de un paciente a un nuevo medicamento.
- Cómo responderá un mercado a un cambio de precio.
- Cuántas cabezas de lechuga vendibles tenemos en inventario (una cantidad incierta puede haberse marchitado y ya no ser vendible).
- El momento en que llegará una caja de inventario previamente pedida a China.
- El monto de los depósitos a un fondo mutuo varía aleatoriamente alrededor de una media $\lambda$, pero no sabemos cuál es $\lambda$.
Estas son algunas de las maneras en que podemos inicializar un modelo con incertidumbre en algunas de las entradas.
Una creencia probabilística inicial puede provenir de un juicio subjetivo, o de observaciones o experimentos previos.
El proceso de información exógena
La segunda manera en que la incertidumbre entra en nuestro modelo es a través del proceso de información exógena. La variable $W_t$ contiene información que no se conoce hasta el período de tiempo $t$. Esto significa que tenemos que tomar una decisión $x_t$ en el tiempo $t$ antes de conocer el resultado de $W_{t+1}$.
A continuación se presenta una lista de ejemplos de $W_{t+1}$ que se revelan después de tomar una decisión $x_t$:
- Elegimos una ruta, y luego observamos el tiempo de viaje en la ruta.
- Elegimos un medicamento, y luego observamos cómo responde el paciente.
- Elegimos un catalizador, y luego observamos la resistencia del material que produce.
- Elegimos un producto para anunciar en un mercado en línea, y luego observamos las ventas.
- Seleccionamos un diseño de interfaz web, y luego observamos el número de clics que puede generar.
- Asignamos fondos a una inversión, y luego observamos el cambio en el precio de la inversión.
En cada caso, la información que observamos después de tomar la decisión afecta el desempeño de la decisión (y cuál decisión habría sido la mejor).
A estas alturas el lector probablemente se ha dado cuenta de que $W_{t+1}$ es usualmente una colección de diferentes tipos de información. Por ejemplo, imaginemos que estamos tratando a un paciente que experimenta niveles elevados de azúcar en la sangre. El médico quiere experimentar con diferentes estrategias, que van desde la dieta y el ejercicio o medicamentos para reducir peso, hasta medicamentos que apuntan específicamente al azúcar en la sangre. Las fuentes de información que el médico tiene que procesar podrían incluir:
- Disposición del paciente a seguir una dieta.
- Cumplimiento del paciente con las instrucciones de la dieta.
- Disposición del paciente a aceptar inyecciones diarias para la pérdida de peso.
- Pérdida de peso real (de cualquier programa).
- Cambio real en el azúcar en la sangre.
Cada una de estas es un flujo separado de información. Podemos modelar esto introduciendo el conjunto $\Ical_t$, el conjunto de procesos de información en el tiempo $t$ (el conjunto puede cambiar a medida que cambiamos de estrategias, abriendo nuevos flujos de información). Ahora podemos expresar los diferentes tipos de información usando $W_{t+1,i}$, la realización de información de la fuente $i\in\Ical_t$, de modo que $W_{t+1} = (W_{t+1,i})_{i\in\Ical_t}$.
Vamos a seguir usando $W_{t+1}$ para representar la nueva información que llega, pero el lector debe recordar que en aplicaciones reales, esto típicamente va a incluir un conjunto completo de fuentes de información, cada una con sus propios comportamientos.
Procesos dependientes del estado/decisión
Hay muchas aplicaciones donde la información $W_{t+1}$ depende del estado actual $S_t$ y/o de la decisión $x_t$. Algunos ejemplos incluyen:
- La falta de inventario puede desalentar a los clientes, reduciendo la demanda.
- Comprar una gran cantidad de acciones puede aumentar sus precios.
- La decisión de recomendar vacunas puede influir en la progresión de una enfermedad.
- El número de generadores eléctricos en línea puede cambiar los precios de la red eléctrica.
Por esta razón, resulta útil representar la información exógena como una función $W_{t+1}(S_t,x_t)$, la función de información exógena que da la información que llega en el intervalo $(t,t+1)$.
Por ejemplo, imaginemos que estamos comprando o vendiendo acciones en grandes cantidades, lo cual puede influir en el precio futuro. La dinámica podría escribirse como
\[\begin{align} p_{t+1} = \theta^p_0 p_t + \theta^p_1 p_{t-1} + \theta^p_2 p_{t-2} + W_{t+1}(S_t,x_t). \label{eq:statedependentprice} \end{align}\]El estado de este proceso de precios se escribiría
\[S_t = (p_t, p_{t-1}, p_{t-2}).\]El cambio aleatorio en el precio, dado por $W_{t+1}(S_t,x_t)$, refleja nuestra creencia de que el cambio en el precio podría depender del precio actual (si el precio es alto, los cambios futuros probablemente sean negativos), así como de la cantidad que estamos comprando ($x_t > 0$) o vendiendo ($x_t < 0$).
Por supuesto, quisiéramos usar datos históricos para intentar separar cualquier influencia estructural de $S_t$ y $x_t$ sobre los precios futuros del ruido verdaderamente exógeno. Así, podríamos proponer un modelo
\[W_{t+1}(S_t,x_t) = \theta^x x_t + \varepsilon_{t+1},\]donde podríamos suponer que
\[\varepsilon_{t+1} \sim N(0, \vert x_t\vert \sigma^2_t),\]Este modelo supone que $\varepsilon_{t+1}$ tiene media 0, y varianza que crece con el valor absoluto de $x_t$. La información $W_{t+1}(S_t,x_t)$ tendría entonces media $\theta^x x_t$, que es positiva si estamos comprando acciones ($x_t > 0$), y negativa si estamos vendiendo en el mercado ($x_t < 0$).
Este libro seguirá usando $W_{t+1}$ como la notación predeterminada, pero el lector debe tener en cuenta que puede depender del estado actual y/o de la decisión tomada dado el estado.
Estilos de incertidumbre
Identificar los tipos de información es el primer paso para comprender la incertidumbre. El siguiente paso es caracterizar los diferentes estilos de incertidumbre. A continuación se resumen algunas de las formas más importantes en que pueden comportarse los procesos de información:
- Variabilidad de grano fino – Esto puede surgir en escalas de tiempo de segundos (incluso fracciones de segundo), minutos, horas o diariamente.
- Cambios de nivel – La variabilidad de grano fino de un proceso típicamente representa variaciones en torno a una media, pero hay ocasiones en que la media cambiará periódicamente a un nuevo nivel. Esto podría reflejar nueva tecnología, ajustes de la competencia o cambios en la economía.
- Ráfagas y demandas intermitentes – La propagación de una enfermedad puede crear un aumento repentino de infecciones, ya que los brotes pueden extenderse localmente. Un cliente puede adquirir un producto y recomendarlo a sus amigos, quienes luego se lo cuentan a sus propios amigos.
- Picos – Una tormenta de nieve que se aproxima puede generar un salto en la demanda de leche, huevos y papel higiénico; el fallo de un generador eléctrico puede provocar un pico en los precios de la electricidad.
- Eventos espaciales – El clima, las enfermedades y los cambios en las regulaciones pueden generar cambios aleatorios de naturaleza regional.
- Eventos sistémicos – Son eventos que pueden afectar a toda una empresa (traspasando fronteras internacionales), a todo un país, o incluso tener un impacto global. Esto puede surgir por un ciberataque a las comunicaciones, cambios en la percepción pública y publicidad negativa.
- Eventos raros – Los eventos raros pueden surgir de diversas fuentes, como terremotos, brotes de enfermedades o ataques terroristas. Estos tienden a ser eventos que ocurren con muy poca frecuencia, pero que pueden tener un gran impacto en una organización cuando ocurren.
- Contingencias – Esta categoría se refiere a eventos que podrían ocurrir, pero de los cuales no hay historial. Por ejemplo, los operadores de la red planificarán ante el fallo de plantas de energía nuclear. Aunque esto quizás nunca haya ocurrido dentro de un país, el operador de la red puede querer prepararse igualmente para el evento en caso de que suceda.
Estos comportamientos pueden tener un impacto en la elección de la política para tomar decisiones, un tema que abordamos a continuación.
Se reconoce ampliamente que la incertidumbre es un problema para el cual las empresas, organizaciones e incluso los gobiernos deben planificar. Con frecuencia se pasa por alto que la razón para modelar la incertidumbre es entender cómo afecta a las decisiones. La incertidumbre siempre está asociada con procesos de información que llegan en el futuro, por lo que debemos pensar en cómo una decisión tomada ahora se ve afectada por esta información en el futuro.
Diseño de políticas
Una política es un método para tomar una decisión… cualquier método.
Las políticas son funciones que usan la información contenida en la variable de estado para tomar una decisión. Esto suena como un problema bien definido; después de todo, la comunidad de aprendizaje automático se construye enteramente en torno al desafío de encontrar funciones que se ajusten a un conjunto de datos de entrenamiento. Sin embargo, el diseño de políticas es mucho más rico, como lo evidencia la diversidad de comunidades que trabajan en esta área.
La Figura 1.2 muestra las portadas de libros que representan aproximadamente 15 campos distintos, todos relacionados con problemas de decisión secuencial bajo incertidumbre. Utilizan ocho sistemas de notación diferentes, y adoptan enfoques fundamentalmente distintos en cuanto a cómo abordan el modelado. Algunos confunden las políticas (que involucran problemas de optimización embebidos) con funciones objetivo.
Métricas de desempeño de la política
La optimización determinista se caracteriza por una función objetivo que determina si una decisión es mejor que otra. Con los problemas de decisión secuencial, generalmente tendremos una función objetivo que evalúa el desempeño de una política, tal como hicimos con las ecuaciones $\eqref{eq:objectivecumulativereward}$, $\eqref{eq:objectivecumulativerewardaverage}$ y $\eqref{eq:objectivecumulativerewardsample}$.
En la práctica, sin embargo, las políticas se eligen con base en una serie de criterios en competencia:
- Calidad de la solución – Generalmente observamos el desempeño (por ejemplo, costos, ganancias, resultados de salud) durante cierto periodo de tiempo, tal como se expresa en la versión muestreada del objetivo en la ecuación $\eqref{eq:objectivecumulativerewardsample}$. Dado que esto es aleatorio, debemos considerar tanto el desempeño promedio como el desempeño en el peor caso.
- Requisitos computacionales – En entornos operativos, los tiempos de ejecución importan. Al igual que con el objetivo, el tiempo que toma calcular una política es aleatorio, por lo que debemos considerar el tiempo de ejecución promedio y el tiempo de ejecución en el peor caso.
- Transparencia – Qué tan fácil es rastrear una decisión hasta los datos de entrada, los cuales pueden contener errores.
- Flexibilidad/adaptabilidad – Los problemas del mundo real pueden ser complicados, y a menudo tenemos que adaptarnos a situaciones complejas.
- Complejidad metodológica – Si un grupo de analítica interno (por ejemplo) va a implementar una política, deberá considerar la probabilidad de lograr que un método realmente funcione.
- Requisitos de datos – Diferentes políticas tienen diferentes requisitos de datos.
Las comunidades de optimización matemática ilustradas en la Figura 1.2 podrían hablar de políticas óptimas, lo cual implica optimizar la esperanza en la ecuación $\eqref{eq:objectivecumulativereward}$. Sin embargo, es importante prestar atención a todas estas características.
Las cuatro clases de políticas
Los libros de la Figura 1.2 presentan una variedad de formas de tomar decisiones a lo largo del tiempo. Resulta que todas pueden dividirse en clases de políticas bien definidas. Existen dos estrategias fundamentales para crear políticas, cada una de las cuales puede subdividirse a su vez en dos clases, dando lugar a cuatro clases de políticas:
Búsqueda de políticas – Aquí se busca entre métodos (funciones) para tomar decisiones, simulando su desempeño (como hacemos en la ecuación $\eqref{eq:objectivecumulativereward}$), para encontrar el método que funcione mejor en promedio a lo largo del tiempo. Esto puede implicar buscar entre diferentes clases de métodos, así como entre cualesquiera parámetros ajustables de un método dado. Esta idea abre dos clases de políticas:
- 1) Aproximaciones de función de política (PFA, por sus siglas en inglés) – Son funciones analíticas de un estado que especifican directamente una acción. La política de pedido hasta un nivel en la ecuación $\eqref{eq:introorderupto}$ es un buen ejemplo, junto con nuestra política de usar un pronóstico ajustado en la ecuación $\eqref{eq:adjustedforecastpolicy}$.
- 2) Aproximaciones de función de costo (CFA, por sus siglas en inglés) – Son políticas que implican resolver un problema de optimización que típicamente es una simplificación del problema original, con parámetros introducidos para ayudar a que la política funcione mejor a lo largo del tiempo. Esta es una idea particularmente poderosa que se utiliza ampliamente en la industria. Tenemos varias ilustraciones de CFAs más adelante en el libro (comenzando en el Capítulo 4, para aprender el mejor medicamento para la diabetes).
Políticas de anticipación – Podemos construir políticas efectivas optimizando la contribución (o costo) de una decisión, más una aproximación de las contribuciones (o costos) posteriores resultantes de la decisión tomada ahora. Nuevamente, podemos dividir estas en dos clases adicionales de políticas:
- 3) Aproximaciones de función de valor (VFA, por sus siglas en inglés) – Imaginemos que estamos recorriendo una red representada en la Figura 1.3, donde deseamos encontrar un camino del nodo 1 al nodo 11. Ahora imaginemos que estamos en el nodo $S_t = i = 2$, donde $t$ cuenta cuántos enlaces hemos recorrido. Sea $V_{t+1}(S_{t+1})$ el valor (suponiendo que estamos maximizando) del camino desde el nodo $S_{t+1}$ (como los nodos 4 o 5) hasta el nodo 11 (no se preocupe por cómo obtuvimos $V_{t+1}(S_{t+1})$). Sea una decisión $x_t$ el enlace que recorremos al salir del nodo $S_t = i$. El valor de estar en el nodo $S_t$ estaría dado por
La ecuación $\eqref{eq:bellmangraph}$ se conoce como la ecuación de Bellman. Cuando se utiliza para encontrar el mejor camino en una red determinista como la que representamos en la Figura 1.3, resulta bastante fácil de visualizar.
Existen muchos problemas donde la transición del estado $S_t$ a $S_{t+1}$ implica información aleatoria que no se conoce en el tiempo $t$. Vimos un ejemplo sencillo de aleatoriedad en nuestro primer problema de inventario, y un ejemplo más complicado en nuestro segundo problema de inventario.
Para estos problemas más generales, si estamos en un estado $S_t$, tomamos una decisión $x_t$, y luego observamos nueva información $W_{t+1}$ (que no se conoce en el tiempo $t$), esto nos llevará a un nuevo estado $S_{t+1}$ de acuerdo con nuestra función de transición
\[S_{t+1} = S^M(S_t,x_t,W_{t+1}).\]Esto significa que en el tiempo $t$, cuando debemos elegir $x_t$, $W_{t+1}$ es una variable aleatoria, lo cual implica que $S_{t+1}$ también es una variable aleatoria. En este caso debemos insertar una esperanza en la ecuación de Bellman y escribir la ecuación $\eqref{eq:bellmangraph}$ como
\[\begin{align} V_t(S_t) = \max_{x_t} \big(C(S_t,x_t) + \E_{W_{t+1}} \left\{V_{t+1}(S_{t+1})\vert S_t,x_t\right\}\big). \label{eq:bellmanstochastic} \end{align}\]Aquí hemos insertado la esperanza $\E_{W_{t+1}}\lbrace \cdot\rbrace $, que literalmente significa promediar sobre todos los resultados aleatorios de $W_{t+1}$.
La versión estocástica de la ecuación de Bellman en $\eqref{eq:bellmanstochastic}$ es extremadamente general. El estado $S_t$ no significa simplemente un nodo en un grafo; captura toda (y cualquier) información relevante para el problema. La dificultad es que ya no podemos calcular la función de valor $V_t(S_t)$, lo cual a su vez significa que no tendremos acceso a $V_{t+1}(S_{t+1})$, que supusimos conocer en las ecuaciones $\eqref{eq:bellmangraph}$ y $\eqref{eq:bellmanstochastic}$.
La estrategia que la comunidad de investigación ha utilizado al intentar aplicar la ecuación de Bellman es recurrir al campo del aprendizaje automático para estimar una aproximación estadística que llamaremos $\Vbar_t(S_t)$. Suponiendo que podamos idear una aproximación razonable $\Vbar_{t+1}(S_{t+1})$, escribiríamos nuestra política (nuestro método para tomar una decisión) usando
\[\begin{align} X^\pi(S_t) = \argmax_{x_t\in\Xcal_t} \big(C(S_t,x_t) + \E_{W_{t+1}} \{\Vbar_{t+1}(S_{t+1})\vert S_t,x_t\}\big). \label{eq:introvbarpolicy} \end{align}\]La notación “$\argmax_x f(x)$” significa el valor de $x$ que maximiza la función $f(x)$. El índice $\pi$ lleva la información que especifica la estructura de la función $f$, y cualesquiera parámetros ajustables $\theta$ que necesitaríamos en la aproximación $\Vbar_{t+1}(S_{t+1})$.
Esta clase de política se encuadra bajo denominaciones como programación dinámica aproximada y, más comúnmente, aprendizaje por refuerzo. Aunque es una idea poderosa, no es fácil de aplicar y depende de nuestra capacidad para crear una aproximación precisa $\Vbar_{t+1}(S_{t+1})$.
Existe una literatura muy rica sobre métodos para aproximar funciones de valor, pero no es una panacea. Este libro ilustrará esta idea en algunos lugares, pero se advierte a los lectores que esta clase de políticas es bastante difícil de usar.
-
4) Aproximaciones de anticipación directa (DLAs) – Hay muchos problemas en los que simplemente no podemos desarrollar políticas efectivas usando ninguna de las primeras tres clases, y cuando esto sucede, tenemos que recurrir a las aproximaciones de anticipación directa. Escribiremos esto en su forma matemática completa más adelante, pero por ahora, vamos a describir las DLAs como la toma de una decisión ahora mientras se optimiza sobre un modelo (típicamente aproximado) que se extiende sobre algún horizonte de planificación.
Una DLA común es crear un modelo aproximado que sea determinista. Esto es lo que hacemos cuando usamos un sistema de navegación que encuentra la ruta más corta hacia el destino asumiendo que conocemos el tiempo de viaje a lo largo de cada enlace de la red. Como regla general, resolver un modelo estocástico exacto del futuro es casi siempre imposible, por lo que vamos a investigar diferentes estrategias para aproximar el problema.
Ilustramos nuestro marco de modelado usando dos problemas de inventario, y sugerimos dos políticas simples (formas de PFAs) con las ecuaciones $\eqref{eq:introorderupto}$ y $\eqref{eq:adjustedforecastpolicy}$, pero hicimos esto solo para tener un ejemplo concreto de una política. Aunque las PFAs se usan ampliamente en la toma de decisiones cotidiana, estos son ejemplos especializados.
En contraste, vamos a afirmar que las cuatro clases de políticas que acabamos de describir (PFAs, CFAs, VFAs y DLAs) son universales, en el sentido de que cubren cualquier método que podamos usar para resolver cualquier problema de decisión secuencial. Para ser claros, estas son meta-clases. Es decir, si pensamos que un problema se presta a una clase particular, no hemos terminado, ya que todavía tenemos que diseñar la política específica dentro de la clase. Aun así, sentimos que estas cuatro clases proporcionan una hoja de ruta para guiar el proceso de diseño de políticas.
Probando políticas
Para probar el valor de una política, vamos a usar la ecuación $\eqref{eq:objectivecumulativerewardsample}$ que simula una política sobre una única muestra de trayectoria del proceso de información $W_t$. La parte más difícil al simular una política es típicamente crear el proceso de información exógena.
Sea $\omega$ una muestra de trayectoria, donde $W_1(\omega), \ldots, W_T(\omega)$ representa una muestra de trayectoria particular. La Tabla 1.3 ilustra 10 muestras de trayectorias de precios que se indexan $\omega^1$ a $\omega^{10}$. Si elegimos $\omega^6$, entonces $W_7(\omega^6) = 44.16$.
| $t=1$ | $t=2$ | $t=3$ | $t=4$ | $t=5$ | $t=6$ | $t=7$ | $t=8$ | |
|---|---|---|---|---|---|---|---|---|
| $\omega^n$ | $p_1$ | $p_2$ | $p_3$ | $p_4$ | $p_5$ | $p_6$ | $p_7$ | $p_8$ |
| $\omega^1$ | 45.00 | 45.53 | 47.07 | 47.56 | 47.80 | 48.43 | 46.93 | 46.57 |
| $\omega^2$ | 45.00 | 43.15 | 42.51 | 40.51 | 41.50 | 41.00 | 39.16 | 41.11 |
| $\omega^3$ | 45.00 | 45.16 | 45.37 | 44.30 | 45.35 | 47.23 | 47.35 | 46.30 |
| $\omega^4$ | 45.00 | 45.67 | 46.18 | 46.22 | 45.69 | 44.24 | 43.77 | 43.57 |
| $\omega^5$ | 45.00 | 46.32 | 46.14 | 46.53 | 44.84 | 45.17 | 44.92 | 46.09 |
| $\omega^6$ | 45.00 | 44.70 | 43.05 | 43.77 | 42.61 | 44.32 | 44.16 | 45.29 |
| $\omega^7$ | 45.00 | 43.67 | 43.14 | 44.78 | 43.12 | 42.36 | 41.60 | 40.83 |
| $\omega^8$ | 45.00 | 44.98 | 44.53 | 45.42 | 46.43 | 47.67 | 47.68 | 49.03 |
| $\omega^9$ | 45.00 | 44.57 | 45.99 | 47.38 | 45.51 | 46.27 | 46.02 | 45.09 |
| $\omega^{10}$ | 45.00 | 45.01 | 46.73 | 46.08 | 47.40 | 49.14 | 49.03 | 48.74 |
Tabla 1.3. Ilustración de un conjunto de muestras de trayectorias de precios, todas comenzando en $45.00.
La pregunta es: ¿cómo creamos una muestra de observaciones como las que se muestran en la Tabla 1.3? Hay tres estrategias típicas:
- Crear muestras a partir de datos históricos. Dado que solo hay un resultado en cualquier momento dado, podemos crear múltiples muestras de trayectorias combinando observaciones de diferentes periodos de tiempo. Podríamos elegir precios de diferentes años, o demandas de diferentes meses, o tiempos de viaje observados en diferentes días. Este enfoque no es posible cuando la información exógena depende del estado $S_t$ o de las decisiones $x_t$.
- Simular a partir de un modelo matemático. Este enfoque ofrece la ventaja de poder generar grandes muestras para obtener estimaciones estadísticamente confiables del desempeño de una política. Estos modelos pueden ser muy sofisticados, pero es bastante fácil crear modelos (incluso sofisticados) que no repliquen el comportamiento de los datos reales. El mayor desafío es capturar las correlaciones, ya sea a lo largo del tiempo o entre muestras (por ejemplo, las demandas de diferentes productos, los precios de diferentes acciones, o la velocidad del viento en diferentes ubicaciones).
- Podemos probar una idea en el campo, usando observaciones tal como ocurren realmente. La ventaja de esto es que estamos trabajando con datos reales (la historia puede no ser igual al futuro). La desventaja es que se necesita un día para observar un día de datos nuevos (y puede que necesitemos mucho más que un solo día de observaciones).
Si $W_{t+1}$ depende del estado $S_t$ y/o de la decisión $x_t$, entonces tenemos que diseñar una manera de reflejar esta dependencia. Crear un modelo matemático hace posible realizar muchas simulaciones en la computadora, pero crear muestras del proceso de información también requiere recrear correlaciones a lo largo del tiempo, así como en el espacio. Remitimos al lector a RLSO, Capítulo 10, para una discusión más profunda sobre el modelado de la incertidumbre.
Próximos pasos
Los próximos cinco capítulos del libro van a aplicar nuestro marco de modelado a cinco problemas diferentes:
- Capítulo 2 – Un problema de venta de activos
- Capítulo 3 – Planificación adaptativa de mercado
- Capítulo 4 – Aprendiendo el mejor medicamento para la diabetes
- Capítulo 5 – Problemas de ruta más corta estocástica - Estático
- Capítulo 6 – Problemas de ruta más corta estocástica - Dinámico
Cada uno de estos capítulos seguirá el mismo esquema que usamos anteriormente para describir los dos problemas de inventario. Este esquema consiste en:
- Narrativa – Una descripción en inglés sencillo del problema.
- El modelo universal – Este modelo seguirá nuestro formato de describir los cinco elementos de un problema de decisión secuencial: variables de estado, variables de decisión, variables de información exógena, la función de transición y la función objetivo.
- Modelo de incertidumbre – Aquí proporcionaremos un posible modelo de cualquier incertidumbre en el problema.
- Diseño de políticas – Vamos a sugerir posibles políticas para tomar decisiones. Hemos elegido nuestros problemas de manera que los cinco escenarios de aplicación nos den un recorrido por las cuatro clases de políticas. Por ahora, vamos a dejar que el lector intente reconocer cuál de las cuatro clases estamos elegiendo.
- Extensión – Finalmente, podemos sugerir una o más posibles extensiones de nuestro problema básico que pueden requerir cambiar la política.
Luego volvemos a las cuatro clases de políticas en el Capítulo 7 y discutimos nuestro marco de modelado general, usando los problemas de los Capítulos 2–6 para ilustrar diferentes ideas de modelado.
Después de esta discusión, volvemos a nuestro patrón de capítulos de enseñanza por ejemplo, pero usando problemas más complejos. Nuestros capítulos restantes cubren los siguientes problemas:
- Capítulo 8 – Almacenamiento de energía I
- Capítulo 9 – Almacenamiento de energía II
- Capítulo 10 – Gestión de la cadena de suministro I: El vendedor de periódicos de dos agentes
- Capítulo 11 – Gestión de la cadena de suministro II: El juego de la cerveza
- Capítulo 12 – Optimización de clics en publicidad
- Capítulo 13 – Problema de gestión de sangre
- Capítulo 14 – Optimización de ensayos clínicos
¿Qué aprendimos?
- Para comenzar, ¡aprendimos qué es una decisión!
- Presentamos un modelo general, llamado el marco de modelado universal, para cualquier problema de decisión secuencial.
- Ilustramos el modelo usando primero un problema de inventario clásico, donde el estado del sistema es la cantidad en inventario.
- Luego pasamos a un problema de inventario un poco más complicado donde la variable de estado incluye el estado del recurso $R_t$ del inventario, una variable de estado informacional en forma de precio $p_t$, y finalmente un estado de creencia sobre la demanda próxima $\Dhat_{t+1}$ en forma de una media y varianza estimadas.
- Aprendimos cómo modelar el flujo de información exógena que puede llegar de varias fuentes diferentes. La información exógena se representa como una función que puede depender del estado y/o de la decisión.
- Ilustramos dos formas de una clase simple de política conocida como aproximación de función de política (o PFA).
- Aprendimos que las políticas pueden evaluarse de varias maneras diferentes que dependen del contexto y de cómo se usan las decisiones.
- Cerramos con una breve visión general de cuatro clases de políticas. Se proporcionarán ilustraciones de las cuatro clases en los Capítulos 2–6, momento en el cual nos detenemos en el Capítulo 7 para discutir las políticas con mayor profundidad, preparando el escenario para los problemas más complejos en los Capítulos 8–14.
Ejercicios
Preguntas de repaso
- ¿Cuáles son los cinco elementos del modelo matemático de un problema de decisión secuencial?
- ¿Cuál es la diferencia entre las variables en el estado inicial $S_0$ y aquellas en el estado dinámico $S_t$ para $t > 0$?
- ¿Cuál es la diferencia entre una decisión y la información exógena?
- ¿Cuáles son las dos categorías principales de políticas, y en qué se diferencian?
- Compare las variables de estado del problema de inventario simple con el problema de inventario más complicado.
Preguntas de resolución de problemas
- Compare las políticas para los dos problemas de inventario en términos de cómo manejarían el comportamiento dependiente del tiempo. Por ejemplo, nuestra pizzería puede tener demandas mucho más altas los fines de semana que los días de semana. Comente sobre el valor de hacer que el parámetro ajustable $\theta$ dependa del tiempo (o del día de la semana) en términos de cómo podría mejorar la solución.
- Contraste cómo abordaría la calibración del parámetro $\theta$ para los problemas de inventario:
- En un simulador.
- En el campo.