Capítulo 13: Problema de gerenciamento de sangue
Visão geral do capítulo
O problema de gestão de sangue é um problema de alocação de recursos multidimensional, pois é necessário gerenciar oito tipos sanguíneos diferentes, ao mesmo tempo em que se acompanha há quanto tempo o sangue está armazenado (a menos que esteja congelado). Esta é a primeira vez que precisamos recorrer a ferramentas como a programação linear para tomar decisões a cada instante de tempo.
Começamos ilustrando uma política míope que envolve resolver um programa linear simples que ignora a tomada de decisões que não compreendem o impacto das decisões atuais sobre o futuro. Na gestão de sangue, isso pode surgir na gestão do sangue $O-$, conhecido como doador universal – pode ser usado para qualquer paciente. É útil manter reservas de sangue $O-$ caso haja escassez de outros tipos.
Em seguida, demonstramos o uso da programação dinâmica aproximada para equilibrar recompensas atuais com recompensas futuras. Para usar a ADP em um problema multidimensional, aproveitamos a estrutura do problema no projeto de uma aproximação para o valor de um conjunto de estoques de sangue no futuro. Essa ideia funciona quando conseguimos explorar a estrutura do problema.
Narrativa
O problema da gestão de estoques de sangue serve como uma ilustração particularmente elegante de um problema de alocação de recursos. Começaremos supondo que estamos gerenciando estoques em um único hospital, onde a cada semana precisamos decidir qual dos nossos estoques de sangue deve ser usado para atender às demandas da semana seguinte.
Precisamos começar com um pouco de contexto sobre o sangue. Para os fins de gestão de estoques de sangue, nos preocupamos principalmente com o tipo sanguíneo e a idade. Embora haja uma vasta gama de diferenças no sangue de dois indivíduos, para a maioria dos propósitos os médicos concentram-se nos oito principais tipos sanguíneos: $A+$ (“A positivo”), $A-$ (“A negativo”), $B+$, $B-$, $AB+$, $AB-$, $O+$ e $O-$. Embora a capacidade de substituir diferentes tipos sanguíneos possa depender da natureza da operação, para a maioria dos propósitos o sangue pode ser substituído de acordo com a Tabela 13.1.
| Doador \ Receptor | $AB+$ | $AB-$ | $A+$ | $A-$ | $B+$ | $B-$ | $O+$ | $O-$ |
|---|---|---|---|---|---|---|---|---|
| $AB+$ | X | |||||||
| $AB-$ | X | X | ||||||
| $A+$ | X | X | ||||||
| $A-$ | X | X | X | X | ||||
| $B+$ | X | X | ||||||
| $B-$ | X | X | X | X | ||||
| $O+$ | X | X | X | X | ||||
| $O-$ | X | X | X | X | X | X | X | X |
Tabela 13.1. Substituições de sangue permitidas para a maioria das operações, "X" significa que uma substituição é permitida.
Uma segunda característica importante do sangue é a sua idade. O armazenamento do sangue é limitado a seis semanas, após as quais ele precisa ser descartado. Os hospitais precisam antecipar se acreditam que poderão usar o sangue antes que ele atinja esse limite, pois ele pode ser transferido para centros de sangue que monitoram os estoques em diferentes hospitais dentro de uma região. Ajuda se um hospital consegue identificar o mais rápido possível o sangue que não vai precisar, para que ele possa ser transferido para locais que estão com escassez.
Enquadrando o problema
As respostas às nossas três perguntas de enquadramento são:
- Métricas: Maximizar a soma esperada de bonificações menos penalidades por alocar sangue de um tipo para satisfazer a demanda de outro tipo.
- Decisões: Quanto sangue de um tipo alocar para as demandas de sangue de outro tipo, junto com quanto sangue manter em estoque para cada tipo sanguíneo.
- Incertezas: As demandas futuras de sangue de cada tipo, junto com as doações de cada tipo sanguíneo.
Modelo básico
Variáveis de estado
Podemos modelar o problema do sangue como um problema de alocação de recursos heterogêneos. Começaremos com um modelo bastante básico que pode ser facilmente estendido com quase nenhuma mudança de notação. Começamos descrevendo os atributos de uma unidade de sangue armazenado usando
\[b = \begin{pmatrix} b_1 \\ b_2 \end{pmatrix} = \begin{pmatrix} \text{blood type } (A+, A-, \ldots) \\ \text{age (in weeks)} \end{pmatrix},\]e seja $\Bcal$ o conjunto de todos os tipos de atributos de sangue. Limitaremos a idade ao intervalo $0 \leq b_2 \leq 6$. Sangue com $b_2 = 6$ (o que significa sangue que já tem seis semanas de idade) não pode mais ser usado. Assumimos que as épocas de decisão são feitas em incrementos de uma semana. Os estoques de sangue são representados usando $R_{tb}$, as unidades de sangue do tipo $b$ disponíveis para serem alocadas ou mantidas no instante $t$, com $R_t = (R_{tb})_{b\in\Bcal}$.
Os atributos da demanda por sangue são dados por
\[a = \begin{pmatrix} a_1 \\ a_2 \\ a_3 \end{pmatrix} = \begin{pmatrix} \text{blood type of patient} \\ \text{surgery type: urgent or elective} \\ \text{is substitution allowed?} \end{pmatrix},\]e seja $\Acal$ o conjunto de todos os tipos de atributos para as demandas de sangue. O atributo $a_3$ captura o fato de que há algumas operações em que um médico não permitirá nenhuma substituição. Um exemplo é o parto, já que os bebês podem não conseguir tolerar um tipo sanguíneo diferente, mesmo que seja um substituto permitido. Para o nosso modelo básico, não permitimos que a demanda não atendida em uma semana seja mantida para uma semana posterior.
Em seguida, definimos a demanda por sangue usando $D_{ta}$, o número de unidades de sangue necessárias para pacientes com o atributo $a$ no instante $t$, com $D_t = (D_{ta})_{a\in\Acal}$.
As variáveis de estado são dadas por
\[S_t = (R_t,D_t).\]Variáveis de decisão
Atuamos sobre os recursos de sangue com decisões dadas por $d$, um tipo de decisão, que inclui decisões de dar sangue a um paciente com o atributo $a\in\Acal$, ou não fazer nada e manter o sangue, o que representamos por $d^\phi$; e $\Dcal$, o conjunto de todas as decisões possíveis, $\Dcal = \Acal \cup d^\phi$.
Em seguida, seja $x_{tbd}$ o número de unidades de sangue com o atributo $b$ sobre as quais atuamos com uma decisão do tipo $d$ no instante $t$, com $x_t = (x_{tbd})_{b\in\Bcal,d\in\Dcal}$.
A região viável $\Xcal_t$ é definida pelas seguintes restrições:
\[\begin{align} \sum_{d\in\Dcal} x_{tbd} &= R_{tb}, \quad b\in\Bcal, \label{eq:blood1}\\ \sum_{b\in\Bcal} x_{tbd} &\leq \Dhat_{td}, \quad d\in\Dcal,\label{eq:blood2}\\ x_{tbd} &\geq 0. \label{eq:blood3} \end{align}\]Informação exógena
A informação que chega depois de tomarmos uma decisão é dada pelas doações de sangue, que representamos usando $\Rhat_{t+1,b}$, o número de novas unidades de sangue do tipo $b$ doadas entre $t$ e $t+1$, com $\Rhat_{t+1} = (\Rhat_{t+1,b})_{b\in\Bcal}$.
As novas demandas de sangue são modeladas usando $\Dhat_{t+1,a}$, as unidades de demanda com o atributo $a$ que surgiram entre $t$ e $t+1$, com $\Dhat_{t+1} = (\Dhat_{t+1,a})_{a\in\Acal}$.
Nossa variável de informação exógena seria
\[W_{t+1} = (\Rhat_{t+1}, \Dhat_{t+1}).\]Função de transição
O sangue que é mantido simplesmente envelhece uma semana, mas limitamos a idade a seis semanas. O sangue que é alocado para satisfazer uma demanda pode ser modelado como sendo movido para um sumidouro de tipo sanguíneo, denotado, talvez, usando $b_{t,1} = \phi$ (o tipo sanguíneo nulo). A função de transição de atributos de sangue $b^M(b_t,d_t)$ é dada por
\[b_{t+1} = \begin{pmatrix} b_{t+1,1} \\ b_{t+1,2} \end{pmatrix} = \begin{cases} \begin{pmatrix} b_{t,1} \\ \min\{6,b_{t,2}+1\} \end{pmatrix}, & d_t = d^\phi, \\[8pt] \begin{pmatrix} \phi \\ - \end{pmatrix}, & d_t \in\Dcal. \end{cases}\]Para representar a função de transição, é útil definir
\[\delta_{b'}(b,d) = \begin{cases} 1 & b^x_t = b' = b^M(b_t,d_t),\\ 0 & \text{otherwise,} \end{cases}\]e seja $\Delta$ a matriz com $\delta_{b’}(b,d)$ na linha $b’$ e coluna $(b,d)$.
Observamos que a função de transição de atributos é determinística. Um elemento aleatório surgiria, por exemplo, se inspeções do sangue resultassem em sangue com menos de seis semanas de idade sendo considerado como vencido. A função de transição de recursos pode agora ser escrita como
\[R^x_{tb'} = \sum_{b\in\Bcal}\sum_{d\in\Dcal} \delta_{b'}(b,d) x_{tbd}, \qquad R_{t+1,b'} = R^x_{tb'} + \Rhat_{t+1,b'}.\]Na forma matricial, elas seriam escritas como
\[\begin{align} R^x_t &= \Delta x_t, \label{eq:bloodresourcetransition1}\\ R_{t+1} &= R^x_t + \Rhat_{t+1}. \label{eq:bloodresourcetransition2} \end{align}\]As demandas $D_{t+1}$ são simplesmente observadas a partir das novas demandas $\Dhat_{t+1}$, então escrevemos isso como
\[D_{t+1} = \Dhat_{t+1}.\]A Figura 13.1 ilustra as transições que ocorrem na semana $t$. Ou precisamos decidir qual tipo de sangue usar para satisfazer uma demanda (Figura 13.1a), ou manter o sangue até a semana seguinte. Se usarmos o sangue para satisfazer uma demanda, considera-se que ele é perdido do sistema. Se mantivermos o sangue até a semana seguinte, ele é transformado em sangue com uma semana a mais de idade. O sangue com seis semanas de idade não pode ser usado para satisfazer nenhuma demanda, então podemos considerar o compartimento de sangue com seis semanas de idade como um sumidouro para sangue inutilizável (o valor desse sangue seria zero). Observe que as doações de sangue são consideradas como chegando com idade 0.
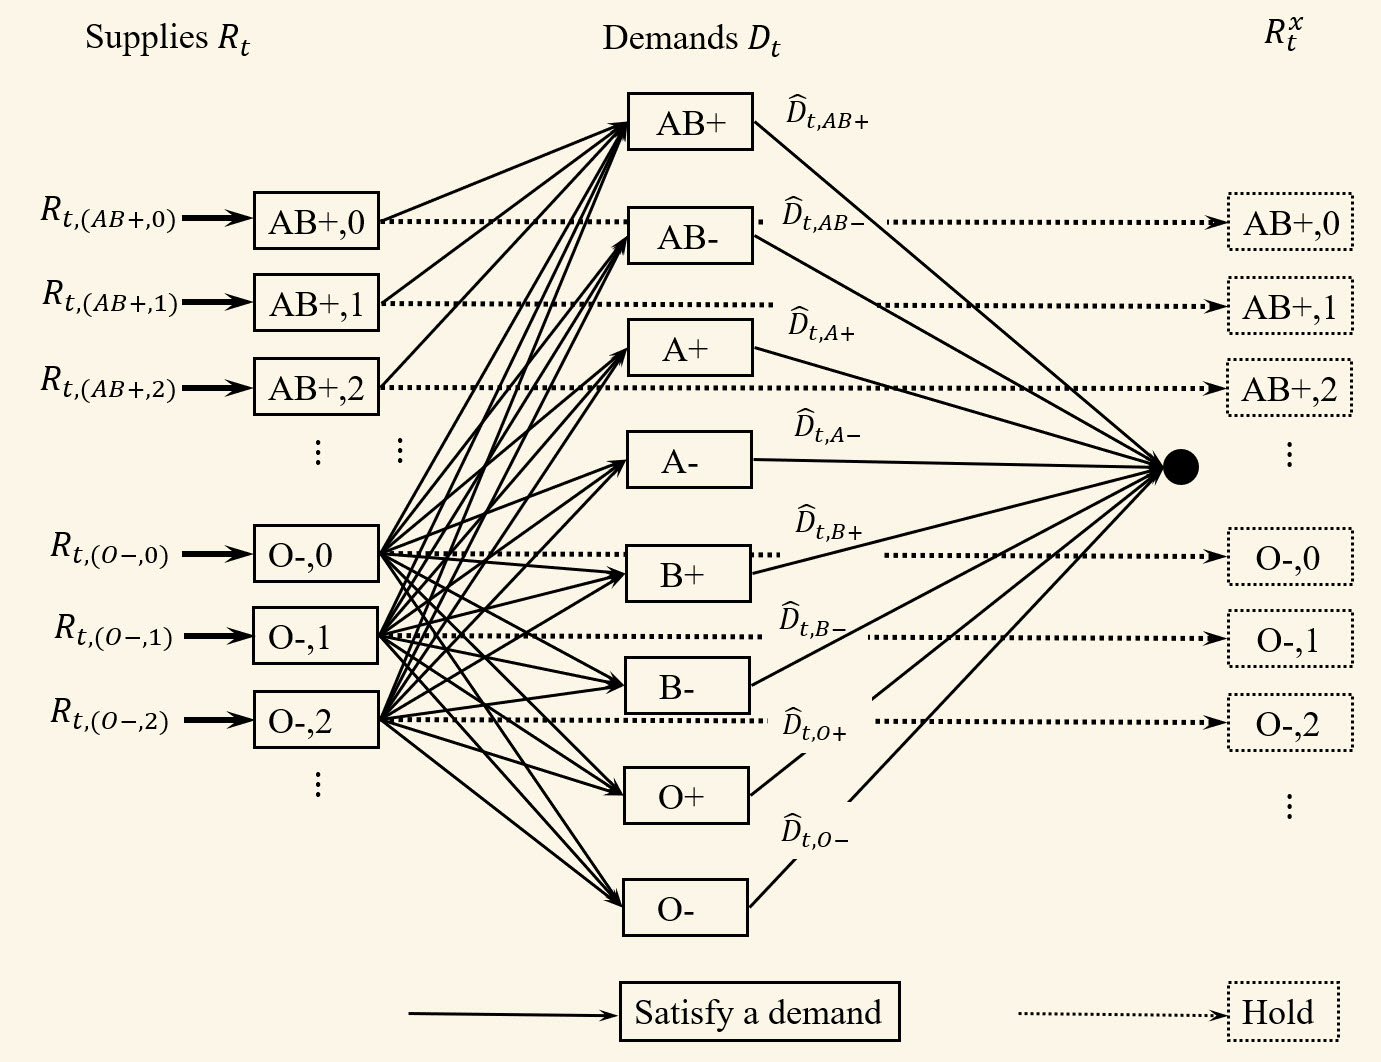
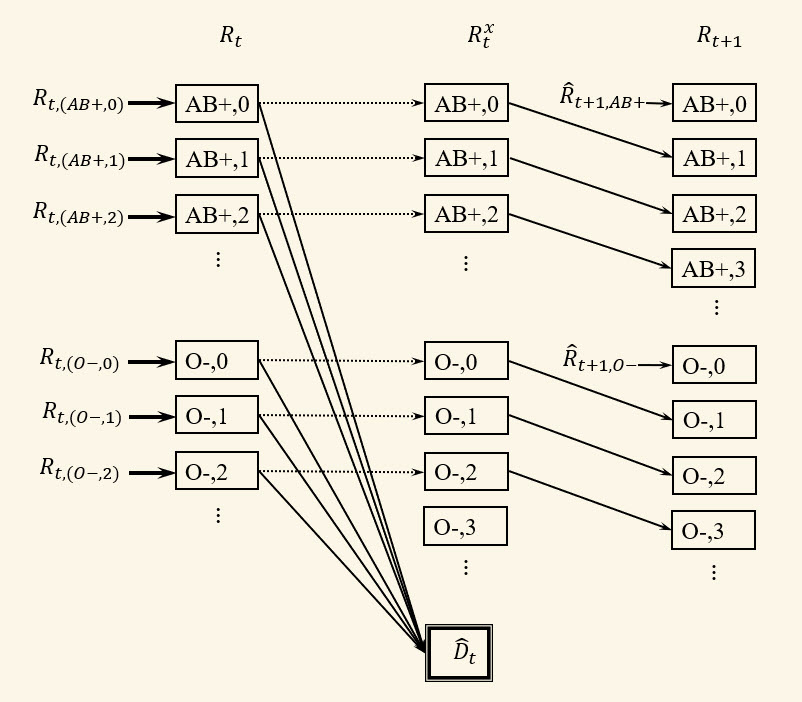
Os modelos representados pela Figura 13.1 são bastante úteis para problemas de alocação de recursos. Usamos esse modelo com bastante sucesso para otimizar a alocação de produtos manufaturados entre centros de distribuição, e para otimizar a alocação de caminhões, vagões de carga e locomotivas no transporte de cargas. É preciso ter cuidado ao estimar as aproximações da função de valor, mas, uma vez estimadas, seu uso produz sequências de problemas de rede muito pequenos, como os mostrados na figura.
Função objetivo
Não há um “custo” real na alocação de sangue de um tipo para a demanda de outro tipo (não estamos considerando etapas como gastar dinheiro para incentivar doações adicionais, ou transportar estoques de um hospital para outro). Em vez disso, usamos a função de contribuição para capturar as preferências do médico. Gostaríamos de capturar a preferência natural de que geralmente é melhor não substituir, e que satisfazer uma demanda urgente é mais importante do que uma demanda eletiva.
Por exemplo, poderíamos usar as contribuições descritas na Tabela 13.2. Assim, se usarmos sangue $O-$ para satisfazer as necessidades de um paciente eletivo com sangue $A+$, obteríamos uma contribuição de -$10 (penalidade, pois é negativa) por substituir o sangue, um +$5 por usar sangue $O-$ (algo que os hospitais gostam de incentivar), e uma contribuição de +$20 por atender a uma demanda eletiva, totalizando uma contribuição de +$15.
| Condição | Descrição | Valor |
|---|---|---|
| se $d = d^\phi$ | Manutenção | 0 |
| se $b_1 = b_1$ quando $d\in\Dcal$ | Sem substituição | 0 |
| se $b_1 \neq b_1$ quando $d\in\Dcal$ | Substituição | -10 |
| se $b_1 = O-$ quando $d\in\Dcal$ | Substituição de $O-$ | 5 |
| se $d_2 = $ Urgente | Atendimento de demanda urgente | 40 |
| se $d_2 = $ Eletiva | Atendimento de demanda eletiva | 20 |
Tabela 13.2. Contribuições para diferentes tipos de sangue e decisões.
A contribuição total (no instante $t$) é finalmente dada por
\[C_t(S_t,x_t) = \sum_{b\in\Bcal}\sum_{d\in\Dcal} c_{tbd} x_{tbd}.\]Como antes, seja $X^\pi_t(S_t)$ uma política (algum tipo de regra de decisão) que determina $x_t\in\Xcal_t$ dado $S_t$. Desejamos encontrar a melhor política resolvendo
\[\begin{align} \max_{\pi\in\Pi} \E \sum_{t=0}^T C_t(S_t,X^\pi(S_t)), \label{eq:bloodobjective} \end{align}\]onde $S_{t+1} = S^M(S_t,X^\pi(S_t),W_{t+1})$.
Modelando a incerteza
As fontes de incerteza neste problema são as doações de sangue e a chegada de novas cirurgias que requerem doações de sangue. Algumas questões que precisamos considerar ao modelar essa incerteza incluem:
- Não há apenas aleatoriedade no número de unidades de sangue doadas, mas também no tipo de sangue.
- Existem padrões tanto de dia da semana quanto sazonais nas doações de sangue, bem como respostas a apelos que, é claro, representam uma decisão.
- A chegada de novas cirurgias pode ocorrer em surtos devido ao clima ou à violência.
- Há uma incompatibilidade consistente entre os tipos de pessoas que doam sangue e os tipos de pessoas que precisam de cirurgias, o que se manifesta em diferenças na distribuição dos tipos sanguíneos.
- Uma questão importante é a gestão da substituição de tipos sanguíneos. Muita atenção é dada à capacidade de usar sangue $O-$ para qualquer pessoa, mas há diferentes tipos de substituição para todos os tipos sanguíneos.
Projetando políticas
Vamos começar com uma política míope básica e, em seguida, fazer a transição para uma que dependa da aproximação do valor dos estoques de sangue no futuro.
Uma política míope
A maneira mais óbvia de resolver esse problema é uma política míope simples, na qual maximizamos a contribuição a cada ponto no tempo sem considerar o efeito de nossas decisões sobre o futuro. Podemos obter uma família de políticas míopes ajustando as contribuições de um único período.
Por exemplo, nosso bônus de $5 por usar sangue tipo $O-$ (na Tabela 13.2) é, na verdade, um tipo de política míope. Incentivamos o uso de sangue tipo $O-$ pois ele geralmente é mais disponível do que outros tipos sanguíneos. Ao alterarmos esse bônus, obtemos diferentes tipos de políticas míopes que podemos representar pelo conjunto $\Pi^M$, onde para $\pi\in\Pi^M$ nossa função de decisão seria dada por
\[\begin{align} X^\pi_t(S_t) = \argmax_{x_t\in\Xcal_t} \sum_{b\in\Bcal} \sum_{d\in\Dcal} c_{tbd}x_{tbd}. \label{eq:bloodmyopic} \end{align}\]O problema de otimização em $\eqref{eq:bloodmyopic}$ é um programa linear simples. Buscar entre as políticas no problema de otimização dado pela equação $\eqref{eq:bloodobjective}$ significa buscar entre diferentes valores do bônus para o uso de sangue tipo $O-$.
Uma política VFA
Como um programa dinâmico tradicional, o problema de otimização apresentado na equação $\eqref{eq:bloodobjective}$ é bastante desafiador. A variável de estado $S_t$ tem $\vert \Acal\vert + \vert \Bcal\vert = 8 \times 6 + 8 \times 2 \times 2 = 80$ dimensões. As variáveis aleatórias $\Rhat$ e $\Dhat$ também possuem, combinadas, 80 dimensões. O vetor de decisão $x_t$ tem $27 + 8 = 35$ dimensões.
É natural usar aproximações de função de valor para determinar o vetor de alocação $x_t$ usando
\[\begin{align} x^n_t = \argmax_{x_t\in\Xcal^n_t} \big(C_t(S^n_t,x_t) + \Vbar^{x,n-1}_t(R^x_t) \big), \label{eq:adpblood} \end{align}\]onde $R^x_t = R^M(R_t,x_t)$ é dado pela equação $\eqref{eq:bloodresourcetransition1}$ e onde $\Xcal^n_t$ é definido pelas restrições $\eqref{eq:blood1}$–$\eqref{eq:blood3}$. A restrição-chave é $\eqref{eq:blood1}$, que limita a disponibilidade de suprimentos de sangue de cada tipo.
O primeiro (e mais importante) desafio que enfrentamos é identificar uma estratégia de aproximação apropriada para $\Vbar^{x,n-1}_t(R^x_t)$. Uma aproximação simples e eficaz é usar aproximações lineares por partes separáveis, ou seja
\[\Vbar^x_t(R^x_t) = \sum_{b\in\Bcal} \Vbar^x_{tb}(R^x_{tb}),\]onde $\Vbar^x_{tb}(R^x_{tb})$ é uma função escalar, linear por partes, no estoque pós-decisão $R^x_{tb}$ para cada tipo de sangue $b$.
É fácil mostrar que a função de valor é côncava (bem como linear por partes), portanto cada $\Vbar^x_{tb}(R^x_{tb})$ também deveria ser côncava. Sem perda de generalidade, podemos assumir que $\Vbar^x_{tb}(R^x_{tb}) = 0$ para $R^x_{tb} = 0$, o que significa que a função é completamente caracterizada por seu conjunto de inclinações. Podemos escrever a função usando
\[\begin{align} \Vbar^{n-1}_{tb}(R^x_{tb}) = \left(\sum_{r=1}^{\lfloor R^x_{tb}\rfloor} \vbar^{n-1}_{tb}(r-1) + (R^x_{tb} - \lfloor R^x_{tb}\rfloor) \vbar^{n-1}_{tb}(\lfloor R^x_{tb}\rfloor)\right), \label{eq:pwl} \end{align}\]onde $\lfloor R \rfloor$ é o maior número inteiro menor ou igual a $R$. Como podemos ver, essa função é determinada pelo conjunto de inclinações $(\vbar^{n-1}_{tb}(r))$ para $r = 0, 1, \ldots, R^{max}$, onde $R^{max}$ é um limite superior no número de recursos de um determinado tipo.
A maneira como estimamos as inclinações em $\Vbar_t(R_t)$ é criar a função objetivo para o problema no instante $t$
\[\begin{align} \Vtilde_{t}(S_t) = \max_{x_t\in\Xcal^n_t} \big(C_t(S^{n}_t,x_t) + \Vbar^{x,n-1}_t(R^x_t) \big). \label{eq:bloodvtile} \end{align}\]Quando resolvemos esse programa linear, obtemos estimativas do valor marginal de uma unidade adicional de sangue do tipo $a$ dada por $R^n_{ta}$. Vamos chamar esse valor de $\vhat^n_{ta}$, que está imediatamente disponível a partir de qualquer pacote de programação linear (e obtemos isso para cada tipo de sangue $a$ ao mesmo tempo).
Alternativamente, poderíamos calcular o valor marginal de forma mais precisa criando um vetor de recursos perturbado $R^{n+}_{ta} = R^n_{ta} +1$. Seja $\Xcal^{n+}_t(a)$ a região viável (composta pelas equações $\eqref{eq:blood1}$–$\eqref{eq:blood3}$) na qual usamos $R^{n+}_{ta}$ em vez de $R^n_{ta}$ para um único atributo $a$, e seja $\Vtilde^+_{ta}(S_t)$ igual a $\Vtilde_t(S_t)$, exceto pela região viável $\Xcal^{n+}_{ta}$ com o recurso perturbado $R^{n+}_{ta}$ em vez de $R^n_{ta}$. Podemos então encontrar os valores marginais $\vhat^n_{ta}$ usando
\[\vhat^n_{ta} = \Vtilde^+_{ta}(S_t) - \Vtilde_t(S_t).\]Observe que temos que calcular $\Vtilde^+_{ta}(S_t)$ para cada $a$ (enquanto, com variáveis duais, obtemos todo o conjunto de valores marginais de uma só vez).
Em seguida, usamos $\vhat^n_{ta}$ para atualizar a aproximação da função de valor pós-decisão anterior $\vbar^{x,n}_{t-1,a}$, o que é feito com
\[\vbar^{x,n}_{t-1,a}(R^{x,n}_{t-1,a}) = (1-\alpha) \vbar^{x,n-1}_{t-1,a}(R^{x,n}_{ta}) + \alpha \vhat^n_{ta}.\]Podemos mostrar que as inclinações $\vbar^{x,n}_{ta}(R^{x,n}_{ta})$ diminuem à medida que $R^{x,n}_{ta}$ aumenta, então é útil manter isso. Podemos fazer isso com métodos como os algoritmos CAVE ou Leveling (veja Reinforcement Learning and Stochastic Optimization, Seção 18.3).
Assumindo que possamos estimar essa função, o problema de otimização que precisamos resolver (equação $\eqref{eq:adpblood}$) é o programa linear bastante modesto mostrado na Figura 13.2. Assim como na Figura 13.1, temos que considerar tanto a atribuição de diferentes tipos de sangue a diferentes tipos de demanda, quanto a decisão de reter sangue em estoque.
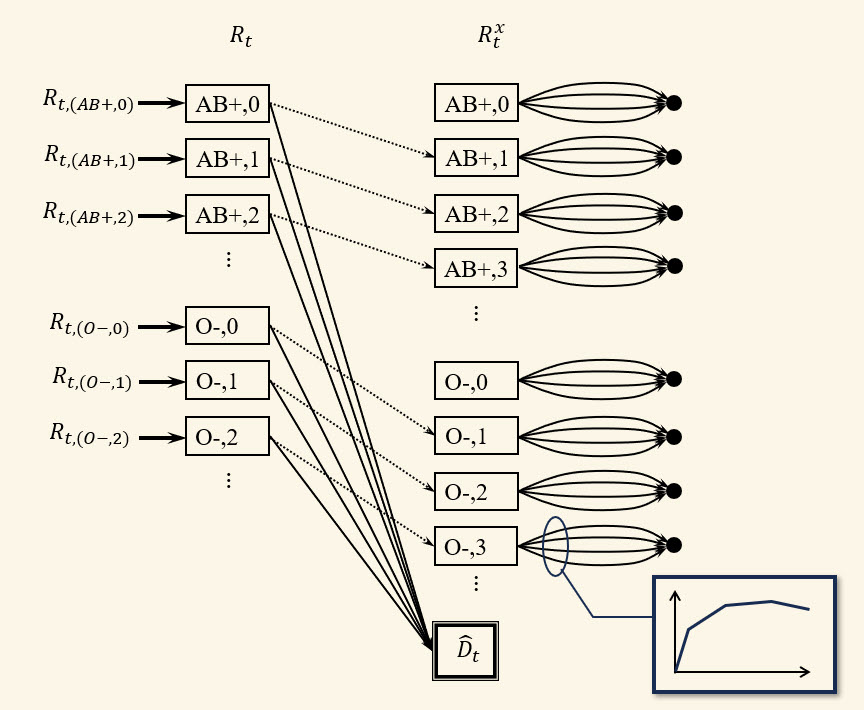
Para simplificar a figura, colapsamos a rede de diferentes tipos de demanda em uma única caixa agregada com demanda $\Dhat_t$. Essa rede na verdade se pareceria exatamente com a rede na Figura 13.1a. A decisão de reter sangue em estoque precisa considerar o valor de um tipo de sangue (incluindo sua idade) no futuro, o que estamos aproximando usando funções de valor lineares por partes separáveis.
Aqui, usamos um truque de modelagem padrão que converte as aproximações de função de valor lineares por partes separáveis em uma série de arcos paralelos de cada nó representando um elemento de $R^x_t$ até um superssorvedouro. Funções lineares por partes não são apenas fáceis de resolver (basta ter acesso a um solucionador de programação linear), como também são fáceis de estimar. Além disso, para muitas classes de problemas (mas não todas), constatou-se que produzem convergência muito rápida com soluções de alta qualidade.
Com essa função de decisão, vamos usar um método chamado iteração de valor aproximada, no qual simulamos para frente iterativamente ao longo dos períodos de tempo $t=0, \ldots, T$. Seja $n = 1, \ldots, N$ o contador de iterações, no qual seguimos uma trajetória amostral da informação exógena $W^n_t,~t=0, \ldots, T$ (que pode ser extraída de dados históricos ou amostrada de uma distribuição). No instante $t$, iteração $n$, usamos a equação $\eqref{eq:adpblood}$ para tomar uma decisão $x^n_t$ quando estamos no estado $S^n_t$. Em seguida, observamos $W^n_{t+1}$ e usamos nossa função de transição (equações $\eqref{eq:bloodresourcetransition1}$–$\eqref{eq:bloodresourcetransition2}$) para a transição de $R^n_t$ para $R^n_{t+1}$. Quando no estado $S^n_t = (R^n_t, \Dhat^n_t)$, usamos nossa política VFA na equação $\eqref{eq:adpblood}$ para calcular $x^n_t$, e então calculamos $\vhat^n_t$ para atualizar as inclinações $\vbar^{x,n}_{t-1}$. Em seguida, observamos $W^n_{t+1}$ (que contém $\Dhat^n_{t+1}$) para transitar para o estado $S^n_{t+1}$.
Para a maioria das aplicações operacionais, esse problema seria resolvido em um horizonte finito (digamos, 10 semanas), fornecendo-nos uma recomendação do que fazer agora. Podemos usar as aproximações de função de valor $\Vbar^x_t(R^x_t)$ para simular a política diversas vezes, o que pode ser usado para produzir uma forma de previsão probabilística dos estoques futuros.
Extensões
Este é um problema de alocação de recursos rico e complexo que pode ser estendido de diversas maneiras. Abaixo estão alguns exemplos.
1) Assumimos que quaisquer demandas não satisfeitas no instante $t$ são perdidas. Imagine que temos cirurgias de emergência que precisam ser satisfeitas, e cirurgias eletivas que podem ser adiadas para um período de tempo posterior. Escreva a variável de estado para o novo problema.
2) Suponha que cirurgias eletivas possam ser adiadas. Considere usar uma aproximação de função de valor que seja linear por partes e separável nos estoques de sangue (esta é a VFA sugerida acima), juntamente com VFAs lineares por partes e separáveis para a quantidade de demanda retida (por tipo sanguíneo). Usamos as variáveis duais do estoque de sangue para atualizar a VFA dos suprimentos de sangue. Como poderíamos atualizar a VFA para a demanda retida?
3) Inclua a presença de sangue que foi congelado, e a decisão de congelar sangue, sendo que o sangue congelado não utilizado deve ser descartado. Isso significa que precisamos reconhecer que a quantidade de sangue necessária para uma cirurgia é desconhecida antes da cirurgia, quando a decisão de descongelar o sangue precisa ser tomada.
4) Um hospital pode exigir entregas semanais de sangue de um banco de sangue comunitário para compensar escassezes sistemáticas. Imagine que uma quantidade fixa (por exemplo, 100 unidades) de sangue chega toda semana, mas a quantidade de sangue de cada tipo e idade (o sangue pode já ter sido mantido em estoque por várias semanas) pode ser aleatória.
5) Apresentamos um modelo que se concentrava apenas nos estoques de sangue em um único hospital. Podemos lidar com múltiplos hospitais e centros de distribuição simplesmente adicionando um atributo de localização, e fornecendo uma decisão de mover sangue (a um custo) de um local para outro.
Este modelo também pode ser aplicado a qualquer problema de estoque multiproduto no qual existam diferentes tipos de produto e diferentes tipos de demandas, desde que tenhamos a capacidade de escolher qual tipo de produto é atribuído a cada tipo de demanda. Também assumimos que os produtos não são reutilizáveis; uma vez que o produto é atribuído a uma demanda, ele é perdido do sistema.
O que aprendemos?
- Introduzimos um problema de alocação de recursos multidimensional que possui um espaço de estados extremamente grande, mas oferece a estrutura de concavidade que podemos explorar na aproximação das funções de valor.
- Mostramos como modelar um problema de alocação de recursos multiatributo, o que torna bastante fácil introduzir atributos adicionais.
- Ilustramos uma política míope básica, na qual o impacto a jusante das decisões tomadas agora é ignorado.
- Em seguida, descrevemos uma política VFA na qual exploramos a concavidade natural do problema para sugerir uma aproximação baseada em aproximações de função de valor lineares por partes separáveis.
- Nossa política VFA precisaria ser implementada em base rolante, então nossa política é, na verdade, um DLA estocástico, usando uma política VFA para a política de horizonte de previsão. Isso é paralelo ao nosso uso de programação dinâmica para resolver o problema de caminho mais curto determinístico, que representou uma aproximação do nosso problema de caminho mais curto estocástico e dinâmico no Capítulo 6.
Exercícios
Questões de revisão
- Qual é a dimensionalidade da variável de estado $S_t$?
- Qual é a dimensionalidade do vetor de decisão $x_t$?
- Quais são a(s) fonte(s) de incerteza?
- Descreva a natureza dos custos na função objetivo. De onde eles vêm?
- Qual é a limitação de uma política puramente míope? Que comportamento você buscaria em uma política melhor?
- Como o uso de funções de valor melhora a solução?
Questões de resolução de problemas
Gestão de sangue - Parte I: Modelagem - Vamos considerar o problema de gestão de sangue, mas vamos assumir que há apenas um tipo de sangue, embora ainda vamos modelar o processo de envelhecimento, no qual o sangue pode ter de 0 a 5 semanas de idade. Qualquer sangue com 5 semanas de idade que seja mantido em estoque deve ser descartado. Como no livro, existem dois tipos de pacientes: urgentes e eletivos. Seja:
$R_{t\tau}$ Número de unidades de sangue disponíveis no instante $t$ que foram mantidas em estoque por $\tau$ períodos de tempo, $\tau = 0, \ldots, 5$. $\Rhat_t$ Novas doações de sangue que chegam entre $t-1$ e $t$, onde $\Rhat_t$ é um escalar. $\Dhat^{urgent}_t$ Novas demandas urgentes que chegam no instante $t$. $\Dhat^{elective}_t$ Novas demandas eletivas que chegam no instante $t$. No instante $t$, precisamos decidir:
$x^{urgent}_t$ Quantidade de sangue a ser atribuída a pacientes urgentes. $x^{elective}_t$ Quantidade de sangue a ser atribuída a pacientes eletivos. $x^{hold}_t$ Quantidade de sangue a ser mantida em estoque. $x_t$ $(x^{urgent}_t,x^{elective}_t,x^{hold}_t)$. As demandas não precisam ser cobertas, embora a real questão seja se devemos cobrir uma demanda eletiva agora (assumindo que há sangue suficiente para cobrir todas as demandas urgentes) ou reter o sangue em estoque para uma potencial demanda urgente no futuro. Como antes, assuma que quaisquer demandas não atendidas saem do sistema.
Seu objetivo é maximizar uma função de utilidade que atribui um crédito de 10 para cada paciente urgente atendido e 5 para cada paciente eletivo atendido.
- Qual é a variável de estado deste problema?
- Quais são as variáveis de decisão e a informação exógena?
- Qual é a função de transição?
- Qual é a função objetivo? Suponha que possamos simular a política em um simulador.
- Crie uma função de custo aproximada parametrizada que atribua os seguintes custos a cada decisão: $c^{urgent}$, penalidade por não atender um paciente urgente; $c^{elective}$, penalidade por não atender um paciente eletivo; e $c^{discard}$, penalidade por descartar sangue que exceda a idade de 5 semanas. Como sua política, suponha que você vá minimizar esses custos a cada período de tempo. Trate o vetor $c=(c^{urgent},c^{elective},c^{discard})$ como um conjunto de parâmetros ajustáveis. Descreva como otimizar o vetor $c$ usando um algoritmo de gradiente estocástico. Certifique-se de fornecer a equação para calcular o gradiente estocástico.
- Gestão de sangue - Parte II: Programação dinâmica aproximada regressiva - Vamos agora projetar uma política baseada na ideia de aproximar a função de valor usando programação dinâmica aproximada regressiva. Isso significa que você precisa especificar um modelo linear para aproximar $V^x_t(S^x_t)$. Os detalhes desse modelo não são tão importantes, mas você pode usar algo como
$$
\Vbar^x_t(S^x_t) = \thetabar_{t0} + \sum_{age=0}^5 \theta_{t1,age} R^{urgent,x}_{t,age} + \sum_{age=0}^5 \theta_{t2,age} R^{elective,x}_{t,age}.
$$
Para os fins deste exercício, você pode simplesmente escrever $\Vbar^x_t(S^x_t) = (\theta_t)^T \phi(S^x_t)$ onde $\theta_t$ é um vetor coluna de coeficientes e $\phi(S^x_t)$ é um vetor coluna de características.
- Defina o estado pós-decisão e use-o para escrever a equação de Bellman que caracteriza uma política ótima. Você precisará escrever uma expressão para o valor $V_t(S_t)$ de estar no estado pré-decisão $S_t$ no tempo $t$ em termos do valor $V^x_t(S^x_t)$ de estar no estado pós-decisão $S^x_t$. Em seguida, você precisará escrever uma expressão para $V^x_t(S^x_t)$ em termos de $V_{t+1}(S_{t+1})$. Suponha que as unidades de sangue sejam sempre inteiras.
- Qual é a dimensionalidade das variáveis de estado pré-decisão e pós-decisão? Devemos nos preocupar com o tamanho do espaço de estados?
- Escreva um pseudocódigo detalhado que descreva como estimar as aproximações da função de valor para este problema ao longo de um horizonte finito $0, \ldots, T$. Pense nisso como um exercício de programação sem a programação real. Ele precisa ser detalhado o suficiente para que você possa entregá-lo a um colega de classe do curso (e familiarizado com o material), que então poderia escrever o código.
- Escreva a política usando sua expressão para a função de valor aproximada.
- Gestão de sangue - Parte III: Política de horizonte de previsão - Desta vez, vamos supor que temos previsões contínuas de suprimentos e demandas. Seja $f^R_{tt'}$ a previsão de doações de sangue no tempo $t'$ feita usando o que sabemos no tempo $t$. Sejam $f^{D,urgent}_{tt'}$ e $f^{D,elective}_{tt'}$ as previsões de novas demandas urgentes e eletivas que chegam no tempo $t'$ dado o que sabemos no tempo $t$. Suponha que as previsões sejam fornecidas exogenamente (ou seja, não precisamos modelar como as previsões evoluem de $t$ para $t+1$). Você pode usar
$$
\begin{align*}
f^R_t &= (f^R_{tt'})_{t'=t+1}^T, \\
f^{D,urgent}_t &= (f^{D,urgent}_{tt'})_{t'=t+1}^T, \\
f^{D,elective}_t &= (f^{D,elective}_{tt'})_{t'=t+1}^T, \\
f_t &= (f^R_t,f^{D,urgent}_t,f^{D,elective}_t).
\end{align*}
$$
Seja $\sigma^R_{t'-t}$ o desvio padrão do erro entre as doações reais $\Rhat_{tt'}$, que assumimos ser conhecido com base no desempenho passado. Assumimos que isso é puramente uma função de quão distante no futuro estamos planejando, dado por $t'-t$. Da mesma forma, sejam $\sigma^{D,urgent}_{t'-t}$ e $\sigma^{D,elective}_{t'-t}$ os desvios padrão dos erros nas previsões de novas demandas urgentes e eletivas.
- Modele os cinco elementos de um problema de decisão sequencial para este cenário. Você deve conseguir copiar elementos de uma das partes anteriores para este problema. Sinta-se à vontade para referenciar quaisquer equações pelo número que desejar reutilizar. A principal mudança é a inclusão das previsões.
- Escreva uma política DLA usando um horizonte de previsão determinístico com previsões como estimativas pontuais de quaisquer doações e demandas futuras.
- Agora projete uma política parametrizada onde você substitui cada previsão por uma que esteja um determinado número de desvios padrão acima (ou abaixo) da previsão pontual. Use três parâmetros, que você pode designar $\theta = (\theta^R, \theta^{urgent}, \theta^{elective})$. Escreva o problema de encontrar o melhor valor para $\theta$ como um problema de otimização. Explique quaisquer suposições que você precise fazer em sua formulação.
- Sua função objetivo na parte (c) envolve aproximar uma expectativa. Você pode fazer isso por meio de simulação, onde você simularia um caminho amostral $\omega$ ao longo de um horizonte de $T$ períodos de tempo. O que significa $\omega$?
- Forneça as fórmulas para calcular a média e a variância amostral do desempenho de uma política a partir de $L$ simulações usando caminhos amostrais $\omega^1, \ldots, \omega^L$.
- Suponha que você represente o conjunto de valores possíveis do vetor $\theta$ pela amostra $\theta^1, \ldots, \theta^K$. Descreva um método de busca usando estimativa de intervalo parametrizado por $\lambda^{IE}$ (no livro usamos $\theta^{IE}$, mas isso cria muitos $\theta$'s). Você precisará descrever seu modelo de crença e como ele é atualizado a cada vez que você executa uma simulação usando $\theta = \theta^k$. Suponha que você tenha um orçamento de $N$ simulações, e que $\lambda^{IE}$ seja conhecido.
Questões de programação
Estes exercícios usam o módulo Python BloodManagement em tinyurl.com/sdagithub.
Nosso objetivo é gerenciar a atribuição de diferentes tipos sanguíneos a diferentes pacientes, que são caracterizados primeiro por seu próprio tipo sanguíneo e, segundo, por se a cirurgia é urgente ou eletiva.
Este exercício fará com que você trabalhe com duas classes de políticas: uma função de custo aproximada paramétrica míope e uma política baseada em aproximações de função de valor.
Vamos começar supondo que você vai apenas combinar diferentes tipos sanguíneos com diferentes demandas. O sangue é descrito por tipo sanguíneo (dos quais há oito) e idade, que variará de 0 a 2 semanas (sangue com 3 semanas de idade é descartado). Os pacientes são descritos por tipo sanguíneo e se a cirurgia é urgente ou eletiva. Há vários bônus e penalidades que orientam as atribuições. Por exemplo, há bônus positivos por atender pacientes urgentes (este é o mais alto). Também há um bônus por combinar tipos sanguíneos exatamente (por exemplo, sangue A-positivo com um paciente A-positivo), e uma penalidade por descartar sangue depois que ele fica velho demais.
Se ignorarmos o impacto das decisões de agora no futuro, temos um programa linear simples que combina suprimentos e demandas, com custos dados por este conjunto de bônus. O problema é que, ao ignorar o impacto das decisões de agora no futuro, podemos descobrir que não estamos fazendo o melhor que podemos. Um problema que surge é quando usamos sangue agora para cirurgia eletiva, estamos ignorando que isso pode ser útil de manter caso fiquemos sem sangue para cirurgia urgente mais tarde. Alternativamente, podemos usar sangue O- agora em vez de guardá-lo para o futuro, quando podemos ficar sem outros tipos sanguíneos.
Seja $R_{ta}$ o suprimento de sangue com atributo $a$ para a semana $t$, e seja $R_t = (R_{ta})_{a\in\Acal}$ onde $\Acal$ é o conjunto de todos os diferentes atributos de sangue (tipo sanguíneo e idade). Da mesma forma, seja $D_{tb}$ os atributos de um paciente onde $b$ captura o tipo sanguíneo e se a cirurgia é urgente ou eletiva, e seja $D_t = (D_{tb})_{b\in\Bcal}$. O estado do nosso sistema é $S_t = (R_t,D_t)$.
Agora seja $\Rhat_{t+1,a}$ o número de unidades de sangue com atributo $a$ que foram doadas entre as semanas $t$ e $t+1$. Da mesma forma, seja $\Dhat_{t+1,b}$ o número de novas chegadas de pacientes com atributo $b$. Escreveríamos
$$ W_{t+1} = (\Rhat_{t+1,a},\Dhat_{t+1,b}). $$Finalmente, seja $\omega$ que representa um caminho amostral $W_1(\omega), \ldots, W_T(\omega)$ de doações e novos pacientes ao longo do nosso horizonte de $T$ semanas. Suponha que tenhamos criado um conjunto de simulações de $W_t$, e seja $\Omega=(\omega_1, \ldots, \omega_N)$ este conjunto de realizações amostrais.
- Quantas dimensões tem a variável de estado $S_t$?
- Seja $X^\pi(S_t\vert \theta)$ o resultado da resolução do programa linear dado o estado $S_t$, onde $\theta$ é o vetor de todos os bônus e penalidades para diferentes atribuições. Seja $D^{urgent}_t(x_t)$ o número de pacientes urgentes que foram atendidos dado o vetor de decisão $x_t$, e seja $D^{elective}_t(x_t)$ o número de pacientes eletivos que foram atendidos. Escreva o problema de encontrar o melhor valor de $\theta$ como um problema de otimização, onde, em vez de nossa expectativa usual, você o escreverá como uma média sobre os caminhos amostrais em $\Omega$.
- Vamos considerar um conjunto de dados onde há uma probabilidade de que a demanda ocasionalmente tenha um surto. Você pode definir essa probabilidade na planilha. Defina essa probabilidade de surto para 50 por cento. Há uma penalidade especial por usar sangue para atender cirurgia eletiva, para incentivar o modelo míope a guardar sangue para cirurgia urgente que possa ter um aumento de demanda mais tarde. Encontre o melhor valor para essa penalidade no conjunto $\lbrace -4,-9,-14,-19,-24\rbrace $ após executar 20 iterações de teste.
- Sem realizar nenhum trabalho numérico adicional, imagine agora que a penalidade sobre o sangue O-negativo precisa depender da semana para lidar com variações sazonais. Como você está simulando 15 semanas, descreva um método para otimizar sobre um vetor de 15 dimensões (descrevemos duas estratégias centrais em tarefas anteriores - você pode escolher uma, ou inventar uma nova).
Agora vamos mudar para uma política baseada em VFA, onde usamos o valor marginal de cada tipo sanguíneo (e idade) que é mantido para o futuro. Isso será feito com um algoritmo de aprendizado adaptativo que foi descrito na seção de política VFA acima (e muito semelhante à nossa estratégia de ADP para o problema do caminho mais curto, exceto que agora estamos fazendo isso para um problema onde a decisão é um vetor).
Defina a penalidade por usar sangue em eletivas como 0. Ao usar uma política baseada em VFA, o VFA deve aprender que o sangue urgente em excesso ao suprimento pode ser necessário no futuro. Ao usar a política VFA, você precisará executar 20 iterações de treinamento para estimar as funções de valor. Depois que estas forem estimadas, você então executará 20 iterações de teste para avaliar a qualidade da política.
Vamos testar nossas políticas para um conjunto de dados onde há uma probabilidade de que a demanda ocasionalmente tenha um surto. Você pode definir essa probabilidade na planilha. Comece definindo essa probabilidade de surto para 0,7.
- O algoritmo de aprendizado adaptativo requer estimar o valor marginal de cada tipo sanguíneo. Seja $\vhat^n_{ta}$ nossa estimativa do valor marginal do tipo sanguíneo $a$ para a semana $t$ enquanto simulamos o caminho amostral $\omega^n$. Seja $\Vbar^{n-1}_t(R_{ta})$ nossa estimativa, após $n-1$ iterações, do valor marginal da $r$-ésima unidade de sangue onde $r = R^x_{ta}$ no final da semana $t$ (esta é nossa variável de estado "pós-decisão"). Lembre-se de que usamos $\vhat^n_{ta}$ para atualizar a aproximação da função de valor em torno da variável de estado pós-decisão anterior. Escrevemos este processo de atualização como $$ \Vbar^n_{t-1,a}(R^{x,n}_{t-1,a}) = (1-\alpha) \Vbar^{n-1}_{t-1,a}(R^{x,n}_{t-1,a}) + \alpha \vhat^n_{ta}. $$ Nossa primeira tarefa é ajustar $\alpha$. Execute o algoritmo de programação dinâmica aproximada por 20 iterações (é assim que a planilha está configurada) para $\alpha \in \lbrace 0, 0.05, 0.1, 0.2, 0.3\rbrace $ e relate os resultados. Observe que um tamanho de passo $\alpha = 0$ é o mesmo que manter a aproximação da função de valor igual a zero (em outras palavras, a política míope). Se $\alpha = 0$, você não precisa treinar os VFAs, então você só precisa executar as 20 iterações de teste para avaliar a política. Quão bem a política VFA se sai em relação à política míope (correspondente a $\alpha = 0$)?
- Agora mude a probabilidade de surto para zero e compare a política míope com a política VFA usando um tamanho de passo de $\alpha = 0.2$. Como estas se comparam? Você consegue explicar o comportamento para este conjunto de dados em comparação com quando havia surtos?