Capítulo 1: Modelagem de problemas de decisão sequencial
O processo de resolver qualquer problema físico (e em particular qualquer problema de decisão sequencial) no computador requer a construção de um modelo matemático, como ilustrado na Figura 1.1. Por décadas, a comunidade de pesquisa tem utilizado uma estrutura matemática padrão para problemas de decisão em que todos os dados são conhecidos com antecedência (conhecida como otimização determinística). Uma versão simples de um problema de otimização determinística, conhecida como programa linear, pode ser escrita
\[\begin{align} \min_x c^T x, \label{eq:linearprogram1} \end{align}\]onde $x$ é um vetor de elementos que precisam satisfazer um conjunto de restrições que tipicamente são escritas
\[\begin{align} A x & = b, \label{eq:linearprogram2}\\ x & \geq 0. \label{eq:linearprogram3} \end{align}\]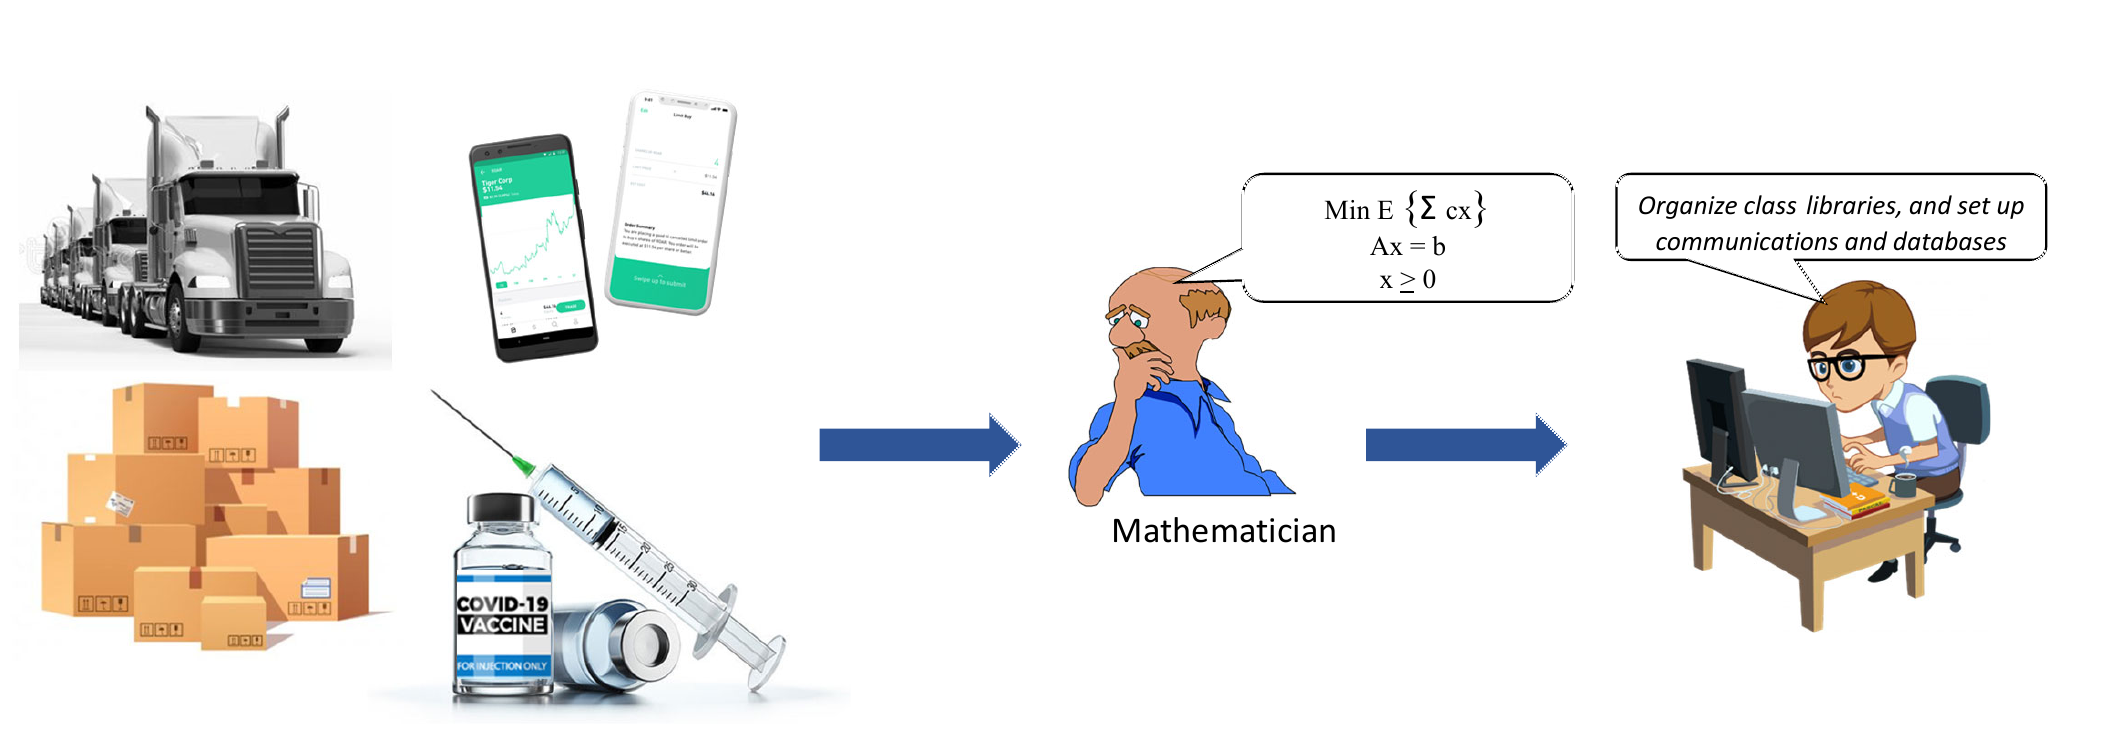
Não é necessário entender as equações $\eqref{eq:linearprogram1}$–$\eqref{eq:linearprogram3}$ (o que requer familiaridade básica com álgebra linear), mas milhares de estudantes se formam a cada ano em cursos onde aprendem essa notação, e também aprendem como traduzir uma ampla gama de problemas físicos para essa notação. Depois, existem pacotes de software que traduzem problemas nesse formato para uma solução. Mais importante ainda, essa linguagem notacional é falada ao redor do mundo. A mesma afirmação pode ser feita sobre modelagem estatística/aprendizado de máquina, que hoje é uma comunidade muito maior do que as pessoas que entendem as equações $\eqref{eq:linearprogram1}$–$\eqref{eq:linearprogram3}$.
Não podemos fazer a mesma afirmação sobre problemas de decisão sequencial, que constituem uma classe de problemas estudada por pelo menos 15 comunidades diferentes usando oito estilos notacionais fundamentalmente diferentes, muitas vezes utilizando matemática que requer treinamento avançado. Neste livro, usamos um estilo de ensino por exemplos para mostrar como modelar a classe incrivelmente rica de problemas que chamamos de problemas de decisão sequencial. Embora foquemos em problemas relativamente mais simples, nossa estrutura pode ser usada para modelar qualquer problema de decisão sequencial. Além disso, o modelo resultante pode ser traduzido diretamente para software.
A fundação analítica deste livro está contida em Reinforcement Learning and Stochastic Optimization: A unified framework for sequential decisions (RLSO), que é um texto de nível de pós-graduação centrado em metodologia. De tempos em tempos, faremos referência a material contido nesse livro para leitores que possam se interessar por maior profundidade, e encorajamos leitores com inclinação técnica a usar o RLSO como referência. No entanto, isso não é necessário. Este livro foi projetado para fornecer o contexto de fundo na forma de uma série de exemplos que devem permitir que os leitores pensem de forma clara e precisa sobre problemas de decisão sequencial, mesmo que nunca venham a escrever uma linha de código.
Este livro é voltado para estudantes de graduação ou de mestrado que tenham cursado uma disciplina de probabilidade e estatística (não é necessário conhecimento de programação linear, embora tenhamos um exemplo que requer a resolução de um programa linear). Todos os capítulos são construídos em torno de exemplos específicos, com exceção do capítulo 1, que fornece uma visão geral de toda a estrutura de modelagem, e do capítulo 7, onde fazemos uma pausa e usamos os seis primeiros capítulos para ilustrar alguns princípios importantes.
A apresentação não deve exigir matemática além do que seria esperado em um primeiro curso de probabilidade e estatística. Dito isso, o livro é centrado em mostrar como descrever problemas de decisão sequencial usando notação suficientemente precisa para que possa servir de base para software de computador.
Módulos em Python acompanham a maioria dos capítulos; esses módulos foram escritos em torno da estrutura de modelagem que perpassa todo o livro. Ao mesmo tempo, qualquer pacote de software que simule um problema de decisão sequencial, independentemente de como esteja sendo resolvido, pode ser traduzido diretamente para a estrutura de modelagem que usamos. Por essa razão, encorajamos os leitores a olhar para qualquer peça de notação como uma variável em um programa de computador.
Começando
Problemas de decisão sequencial sempre podem ser escritos como
\[decision,\ information, \ decision, \ information, \ decision, \ldots\]Cada vez que tomamos uma decisão, incorremos em um custo ou recebemos uma contribuição ou recompensa (há muitas formas de medir desempenho). As decisões são tomadas usando um método que chamaremos de política. Um objetivo importante e foco central deste livro é projetar políticas eficazes que funcionem bem ao longo do tempo, na presença da incerteza de informações que ainda não chegaram.
Problemas de decisão sequencial são onipresentes, surgindo em praticamente todo processo humano. A Tabela 1.1 fornece uma lista de amostra de áreas, com exemplos de algumas das decisões que podem surgir. A maioria dessas áreas provavelmente possui muitos tipos diferentes de decisões, variando em complexidade desde quando vender um ativo ou adotar um novo design de site, até escolher o melhor medicamento, material ou instalação a projetar, ou gerenciar cadeias de suprimentos complexas ou despachar uma frota de caminhões.
| Área | Questões |
|---|---|
| Negócios | Quais produtos devemos vender, com quais características? Quais fornecedores devemos usar? Que preço devemos cobrar? |
| Economia | Que taxa de juros o Federal Reserve deveria cobrar dado o estado da economia? Que níveis de liquidez de mercado deveriam ser fornecidos? |
| Finanças | Em quais ações uma carteira deveria investir? Como um trader deveria proteger um contrato contra possíveis perdas? |
| Internet | Quais anúncios devemos exibir para maximizar os cliques em anúncios? Quais filmes atraem mais atenção? Quando/como avisos em massa devem ser enviados? |
| Engenharia | Como projetar dispositivos, de latas de aerossol a veículos elétricos, de pontes a sistemas de transporte, de transistores a computadores? |
| Saúde pública | Como devemos conduzir testes para estimar a progressão de uma doença? Como as vacinas devem ser alocadas? Quais grupos populacionais devem ser priorizados? |
| Pesquisa médica | Qual configuração molecular produzirá o medicamento que mata mais células cancerígenas? Que conjunto de etapas é necessário para produzir nanotubos de parede simples? |
| Gestão da cadeia de suprimentos | Quando devemos fazer um pedido de estoque proveniente da China? Qual fornecedor deve ser usado? |
| Transporte de carga | Qual motorista deve transportar uma carga? Quais cargas uma transportadora de carga completa deve se comprometer a mover? Onde os motoristas devem ser alocados? |
| Coleta de informação | Para onde devemos enviar um drone para coletar informações sobre incêndios florestais ou espécies invasoras? Qual medicamento devemos testar para combater uma doença? |
| Sistemas multiagentes | Como uma grande empresa em um mercado oligopolista deveria licitar contratos, antecipando a resposta de seus concorrentes? |
| Algoritmos | Qual regra de tamanho de passo devemos usar em um algoritmo de busca? Como determinamos o próximo ponto para avaliar uma função dispendiosa? |
Tabela 1.1. Uma amostra de diferentes áreas e decisões que precisam ser tomadas dentro de cada área.
Ainda mais desafiador do que listar todos os tipos de decisões é identificar as diferentes fontes de incerteza que surgem em muitas aplicações. O comportamento humano, os mercados, os processos físicos, as redes de transporte, os sistemas de energia e o amplo leque de incertezas que surgem na saúde apontam para a diversidade de diferentes fontes de incerteza.
Enquanto este livro está sendo escrito, a humanidade luta contra a propagação de variantes da COVID-19. Lidar com essa pandemia foi descrito como “de complexidade estonteante” [USA Today, 8 de setembro de 2020], mas isso é, na verdade, um subproduto do fracasso em pensar sobre o problema de forma estruturada. Vamos mostrar ao leitor como decompor problemas em uma série de componentes básicos que levam a soluções práticas.
Nossa abordagem começa identificando alguns elementos centrais, como métricas de desempenho, decisões e fontes de incerteza, o que então leva à criação de um modelo matemático do problema. O próximo passo geralmente (mas nem sempre) é implementar o modelo no computador, mas haverá muitos problemas em que o processo de construir um modelo computacional é impraticável por diversos motivos. Por essa razão, também vamos considerar problemas em que precisamos testar e avaliar ideias no campo. Para melhorar o desempenho, primeiro precisamos aprender a tomar boas decisões ao longo do tempo (é assim que controlamos o sistema). Em seguida, passamos ao design do sistema.
Neste momento, a comunidade acadêmica ainda não adotou um processo de modelagem padrão para problemas de decisão sequencial. Isso contrasta fortemente com a área de problemas de otimização estáticos e determinísticos, que seguem uma estrutura rígida desde os anos 1950 (as equações $\eqref{eq:linearprogram1}$–$\eqref{eq:linearprogram3}$ representam uma amostra dessa estrutura). Nosso processo de modelagem é baseado na apresentação do RLSO, que é um livro voltado para um público técnico primariamente interessado em desenvolver e implementar modelos no computador.
Em contraste, este livro é voltado para um público mais amplo que está, antes de tudo, interessado em aprender a pensar sobre problemas de decisão sequencial. Ele usa um estilo de ensino por exemplos que se concentra em comunicar o processo de modelagem, o qual acreditamos ser útil mesmo sem, ao final, criar modelos computacionais. Central à nossa abordagem está a criação de um modelo matemático que elimina a ambiguidade ao descrever problemas em inglês simples. Para os leitores interessados em desenvolver modelos computacionais, a notação é o degrau para escrever software. No entanto, vamos usar principalmente a notação matemática para criar clareza ao descrever um problema, mesmo que o leitor nunca pretenda escrever uma linha de código.
Nossa apresentação segue da seguinte forma:
- O Capítulo 1 fornece uma introdução leve à estrutura de modelagem universal, ilustrada usando dois problemas de estoque (um simples e outro ligeiramente mais complexo), seguida de uma breve discussão sobre a modelagem da incerteza. Em seguida, apresenta as quatro classes de políticas que cobrem todos os métodos para tomar decisões.
- Os capítulos 2–6 descrevem, cada um, um problema de decisão sequencial específico para ilustrar a estrutura de modelagem usando um estilo de ensino por exemplos. Essas aplicações foram escolhidas para evidenciar cada uma das quatro classes de políticas.
- O Capítulo 7 retorna à estrutura de modelagem universal com mais detalhes. É apresentada uma discussão muito mais cuidadosa das quatro classes de políticas, bem como dos diferentes tipos de variáveis de estado, usando os exemplos dos capítulos 2–6 para fornecer contexto.
- Os capítulos 8–14 fornecem exemplos adicionais, usando cenários mais complexos para ilustrar conceitos de modelagem mais avançados, cobrindo tanto a modelagem de incerteza (em particular a modelagem de preços de eletricidade no Capítulo 8) quanto um conjunto mais rico de políticas.
Os capítulos de aplicação (2–6 e 8–14) seguem todos o mesmo esquema. Eles podem ser abordados em qualquer ordem, tendo em mente que as aplicações nos capítulos 2–6 são mais simples e foram escolhidas para ilustrar cada uma das quatro classes de políticas. Leitores interessados em tópicos específicos de modelagem (como variáveis de estado, modelagem de incerteza ou ver diferentes exemplos de políticas) podem folhear os capítulos, indo diretamente aos tópicos que lhes interessam.
Cada capítulo termina com uma série de exercícios divididos em três categorias:
- Questões de revisão – São perguntas simples que podem ser usadas para reforçar uma compreensão básica a partir da leitura do capítulo.
- Questões de resolução de problemas – Estas introduzem desafios de modelagem que exigem habilidades de resolução de problemas.
- Questões de programação – A maioria dos capítulos tem exercícios de programação que se baseiam em um conjunto de módulos Python. Os módulos Python originais, escritos em Python 2, se beneficiaram de uma grande atualização feita pelo Professor Dennis Djanka, professor da Universidade de Karlsruhe, na Alemanha. A nova biblioteca pode ser baixada em tinyurl.com/sdagithub. Algumas dessas questões exigem fazer modificações de programação no código Python.
Afinal, o que é uma decisão?
Há uma longa história, que remonta a mais de 2.000 anos, aos tempos de Sócrates, Aristóteles e Platão, documentando o estudo de como as pessoas tomam decisões. Depois há uma literatura substancial, principalmente a partir da década de 1950 (mas com alguns trabalhos importantes anteriores), sobre a matemática de tomar decisões ótimas, consistindo em muitos milhares de artigos e livros. O que essa literatura parece negligenciar é a pergunta básica:
O que é uma decisão?
Começamos com a observação de que uma decisão é uma forma de informação que afeta o comportamento de algum “sistema” que buscamos controlar. Implícita nesse sistema está uma ou mais medidas que quantificam o quão bem nosso sistema está performando. Precisamos então identificar um agente que controla algum aspecto do nosso sistema.
Dado esse fundamento, ajuda identificar três classes de informação:
- O estado de conhecimento – Esta é a informação que temos agora e que é relevante para a performance do nosso sistema.
- Informação que altera o estado de conhecimento que controlamos (isso requer identificar um agente controlador para nosso sistema).
- Informação que chega ao nosso sistema e altera o estado de conhecimento, mas que está além do nosso controle.
Nos referimos à informação da classe 2 como decisões. Isso sugere uma definição formal de decisão, baseada em Bridging Decision Problems, Volume I: Framing the Problem:
Definição (formal): Uma decisão é uma classe de informação endogenamente controlável.
Uma definição informal poderia ser:
Definição (informal): Uma decisão é informação que controlamos.
Essas definições oferecem um ponto de partida, mas não aprendemos muito com elas. Muito mais interessante é identificar exemplos específicos de decisões, o que faremos a seguir.
Tipos de decisões
Identificamos 10 tipos de decisões com base nos contextos e nas ferramentas que podemos usar para determinar as melhores decisões. São elas:
1) Decisões físicas e financeiras – Essas decisões surgem na gestão de recursos físicos e financeiros, como pessoas, equipamentos, instalações, produtos, água, energia, bem como recursos financeiros como caixa ou investimentos. As decisões incluem comprar, vender e modificar recursos, em que uma modificação pode significar movê-lo de um local para outro, reparar equipamentos, treinar uma pessoa ou combinar ingredientes para fazer um bolo.
2) Decisões complexas/estratégicas – São decisões que podem fazer múltiplas mudanças em um sistema (alterando recursos, parâmetros, crenças) e que tipicamente envolvem fontes significativas de incerteza. Essas decisões são normalmente avaliadas uma única vez, mas pode existir a opção de esperar e tomar a decisão mais tarde.
3) Decisões de aquisição/observação de informação – Incluem decisões como executar experimentos em laboratório, testes de campo ou simulações computacionais. Pode incluir realizar pesquisa de mercado, contratar um especialista ou perguntar a um modelo de linguagem de grande porte.
4) Decisões de comunicação/compartilhamento de informação – Essas vêm em duas formas:
- a) Mensagens – Isso reflete o que dizemos em texto, vídeo e/ou áudio.
- b) Canais e temporização – Isso cobre a escolha de como enviar a informação: texto/e-mails, publicação (impressa ou online), redes sociais ou canais de publicidade. Também requer escolher a temporização e a frequência.
5) Métricas de performance e objetivos – Representam a escolha crítica de quantificar o que estamos tentando alcançar, como maximizar receitas, minimizar custos, minimizar doenças ou maximizar votos recebidos.
6) Escolha de funções – Podem ser métodos para tomar decisões (políticas), a formulação de modelos de otimização, a escolha de métricas de performance, métodos de previsão ou estimação, ou o design de funções de transição (como a forma que uma doença se espalha).
7) Definição de parâmetros – Frequentemente há vários parâmetros que afetam a performance de um sistema. Podem ser preços, os coeficientes em um modelo estatístico, a temperatura usada em um processo de fabricação. Podem ser o peso atribuído a uma métrica de performance, ou metas de performance.
8) Estimação ou identificação – Podemos precisar identificar uma pessoa, prever a demanda ou nomear uma doença.
9) Características e comportamentos – Como projetar um produto, quais características um pacote de software deve ter, quais serviços devem ser fornecidos a um cliente, ou o curso de graduação de um estudante, que determina com quais habilidades ele se forma.
10) Decidir o que decidir – Embora geralmente não usemos análise formal para essa última decisão, é importante reconhecer quando estamos tomando uma decisão, e se queremos abordá-la formalmente usando análise de dados e modelagem.
Implícito na identificação de decisões está a compreensão de como a decisão afeta a performance do sistema. Mover recursos físicos (tipo 1) vem com um custo, enquanto satisfazer demandas traz receitas. Uma decisão pode ter um impacto imediato em uma ou mais métricas de performance (como frequentemente ocorre na gestão de recursos), mas frequentemente as decisões precisam ser avaliadas ao longo do tempo, e dependem de informação que não é conhecida no momento em que a decisão é tomada. Por essa razão, frequentemente estamos avaliando como estamos tomando decisões (isto é, o método) em vez da decisão em si.
Enquadrando o problema
O primeiro passo ao abordar um problema de decisão envolve responder a três perguntas:
- Quais são as métricas de performance?
- Que tipos de decisões estão sendo tomadas (e quem as toma)?
- Quais são as incertezas que afetam a performance?
Note que as respostas a essas perguntas são fundamentais para qualquer problema de decisão. Neste livro, essas perguntas parecerão bastante simples, porque as respondemos no contexto dos modelos que já projetamos para resolver um problema. Em aplicações reais, as listas de métricas de performance, decisões e incertezas podem ser bastante longas.
Como uma amostra da riqueza que o enquadramento de um problema pode assumir, encorajamos o leitor a consultar a monografia Framing the Problem, que é dedicada exatamente a esse tópico. A monografia tem capítulos inteiros dedicados a cada uma dessas perguntas, ilustrados usando uma dúzia de aplicações diferentes.
O objetivo do processo de enquadramento é identificar o que importa, começando pelas métricas de performance, em que até mesmo um problema simples de estoque pode ser descrito com mais de 20 métricas de performance, 30 diferentes tipos de decisões e mais de 30 tipos de incertezas. A planilha listando essas informações pode ser encontrada em tinyurl.com/PowellInventoryDecisions. Isso não significa que de fato construiremos um modelo com toda essa complexidade. Por essa razão, o livro introduz um recurso chamado matrizes de interação, em que um especialista de domínio prioriza as métricas e, então, usa julgamento para identificar as decisões e incertezas que têm o maior impacto sobre as métricas mais importantes.
Este livro assume que já reduzimos um problema a um pequeno número de métricas, decisões e incertezas, e usa essas para focar o desenvolvimento de um modelo matemático.
O processo de modelagem
Modelagem é uma arte, mas é uma arte guiada por uma estrutura matemática que garante que obtenhamos um problema bem definido que possamos colocar no computador e resolver. Isso pode ser visto como construir uma ponte de um problema do mundo real confuso e mal definido para algo com a clareza que um computador consegue entender, mesmo que seu objetivo final não seja colocá-lo no computador.
Historicamente, se um esforço de modelagem envolvesse tentar tomar decisões, as pessoas recorreriam ao conhecido framework de otimização determinística, que frequentemente se parece com o modelo dado pelas equações $\eqref{eq:linearprogram1}$–$\eqref{eq:linearprogram3}$, que consiste em variáveis de decisão $x$, uma função objetivo $cx$, e as restrições dadas por $\eqref{eq:linearprogram2}$–$\eqref{eq:linearprogram3}$.
O problema com esse framework clássico de modelagem é o que ele deixa de fora:
- Ele assume que todos os dados (contidos nas variáveis $A$, $b$ e $c$) que caracterizam o modelo são conhecidos perfeitamente.
- A maioria das decisões ocorre repetidamente ao longo do tempo, e ainda assim não há reconhecimento disso.
- Não há como representar o fluxo de informação para o sistema.
- Como subproduto, a solução ótima para esse modelo não consegue antecipar eventos que afetam a performance de $x$ na prática.
- Não há como representar risco, uma questão importante em muitas aplicações.
- Ele assume um único tomador de decisão.
Modelos matemáticos devem, antes de tudo, fornecer um caminho que nos diga como pensar sobre os problemas. Os modelos clássicos de otimização determinística que seguem o formato das equações $\eqref{eq:linearprogram1}$–$\eqref{eq:linearprogram3}$ ignoram completamente qualquer coisa relacionada à evolução do nosso problema ao longo do tempo.
Este livro é inteiramente projetado em torno de uma abordagem de modelagem chamada framework universal de modelagem. Em suma, ela aspira a representar qualquer aspecto de um sistema controlável. Nosso modelo padrão assumirá que o sistema evolui ao longo do tempo, à medida que nova informação chega.
Nesta seção, vamos fornecer uma versão bastante compacta do framework universal de modelagem. Depois vamos ilustrar o framework, inicialmente usando um problema de estoque muito simples, mas depois introduzindo algumas extensões modestas. Após apresentar esses exemplos, vamos retornar a uma apresentação mais detalhada do framework universal de modelagem.
Uma apresentação compacta de um modelo dinâmico
Começamos observando que podemos modelar qualquer problema de decisão sequencial usando a sequência
\[(S_0,x_0,W_1,S_1,x_1,W_2, \ldots, S_t, x_t, W_{t+1}, \ldots, S_T),\]onde:
- $S_t$ são as variáveis de estado que capturam tudo o que precisamos para:
- a) Tomar uma decisão no tempo $t$.
- b) Calcular as métricas de performance no tempo $t$.
- c) Qualquer outra informação necessária para calcular (a) ou (b) em qualquer ponto no futuro.
É melhor pensar em $S_t$ como o estado da informação ou, de forma mais geral, o estado de conhecimento, no tempo $t$.
- $x_t$ representa variáveis de decisão que capturam os elementos que controlamos, como se devemos vender uma casa, o caminho através de uma rede, a escolha de medicamento para um tratamento, o preço pelo qual vender um produto, ou a escolha de caminhão para mover uma carga de frete.
-
$W_{t+1}$ é a informação que chega depois de tomarmos a decisão $x_t$, que pode ser o preço final de venda de uma casa, os tempos de viagem através de uma rede, como um paciente responde a um medicamento, as vendas de um produto a um preço, e as cargas de frete solicitadas depois que fazemos as atribuições iniciais. Vemos a informação em $W_{t+1}$ como vinda de fora do nosso sistema, o que significa que está fora do nosso controle. Por essa razão, nos referimos a ela como informação exógena.
Há muitas situações em que é melhor pensar em $W_{t+1}$ como uma função $W_{t+1}(S_t,x_t)$ que depende do estado atual $S_t$ e/ou da decisão $x_t$. Discutimos isso com mais detalhes abaixo. Vamos usar $W_{t+1}$ como nossa notação padrão, mas com o entendimento de que ela pode ser influenciada pelo estado $S_t$ ou pela decisão $x_t$.
A decisão $x_t$ é determinada por algum método que chamamos de política, que denotamos $X^\pi(S_t)$. A notação $\pi$ carrega informação sobre a estrutura da função, que representamos por $f$ em um conjunto de funções potenciais $\Fcal$, e quaisquer parâmetros ajustáveis $\theta\in\Theta^f$, que é definido pela estrutura da função. Por exemplo, uma política de estoque pode ser pedir $\theta^{order}$ unidades sempre que o estoque cair abaixo de $\theta^{min}$, o que significa que os parâmetros ajustáveis são $\theta = (\theta^{order}, \theta^{min})$. A estrutura da função seria um exemplo de uma função $f$.
Assumimos que temos uma função de transição que recebe como entrada o estado $S_t$, a decisão $x_t$ e a informação exógena $W_{t+1}$ e nos fornece o estado atualizado $S_{t+1}$. Funções de transição são um conjunto de equações que atualizam cada elemento da variável de estado $S_t$, que pode ter apenas um elemento, ou dezenas de milhares (ou muito mais).
Incorremos em uma contribuição (ou custo) $C(S_t,x_t)$ quando tomamos a decisão $x_t=X^\pi(S_t)$ dada a informação no estado $S_t$. Nosso objetivo é encontrar a política que maximize algum objetivo que dependa das contribuições $C(S_t,x_t)$ onde $x_t=X^\pi(S_t)$. Para configurações mais complexas, $C(S_t,x_t)$ pode, na verdade, ser um conjunto de métricas de desempenho, embora precisemos combiná-las de alguma forma para identificar qual decisão $x_t$ escolher.
Esta é uma descrição muito compacta de um problema de decisão sequencial. A seguir, descrevemos um conjunto de etapas a seguir no processo de modelagem.
As etapas no processo de modelagem
É possível dividir todo o processo de modelagem em sete etapas (para os nossos propósitos). Precedendo essas etapas (identificada abaixo como “Etapa 0”) há um breve resumo da complexidade técnica da aplicação para ajudar a orientar os leitores.
Etapa 0. Resumo do capítulo – Abrimos cada capítulo com um resumo do que o capítulo vai cobrir e, em alguns casos, como ele se relaciona com o material de outros capítulos. Os resumos indicam quais abordagens são usadas para modelar a incerteza e as políticas que são usadas.
Etapa 1. A narrativa – Esta será uma descrição em inglês simples do problema. A narrativa não fornecerá todas as informações necessárias para criar um modelo matemático; em vez disso, é um primeiro passo que deve dar ao modelador a visão geral sem se perder na notação.
Etapa 2. Enquadrando o problema – Isso consiste em responder a três perguntas:
- Quais são as métricas de desempenho?
- Que tipos de decisões estão sendo tomadas (e, em alguns casos, qual agente as está tomando)?
- Quais são as fontes de incerteza que afetam o desempenho?
Etapa 3. Identificando os elementos centrais do problema, com ênfase especial em três dimensões de qualquer problema de decisão sequencial. Esses elementos são descritos sem usar matemática:
- Quais métricas estamos tentando impactar? Campos individuais (como gestão de cadeia de suprimentos, saúde, energia, finanças) serão cada um caracterizados por uma série de métricas que podem ser descritas usando termos como custos, receitas, lucros, recompensas, ganhos, perdas, desempenho e risco.
- Quais decisões estão sendo tomadas? Identificar decisões é bastante fácil para muitos problemas, como jogos de computador, mas se abordarmos um problema complexo, como responder a um processo de saúde pública, reduzir a pegada de carbono ou gerenciar uma cadeia de suprimentos, então identificar todas as decisões pode ser bastante desafiador.
- Quais são as diferentes fontes de incerteza? Sobre o que estamos incertos antes de começar? Que informação chega exogenamente ao longo do tempo (ou seja, chega depois que tomamos uma decisão)? A Tabela 1.2 ilustra diferentes fontes de incerteza para um modelo de distribuição de vacinas contra a COVID (veja RLSO, Capítulo 10, para uma apresentação de 12 classes de incerteza).
Referimo-nos ao processo de responder a essas três perguntas como enquadrando o problema.
| Tipo de incerteza | Descrição |
|---|---|
| 1) Erros de observação | Observar pessoas com sintomas; erros ao classificar pessoas com sintomas como tendo COVID |
| 2) Incerteza exógena | Relatos de novos casos, mortes; disponibilidade de UTIs; produção real de vacinas |
| 3) Incerteza prognóstica | Internações hospitalares; desempenho futuro das vacinas; resposta da população às vacinas |
| 4) Incerteza inferencial | Estimativas de taxas de infecção; estimativas da eficácia das vacinas |
| 5) Incerteza experimental | Desempenho de medicamentos em um ensaio clínico; número de pessoas sendo vacinadas |
| 6) Incerteza de modelo | Taxas de transmissão de doenças; disseminação geográfica de infecções |
| 7) Incerteza transicional | Adições/retiradas de/para estoques de vacinas |
| 8) Incerteza de controle | Quais grupos populacionais foram vacinados; alocações de vacinas |
| 9) Incerteza de implementação | Falha em vacinar |
| 10) Erros de comunicação | Erros de relato do campo; falha em notificar quando ser vacinado |
| 11) Incerteza de objetivo | Divergências sobre quem deve ser vacinado |
| 12) Incerteza ambiental | Se/quando uma vacina será aprovada; alocação de vacinas para diferentes estados, países |
Tabela 1.2. Ilustração de diferentes tipos de incerteza que surgem na resposta de vacinação à pandemia de COVID.
Etapa 4. O modelo matemático – Aqui construímos sobre os três primeiros elementos da Etapa 2, mas agora precisamos criar um modelo matemático que consiste em cinco dimensões que se aplicam a todo problema de decisão sequencial:
- Variáveis de estado $S_t$ – A variável de estado captura tudo o que você precisa saber no tempo $t$ para tomar uma decisão no tempo $t$, calcular custos e restrições e, se necessário, simular seu caminho até o tempo $t+1$. Variáveis de estado podem incluir informações sobre recursos físicos (estoques ou a localização de um veículo que entram no problema através de restrições), outras informações (como custos ou preços que entram na função objetivo) e crenças sobre quantidades e parâmetros que não conhecemos perfeitamente (como previsões ou estimativas de como um paciente responderia a um medicamento).
-
Variáveis de decisão $x_t$ – Elas descrevem como vamos projetar ou controlar nosso sistema. Decisões precisam satisfazer restrições que escrevemos como $x_t \in \Xcal$ onde $\Xcal$ pode ser um conjunto de escolhas discretas, ou um conjunto de equações lineares. As decisões serão determinadas por políticas que são funções (ou regras) que designamos por $X^\pi(S_t)$ que determinam $x_t$ dado o que está na variável de estado. Políticas podem ser muito simples (compre-baixo, venda-alto) ou bastante complexas.
O índice $\pi$ carrega informação sobre o tipo de função que é usada para tomar decisões, e quaisquer parâmetros ajustáveis. Seja $f\in\Fcal$ a estrutura da função, $\Fcal$ o conjunto de funções possíveis, e seja $\theta\in\Theta^f$ quaisquer parâmetros ajustáveis para a função $f$. Nossa política seria então representada como $\pi = (f,\theta)$. Frequentemente escreveremos a política como $X^\pi(S_t\vert \theta)$ para indicar a dependência dos parâmetros ajustáveis.
Retornaremos a isso com considerável detalhe mais adiante neste capítulo, e ao longo do livro. Cada um dos exemplos apresentados no livro foi escolhido para ajudar a ilustrar tipos específicos de políticas.
- Informação exógena $W_{t+1}$ – Esta é a nova informação que chega depois que tomamos a decisão $x_t$ (mas antes de decidirmos $x_{t+1}$), como quanto vendemos depois de definir um preço, ou o tempo para completar o caminho que escolhemos. Quando tomamos uma decisão no tempo $t$, a informação em $W_{t+1}$ é desconhecida, então a tratamos como uma variável aleatória quando estamos escolhendo $x_t$.
- A função de transição $S^M(S_t,x_t,W_{t+1})$ – Estas são as equações que descrevem como as variáveis de estado evoluem ao longo do tempo. Para muitos problemas reais, funções de transição capturam toda a dinâmica do problema, e podem ser bastante complexas. Em alguns casos, nem sequer conhecemos as equações, e precisamos depender apenas das variáveis de estado que podemos observar. Escrevemos a evolução das variáveis de estado $S_t$ usando nossa função de transição como
onde $S^M(\cdot)$ é conhecido como o modelo de transição de estado (ou sistema) (daí o $M$ no sobrescrito). A função de transição descreve como cada elemento da variável de estado muda dadas as decisões $x_t$ e a informação exógena $W_{t+1}$. Em problemas complexos, a função de transição pode exigir milhares de linhas de código para ser implementada.
-
A função objetivo – Isso captura as métricas de desempenho que usamos para avaliar nosso desempenho, e fornece a base para a busca sobre políticas. Deixamos $C(S_t,x_t)$ denotar a contribuição (se maximizando) ou custo (se minimizando) da decisão $x_t$ que pode depender da informação em $S_t$. Em algumas configurações, é mais natural escrever a função de contribuição de período único como $C(S_t,x_t,W_{t+1})$, a função de contribuição avaliada no final do intervalo de tempo $(t,t+1)$, após $W_{t+1}$ ter sido observado. Por exemplo, podemos fazer um pedido de $x_t$ que chega imediatamente para atender à demanda incerta contida em $W_{t+1}$.
Nosso objetivo é encontrar a melhor política $X^\pi(S_t)$ para otimizar alguma métrica, tal como:
- Maximizar a soma esperada de contribuições ao longo de algum horizonte.
- Maximizar o desempenho esperado de um design final que aprendemos ao longo de várias experiências ou observações.
- Minimizar o risco associado a um design final.
Nossa forma mais comum de escrever a função objetivo é
onde “$\E$” é chamado de operador de expectativa, o que significa que está tirando uma média sobre qualquer coisa aleatória, o que pode incluir informação incerta no estado inicial $S_0$, bem como o processo de informação exógena $W_1, \ldots, W_T$. É padrão escrever o operador de expectativa, mas nunca podemos realmente computá-lo. Mais adiante mostramos como aproximá-lo executando uma série de simulações e tirando uma média, ou observando um processo no campo.
Deve-se ter cuidado ao interpretar o operador de expectativa “$\E$” na equação $\eqref{eq:baseobjectivefunction}$. O que esse operador literalmente significa é “tirar uma média sobre tudo o que é incerto”. A parte mais óbvia de incerteza é o processo de informação exógena $W_1, W_2, \ldots, W_t, \ldots, W_T$.
A transição do problema real (guiado pela narrativa) para os elementos do modelo matemático é talvez a etapa mais difícil, pois frequentemente envolve solicitar informações de uma fonte não técnica.
Observamos que apresentamos todo o modelo sem especificar como tomamos decisões, o que é representado pela política $X^\pi(S_t)$. Chamamos isso de “modelar primeiro, depois resolver” e isso representa um grande afastamento da vasta literatura que trata de problemas de decisão sequencial. É difícil comunicar o quão importante é abordar problemas de decisão sequencial dessa forma.
Etapa 5. O modelo de incerteza – Esta é a forma como modelamos os diferentes tipos de incerteza. Existem duas maneiras de introduzir incerteza em nosso modelo:
- Através do estado inicial $S_0$, que pode especificar uma distribuição de probabilidade para parâmetros incertos, como a forma como um paciente pode responder a um medicamento ou como o mercado pode responder ao preço.
- Através do processo de informação exógena $W_1, \ldots, W_T$.
Temos três maneiras de modelar o processo de informação exógena:
- Criar um modelo matemático de $W_1, W_2, \ldots, W_T$.
- Usar observações do histórico, como preços passados, vendas ou eventos climáticos.
- Executar o sistema no campo, observando $W_t$ conforme acontecem.
Etapa 6. Projetando políticas – Políticas são funções, então precisamos buscar a melhor função. (Sim, políticas são funções para escolher a melhor decisão, mas escolher a política também é uma decisão!) Fazemos isso identificando duas estratégias centrais para projetar políticas:
- Buscar em uma família de funções para encontrar a que funciona melhor, em média, ao longo do tempo.
- Criar uma política estimando o custo ou contribuição imediata de uma decisão $x_t$, mais uma aproximação dos custos ou contribuições futuros, e então encontrando a escolha $x_t$ que otimiza a soma dos custos ou contribuições atuais e futuros. O Google Maps decide se deve virar à esquerda ou à direita otimizando sobre o tempo necessário para atravessar o próximo trecho na rede mais o tempo restante para chegar ao destino. Uma decisão de estoque pode otimizar sobre o custo de um pedido mais o valor estimado de manter uma certa quantidade de estoque no futuro.
Vamos ser muito mais explícitos sobre como identificar essas políticas. Uma seção posterior descreve quatro classes de políticas que incluirão qualquer método para tomar decisões (essas são meta-classes).
Passo 7. Avaliando políticas – Encontrar a melhor política significa avaliar políticas para determinar qual é a melhor. Há duas formas de avaliar uma política:
- Testar a política em um simulador de computador. Isso requer programar todas as equações no modelo de transição de estado $S^M(S_t,x_t,W_{t+1})$ necessário para atualizar a variável de estado $S_t$. Também significa ser capaz de gerar amostras de $W_{t+1}$, o que geralmente é o aspecto mais sutil de um simulador.
- Observar como a política funciona no campo.
Simuladores podem ser complexos e difíceis de construir, e ainda estão sujeitos a aproximações de modelagem. Por esse motivo, a grande maioria dos problemas práticos encontrados na prática tende a envolver testes no campo, o que é lento (leva um dia para simular um dia) e requer conviver com os resultados dos experimentos.
A única maneira de se sentir confortável com um modelo matemático é vê-lo ilustrado usando um exemplo familiar. Começamos com um problema universal que todos nós encontramos na vida cotidiana: gerenciar estoques.
Alguns problemas de estoque
Vamos ilustrar nossa estrutura de modelagem usando duas variações de um problema de estoque clássico, que é amplamente utilizado como aplicação para ilustrar certos métodos de resolução de problemas de decisão sequencial. Começamos com um exemplo simples de estoque que transmite os elementos centrais de nossa estrutura de modelagem, mas nos permite ignorar muitas das complexidades que exploraremos no restante do livro.
Em seguida, vamos fazer a transição para um problema de estoque ligeiramente mais complicado, que nos permitirá ilustrar alguns princípios de modelagem. Ao longo do livro, também vamos usar a ideia de começar com uma versão básica de um problema, e então introduzir extensões que sugerem os tipos de complicações que podem surgir em aplicações reais.
Um problema simples de estoque
Um dos problemas de decisão sequencial mais familiares que todos experimentamos cada vez que visitamos uma loja é um problema de estoque. Vamos usar uma versão simples deste problema para ilustrar os seis passos de nosso processo de modelagem que introduzimos acima:
Passo 1: Narrativa – Uma pizzaria precisa decidir quantas libras de linguiça pedir ao seu distribuidor de alimentos. O restaurante tem que tomar a decisão no final do dia $t$, comunicar o pedido que então chega na manhã seguinte para atender os pedidos de amanhã. Se houver linguiça restante, ela pode ser guardada para o dia seguinte. O custo da linguiça, e o preço pelo qual será vendida no dia seguinte, é conhecido com antecedência, mas a demanda não é.
Passo 2: Os elementos centrais do problema são:
- Métricas – Queremos maximizar os lucros dados pelas vendas de linguiça menos o custo de compra da linguiça.
- Decisões – Temos que decidir quanto pedir no final de um dia, chegando no início do próximo.
- Fontes de incerteza – A única fonte de incerteza neste modelo simples é a demanda por linguiça no dia seguinte.
Passo 3: O modelo matemático – Este consiste em cinco elementos.
1) A variável de estado $S_t$ – Distinguimos entre a variável de estado inicial $S_0$, e a variável de estado dinâmica $S_t$ para $t > 0$. A variável de estado inicial $S_0$ consiste em parâmetros fixos e valores iniciais de variáveis que mudam ao longo do tempo, o que nos dá
\[S_0 = (R^{inv}_0, (p, c), (\Dbar, \sigmabar^D)).\]Dividimos o estado inicial em três tipos de variáveis:
- Valores iniciais do estado de recursos $R^{inv}_0$.
- Valores de parâmetros constantes $c$ e $p$.
- Nossa crença sobre as demandas, dada por uma distribuição normal com média $\Dbar$ e desvio padrão $\sigmabar^D$.
A variável de estado dinâmica $S_t$ é nosso estoque, que vamos chamar de $R^{inv}_t$. Por agora, este é o único elemento da variável de estado dinâmica, então
\[S_t = R^{inv}_t.\]Mais adiante vamos introduzir elementos adicionais à nossa variável de estado.
2) A variável de decisão $x_t$ é quanto pedimos no tempo $t$, que assumimos (por agora) chegar imediatamente. Tomamos nossas decisões com uma política $X^\pi(S_t)$ que projetaremos mais adiante.
3) A informação exógena é a demanda aleatória por nosso produto, que vamos denotar $\Dhat_{t+1}$, então $W_{t+1} = \Dhat_{t+1}$.
4) Nossa função de transição captura como o estoque $R_t$ evolui ao longo do tempo, dada por
\[\begin{align} R^{inv}_{t+1} = \max\{0, R^{inv}_t+x_t-\Dhat_{t+1}\}. \label{eq:inventoryexampleequation} \end{align}\]5) Nossa função objetivo. Para nosso problema de estoque, é mais natural calcular a contribuição incluindo o custo de compra do produto $x_t$ e a receita da satisfação da demanda $\Dhat_{t+1}$, o que significa que nossa função de contribuição de período único seria escrita
\[C(S_t,x_t,\Dhat_{t+1}) = -cx_t + p \min\{R^{inv}_t+x_t, \Dhat_{t+1}\},\]onde $x_t = X^\pi(S_t)$. Dada uma sequência de demandas $\Dhat_1, \ldots, \Dhat_T$, o valor de uma política $\Fhat^\pi$ seria
\[\Fhat^\pi(S_0) = \sum_{t=0}^T C(S_t,X^\pi(S_t),\Dhat_{t+1}).\]Nossos lucros $\Fhat^\pi(S_0)$ são aleatórios porque dependem de uma sequência particular de demandas aleatórias $\Dhat_1, \ldots, \Dhat_T$. Por fim, tiramos a média sobre essas demandas aleatórias tomando a esperança:
\[\begin{align} F^\pi(S_0) = \E \left\{\sum_{t=0}^T C(S_t,X^\pi(S_t),\Dhat_{t+1})\vert S_0\right\}. \label{eq:inventoryobjective} \end{align}\]Aqui, a condicionalização no estado inicial $S_0$ pode ser lida como dizendo “tomar a esperança dado o que sabemos inicialmente.” A condicionalização em $S_0$ é implícita sempre que tomamos uma esperança, e como resultado muitos autores a omitem. No entanto, vamos incluir a condicionalização em $S_0$ para deixar claro que, se nossas entradas iniciais (incluindo crenças) mudarem, isso pode ter um efeito sobre o desempenho de uma política.
Passo 4. O modelo de incerteza – A abordagem mais simples para modelar a incerteza é simplesmente usar dados históricos. O problema que podemos encontrar é que, se ficarmos sem linguiça, podemos não observar a demanda total por linguiça naquele dia. Se conseguirmos capturar essa demanda perdida, então essa é uma abordagem razoável.
Uma alternativa é construir um modelo matemático. Podemos assumir que nossa demanda é normalmente distribuída com alguma média $\Dbar$ e desvio padrão $\sigmabar^D$. Se assumirmos que ambos são conhecidos, podemos escrever nossa demanda como
\[\Dhat_{t+1} \sim N(\Dbar,(\sigmabar^D)^2),\]e aproveitar pacotes que podem amostrar da distribuição normal (por exemplo, no Excel isso é chamado de Norm.inv$(Rand(),\Dbar,\sigmabar)$ para gerar uma observação aleatória com média $\Dbar$ e desvio padrão $\sigmabar$.
Usando este modelo, podemos criar um conjunto de demandas $(\Dhat_1, \Dhat_2, \ldots, \Dhat_T)$. Então, podemos repetir isso $N$ vezes para criar $N$ sequências de $T$ demandas, o que nos dá a sequência $(\Dhat^n_1, \Dhat^n_2, \ldots, \Dhat^n_T)$ para $n=1, \ldots, N$ que precisamos para estimar o valor da política (usamos isso abaixo no Passo 6).
Passo 5. Projetando políticas – Em seguida, temos que projetar um método para determinar nossos pedidos. Uma estratégia comumente usada para problemas de estoque é conhecida como política “pedir-até” (order-up-to), que se parece com
\[\begin{align} X^\pi(S_t\vert \theta) = \begin{cases} \theta^{max} - R_t & \text{if } R_t < \theta^{min}, \\ 0 & \text{otherwise,}\end{cases} \label{eq:introorderupto} \end{align}\]onde $\theta = (\theta^{min},\theta^{max})$ é um conjunto de parâmetros que precisam ser ajustados. É chamada de “pedir-até” já que fazemos um pedido para levar o estoque “até” o limite superior $\theta^{max}$.
Passo 6. Avaliando políticas – Há uma variedade de estratégias que podemos usar. Na prática, não podemos calcular a esperança na função objetivo na equação $\eqref{eq:inventoryobjective}$, então tomamos uma série de amostras de demandas. Seja $\Dhat^n_1, \ldots, \Dhat^n_T$ uma amostra de demandas ao longo de $t=1, \ldots, T$, e assuma que podemos gerar $N$ dessas. Agora podemos estimar nossos lucros esperados a partir da política $X^\pi(S_t)$ tirando a média sobre as amostras para $n=1, \ldots, N$, que é calculada usando
\[\Fbar^\pi(\theta\vert S_0) = \frac{1}{N} \sum_{n=1}^N \sum_{t=0}^T C(S_t,X^\pi(S_t\vert \theta),\Dhat^n_{t+1}).\]Em termos simples, estamos simulando a política $X^\pi(S_t\vert \theta)$ $N$ vezes usando as amostras simuladas (ou observadas a partir do histórico) de demandas $\Dhat^n_1, \ldots, \Dhat^n_T$, e então tirando a média do desempenho para obter $\Fbar^\pi(\theta\vert S_0)$. Em seguida, enfrentamos o problema de encontrar o melhor valor de $\theta$. Uma estratégia simples seria gerar $K$ valores possíveis $\theta_1, \ldots, \theta_K$, simulando cada um para encontrar $\Fbar^\pi(\theta_k\vert S_0)$ para cada $k$, e então escolher o valor de $\theta_k$ que funciona melhor. Isso não é uma estratégia ótima, mas fornece um ponto de partida simples e prático.
Um problema ligeiramente mais complicado
O problema de estoque simples acima é um cenário clássico para demonstrar um método específico de resolução de problemas de decisão sequencial conhecido como programação dinâmica, que depende de ter uma variável de estado simples que a) é discreta e b) não tem muitos valores possíveis. Em nosso problema de estoque ligeiramente mais complicado, vamos ilustrar três diferentes tipos de variáveis de estado que representariam uma complicação séria para um método popular de resolução de problemas de decisão sequencial, mas não tem efeito sobre a política que escolhemos.
Passo 1: Narrativa – Novamente temos nossa pizzaria que precisa pedir linguiça, mas vamos permitir que o preço que pagamos pela linguiça varie de dia para dia, onde assumimos que o preço em um dia é independente do preço no dia anterior. Então, também vamos assumir que, embora a demanda por linguiça amanhã seja aleatória, receberemos uma previsão da demanda de amanhã que, embora não seja perfeita, é melhor do que não ter previsão nenhuma. Fora isso, tudo sobre nosso problema mais complicado é o mesmo que era antes.
Passo 2: Elementos centrais – Estes são:
- Métricas – Queremos maximizar os lucros dados pelas vendas de linguiça menos o custo de compra da linguiça, onde o custo varia de dia para dia.
- Decisões – Assim como em nosso problema de estoque mais simples, temos que decidir quanto pedir no final de um dia, chegando no início do próximo.
- Fontes de incerteza – Agora há três fontes de incerteza: a diferença entre a demanda real e a previsão, a evolução das previsões de um dia para o outro, e o preço que pagamos pela linguiça.
Passo 3: Modelo matemático – Ainda temos os mesmos cinco elementos, mas agora o problema é um pouco mais rico:
1) Para construir a variável de estado, precisamos listar a informação (especificamente, informação que evolui ao longo do tempo) que é necessária em três partes diferentes do modelo: (1) a função objetivo, (2) a política para tomar decisões (que inclui as restrições), e (3) a função de transição. É claro que ainda não introduzimos nenhuma dessas funções, então você tem que ler adiante, e verificar que nossa variável de estado contém todas as informações necessárias para calcular cada uma dessas funções. Pense nisso como um dicionário das informações que precisaremos.
Começamos com o estado inicial $S_0$, que consiste em parâmetros constantes, e valores iniciais de quantidades e parâmetros que mudam ao longo do tempo. Estes são:
- Estoque inicial – Começamos com um estoque inicial $R_0$.
- Custo de compra inicial – $c_0$.
- Preço – Assumimos que vendemos nossa linguiça a um preço fixo $p$.
- Previsão inicial – Assumimos que nossa primeira previsão $f^D_{0,1}$ é dada, onde $f^D_{0,1}$ é a previsão conhecida no tempo 0 para a demanda no tempo 1.
- Estimativa inicial do desvio padrão da demanda – $\sigmabar^D_0$.
- Estimativa inicial do desvio padrão da previsão – $\sigmabar^f_0$.
Isso significa que nossa variável de estado inicial é
\[S_0 = (R_0,c_0, p, f^D_{0,1}, \sigmabar^D_0, \sigmabar^f_0).\]Temos então a informação que evolui ao longo do tempo, que compõe nossa variável de estado dinâmica $S_t$:
- Estoque atual $R^{inv}_t$ – O estoque no início do intervalo de tempo $(t,t+1)$.
- Custo de compra $c_t$ – Este é o custo da linguiça comprada no tempo $t$ que nos é dado no tempo $t$.
- Previsão de demanda $f^D_{t,t+1}$ – Esta é a previsão de $\Dhat_{t+1}$ dado o que sabemos no tempo $t$.
- Estimativa atual do desvio padrão da demanda – $\sigmabar^D_t$.
- Estimativa atual do desvio padrão da previsão – $\sigmabar^f_t$.
Nossa variável de estado dinâmica é então dada por
\[S_t = (R^{inv}_t, c_t, f^D_{t,t+1}, \sigmabar^D_t, \sigmabar^f_t).\]2) A variável de decisão $x_t$ é a quantidade que pedimos no tempo $t$, que assumimos (por ora) chegar imediatamente. Tomamos nossas decisões com uma política $X^\pi(S_t)$ que projetamos mais adiante.
3) A informação exógena agora consiste em:
- Custos de compra $\chat_{t+1}$ – Este é o custo de compra da linguiça no dia $t+1$, especificado exogenamente.
- Previsões – A cada período de tempo recebemos uma nova previsão. Seja $\varepsilon^f_{t+1}$ a mudança na previsão entre o tempo $t$ e $t+1$.
- Demandas – Finalmente, assumimos que a demanda real é um desvio aleatório em relação à previsão, o que poderíamos escrever
Nosso conjunto completo de variáveis de informação exógena pode agora ser escrito
\[W_{t+1} = \big(\chat_{t+1}, \varepsilon^f_{t+1}, \varepsilon^D_{t+1}\big).\]4) Função de transição – Isso especifica como cada uma das variáveis de estado (dinâmicas) $S_t$ evolui ao longo do tempo. Atualizamos nosso estoque usando:
\[\begin{align} R^{inv}_{t+1} &= \max\{0, R^{inv}_t + x_t - \Dhat_{t+1}\}. \label{eq:introcomplexinventorytransition1} \end{align}\]A demanda é a demanda prevista mais o desvio $\varepsilon^D_{t+1}$ em relação à previsão, o que nos dá a equação:
\[\begin{align} \Dhat_{t+1} &= f^D_{t,t+1} + \varepsilon^D_{t+1}. \label{eq:introcomplexinventorytransition2} \end{align}\]Assumimos que nossa previsão é atualizada usando
\[\begin{align} f^D_{t+1,t+2} &= f^D_{t,t+1} + \varepsilon^f_{t+1}. \label{eq:introcomplexinventorytransition3} \end{align}\]A seguir, vamos estimar adaptativamente a variância na demanda e na previsão de demanda:
\[\begin{align} (\sigmabar^D_{t+1})^2 &= (1-\alpha)(\sigmabar^D_t)^2 + \alpha (f^D_{t,t+1} - \Dhat_{t+1})^2, \label{eq:introcomplexinventorytransition4}\\ (\sigmabar^f_{t+1})^2 &= (1-\alpha)(\sigmabar^f_t)^2 + \alpha (f^D_{t,t+1} - f^D_{t+1,t+2})^2, \label{eq:introcomplexinventorytransition5} \end{align}\]onde $0 < \alpha < 1$ é um fator de suavização.
Finalmente, atualizamos o custo $c_{t+1}$ com o “custo observado” $\chat_{t+1}$, que escrevemos simplesmente como
\[\begin{align} c_{t+1} = \chat_{t+1}.\label{eq:introcomplexinventorytransition6} \end{align}\]A equação $\eqref{eq:introcomplexinventorytransition6}$ é um exemplo de uma variável de estado que observamos em vez de calcular, como fizemos com o estoque $R^{inv}_t$ em $\eqref{eq:introcomplexinventorytransition1}$. A equação $\eqref{eq:introcomplexinventorytransition1}$ é às vezes chamada de “baseada em modelo,” já que reflete a física de como os estoques são atualizados, enquanto a equação $\eqref{eq:introcomplexinventorytransition6}$ é chamada de “livre de modelo,” já que não fazemos nenhuma tentativa de modelar o processo subjacente que produz a mudança nos custos.
Nossa função de transição $S_{t+1} = S^M(S_t,x_t,W_{t+1})$ consiste nas equações $\eqref{eq:introcomplexinventorytransition1}$–$\eqref{eq:introcomplexinventorytransition6}$.
5) Finalmente, nossa função de contribuição de período único seria agora escrita como
\[C(S_t,x_t,\Dhat_{t+1}) = -c_tx_t + p \min\{R_t+x_t, \Dhat_{t+1}\},\]onde a única diferença com o problema de estoque mais simples é que o custo $c$ agora é dependente do tempo $c_t$. Nós nos afastamos de nossa convenção de escrever a contribuição como $C(S_t,x_t)$ e permitimos que ela inclua receitas provenientes das demandas $\Dhat_{t+1}$.
Agora declaramos formalmente nossa função objetivo como
\[\begin{align} \max_{\pi=(f,\theta)} \E \left\{\sum_{t=0}^T C(S_t,X^\pi(S_t\vert \theta),\Dhat_{t+1})\vert S_0\right\}. \label{eq:introcomplexinventoryobjective} \end{align}\]A otimização $\max_\pi$ significa que estamos buscando entre todas as políticas possíveis representadas por $(f,\theta)$, o que literalmente significa buscar entre todas as diferentes funções que poderíamos usar para tomar uma decisão. Os exemplos neste livro irão demonstrar como vamos buscar entre funções.
Lembre-se que acima afirmamos que o índice $\pi$ carrega informação sobre o tipo de função $f\in\Fcal$, e quaisquer parâmetros ajustáveis $\theta\in\Theta^f$. Na prática, a busca sobre os tipos de funções $f\in\Fcal$ tende a ser ad hoc (um analista experiente escolhe funções que fazem sentido para um problema), enquanto um algoritmo de computador realiza a busca pelo melhor valor de $\theta\in\Theta^f$.
Passo 4. O modelo de incerteza – Vamos assumir que as mudanças exógenas $\varepsilon^D_{t+1}$ e $\varepsilon^f_{t+1}$ são descritas por distribuições normais com média 0 e variâncias $(\sigmabar^D_t)^2$ e $(\sigmabar^f_t)^2$, o que expressamos escrevendo
\[\varepsilon^D_t \sim N(0, (\sigmabar^D_t)^2), \quad \varepsilon^f_t \sim N(0, (\sigmabar^f_t)^2).\]Modelos de incerteza podem se tornar bastante complexos, mas isso servirá como ilustração.
Passo 5. Projetando políticas – A seguir, precisamos projetar um método para determinar nossos pedidos. Em vez da política de pedido-até de nosso modelo mais simples, vamos sugerir a ideia de pedir o suficiente para atender à demanda esperada de amanhã, com um ajuste. Poderíamos escrever isso como
\[\begin{align} X^\pi(S_t\vert \theta) = \max\{0,f^D_{t,t+1}-R_t\} + \theta. \label{eq:adjustedforecastpolicy} \end{align}\]Se tivéssemos uma previsão perfeita, então tudo o que teríamos que pedir seria $f^D_{t,t+1}$ (nossa previsão de $\Dhat_{t+1}$) menos o estoque disponível. No entanto, devido à incerteza, vamos adicionar um ajuste $\theta$ para que tenhamos alguma margem para evitar rupturas de estoque.
Passo 6. Avaliando políticas – Desta vez precisamos gerar amostras de todas as variáveis aleatórias na sequência $W_1, W_2, \ldots, W_T$. Novamente podemos gerar $N$ amostras de toda a sequência para estimar o desempenho de uma política usando
\[\Fbar^\pi(\theta) = \frac{1}{N} \sum_{n=1}^N \sum_{t=0}^T C(S_t,X^\pi(S_t\vert \theta),\Dhat^n_{t+1}).\]Novamente enfrentamos o problema de encontrar o melhor valor de $\theta$, mas retornaremos a esse desafio mais adiante.
O arcabouço de modelagem universal
Estamos agora prontos para descrever com mais detalhes os elementos do arcabouço de modelagem universal (UMF). Notamos que o UMF pode modelar qualquer problema de decisão sequencial. Essa afirmação bastante ampla se tornará evidente conforme os elementos se desenrolam, já que estamos apenas aplicando notação à declaração geral de um problema de decisão sequencial.
Os cinco elementos do UMF
O UMF consiste nos seguintes elementos:
- As variáveis de estado $S_t$.
- As variáveis de decisão $x_t$.
- O processo de informação exógena $W_t$.
- O modelo de transição de estado $S^M(S_t,x_t,W_{t+1})$.
- A função objetivo.
Descrevemos estes em mais detalhes a seguir:
Variáveis de estado – O estado $S_t$ do sistema no tempo $t$ possui toda a informação que é necessária e suficiente para modelar nosso sistema a partir do tempo $t$ em diante. Mais especificamente, essa informação consiste em:
- a) A informação necessária para tomar uma decisão no tempo $t$.
- b) A informação necessária para calcular as métricas de desempenho no tempo $t$.
- c) Qualquer informação necessária agora para calcular (a) e (b) no futuro.
Existem três tipos de informação em $S_t$:
- O estado físico, $R_t$, captura quantidades físicas como estoques, pessoas, máquinas disponíveis, instalações, água, medicamentos, energia e dinheiro (em suas várias formas). $R_t$ também incluirá solicitações de clientes por produtos ou serviços. Em muitas aplicações, $R_t$ descreve o recurso que está sendo gerenciado, e um erro bastante comum é igualar “estado” a “estado físico.”
- O estado de informação, $I_t$, que contém as funções em uso (quando há uma escolha) e quaisquer parâmetros ajustáveis. $I_t$ pode especificar como estamos prevendo demandas, e os parâmetros usados para ajustar a previsão, além de quaisquer outros parâmetros que controlam a evolução do sistema.
- O estado de crença, $B_t$, que contém estimativas ou crenças sobre quantidades e parâmetros que não são conhecidos perfeitamente. Assim, $B_t$ poderia capturar a média e a variância estimadas de uma distribuição normal (como em nossa previsão de demanda acima). Alternativamente, poderia ser um vetor de probabilidades que evoluem ao longo do tempo.
O estado físico $R_t$ poderia ser a quantidade de dinheiro em uma conta corrente, enquanto $I_t$ poderia ser o estado atual dos mercados de ações e títulos. Se estivermos viajando por uma rede dinâmica, $R_t$ poderia ser nossa localização na rede, enquanto $I_t$ poderia ser o que sabemos sobre os tempos de viagem em cada elo. Se planejarmos um caminho e depois desejarmos penalizar desvios do plano, então o plano seria incluído na variável de estado através de $I_t$.
Variáveis de estado tipicamente não são óbvias. Elas emergem durante o processo de modelagem, em vez de algo que você pode simplesmente listar imediatamente. Só porque escrevemos isso primeiro não significa que você sempre será capaz de listar todos os elementos da variável de estado de imediato. Mas, no final, é aí que você armazena todas as informações que precisa para modelar seu sistema a partir do tempo $t$ em diante.
Variáveis de decisão – Comunidades diferentes usam notações diferentes para decisão, como $a_t$ para uma ação (tipicamente discreta) ou $u_t$ para um controle (tipicamente contínuo) em engenharia. Usamos $x_t$ como nosso padrão, já que é amplamente utilizado pela comunidade de programação matemática.
Variáveis de decisão vêm em diferentes formas:
- Binárias (por exemplo, para modelar se vendemos um ativo ou não, ou para testes A/B de diferentes designs de páginas web).
- Discretas (por exemplo, escolha de medicamento, qual produto anunciar).
- Escalares contínuas (preços, temperaturas, concentrações).
- Vetores (discretos ou contínuos, como alocações de suprimentos de sangue entre hospitais).
- Categóricas (por exemplo, quais características destacar em um anúncio de produto).
Notamos que existem classes de algoritmos determinadas pela natureza da variável de decisão.
Assumimos que as decisões são tomadas com uma política, que poderíamos denotar $X^\pi(S_t)$ se usarmos $x_t$ como nossa decisão. Assumimos que uma decisão $x_t = X^\pi(S_t)$ é viável no tempo $t$, o que significa $x_t \in \Xcal_t$ para algum conjunto (ou região) $\Xcal_t$, que pode depender de $S_t$.
Deixamos que “$\pi$” carregue a informação sobre o tipo de função $f\in\Fcal$ (por exemplo, um modelo linear com variáveis explicativas específicas), e quaisquer parâmetros ajustáveis $\theta \in \Theta^f$.
Informação exógena – Deixamos que $W_{t+1}$ seja qualquer nova informação que se torna conhecida primeiro no tempo $t+1$ (ou seja, entre $t$ e $t+1$), onde a fonte da informação é externa ao nosso sistema (por isso é “exógena”). Ao modelar variáveis específicas, usamos “chapéus” para indicar informação exógena. Assim, $\Dhat_{t+1}$ poderia ser a demanda que surge entre $t$ e $t+1$, ou poderíamos deixar $\phat_{t+1}$ ser a mudança no preço entre $t$ e $t+1$.
O processo de informação exógena pode ser estacionário ou não estacionário, puramente exógeno ou dependente do estado (e possivelmente da ação) (se decidirmos vender muito de uma ação, isso poderia pressionar os preços para baixo).
Deixamos que $\omega$ represente um caminho amostral $W_1, \ldots, W_T$, que representa uma sequência de resultados de cada $W_t$. Frequentemente, criaremos um conjunto $\Omega$ de amostras discretas, onde cada amostra representa uma sequência particular dos resultados de nosso processo $W_t$, que poderíamos escrever como $W_1(\omega), \ldots, W_T(\omega)$. Se tivermos 20 caminhos amostrais, podemos pensar em $\omega$ como consistindo de um número entre 1 e 20, o que nos permite consultar o caminho amostral.
Função de transição – Denotamos a função de transição por
\[\begin{align} S_{t+1} = S^M(S_t,x_t,W_{t+1}), \label{eq:transition} \end{align}\]onde $S^M(\cdot)$ também é conhecida por nomes como modelo de transição de estado, modelo de sistema, modelo de planta, equação de planta, equação de estado e função de transferência.
A equação $\eqref{eq:transition}$ é a forma clássica de uma função de transição que fornece as equações do estado $S_t$ para o estado $S_{t+1}$. A equação $\eqref{eq:inventoryexampleequation}$ foi a única equação de transição para nosso exemplo simples de estoque, enquanto as equações $\eqref{eq:introcomplexinventorytransition1}$–$\eqref{eq:introcomplexinventorytransition6}$ compuseram a função de transição para nosso exemplo mais complicado.
A função de transição pode capturar qualquer um dos seguintes tipos de atualizações:
- Mudanças em recursos físicos, como adicionar estoque, mover pessoas ou modificar equipamentos.
- Atualizações de informação, como mudanças em preços e clima.
- Atualizações em nossas crenças sobre quantidades ou parâmetros incertos.
A função de transição pode ser um conjunto conhecido de equações, ou desconhecida, como quando descrevemos comportamento humano ou a evolução de CO2 na atmosfera. Quando as equações são desconhecidas, o problema é frequentemente descrito como “livre de modelo” ou “guiado por dados,” o que significa que só podemos observar mudanças em uma variável, em vez de usar um modelo físico. A equação $\eqref{eq:introcomplexinventorytransition6}$, onde “observamos” o custo $c_{t+1} = \chat_{t+1}$, sem nenhuma ideia de como evoluímos a partir de $c_t$, é um exemplo de uma transição livre de modelo.
Funções de transição podem ser lineares, contínuas não lineares ou funções escalonadas. Quando o estado $S_t$ inclui um estado de crença $B_t$, então a função de transição precisa incluir as equações de atualização (ilustramos isso mais adiante no livro).
Dada uma política $X^\pi(S_t)$, um processo exógeno $W_{t+1}$ e uma função de transição, podemos escrever nossa sequência de estados, decisões e informações como
\[(S_0, x_0, W_1, S_1, x_1, W_2, \ldots, x_{T-1}, W_T, S_T).\]Funções objetivo – Existem várias maneiras de escrever funções objetivo. Uma das mais comuns, que usaremos como padrão, maximiza as contribuições totais esperadas ao longo de algum horizonte $t=0, \ldots, T$
\[\begin{align} \max_{\pi=(f,\theta)} F^\pi(S_0) = \E \left\{\sum_{t=0}^T C_t(S_t,X^\pi_t(S_t\vert \theta))\vert S_0\right\}, \label{eq:objectivecumulativereward} \end{align}\]onde
\[\begin{align} S_{t+1} = S^M(S_t,X^\pi_t(S_t),W_{t+1}). \label{eq:basetransition} \end{align}\]O modelo é totalmente especificado quando também temos um modelo do estado inicial $S_0$, e um modelo do processo exógeno $W_1, W_2, \ldots$. Escrevemos toda a informação exógena como
\[\begin{align} (S_0, W_1, W_2, \ldots, W_T). \label{eq:basestochasticmodel} \end{align}\]As equações $\eqref{eq:objectivecumulativereward}$, $\eqref{eq:basetransition}$ e $\eqref{eq:basestochasticmodel}$ constituem um modelo de um problema de decisão sequencial.
Seguindo adiante, por compactação, vamos usar $\max_\pi$ para representar uma busca sobre os tipos de funções $f\in\Fcal$ e parâmetros ajustáveis $\theta\in\Theta^f$.
A equação $\eqref{eq:objectivecumulativereward}$ usa uma esperança $\E$, que significa tirar uma média sobre todos os resultados possíveis de $W_1, \ldots, W_T$. Isso praticamente nunca é possível de fazer computacionalmente. Em vez disso, deixe $\omega$ representar um único resultado da sequência $W_1, \ldots, W_T$, que poderíamos escrever $W_1(\omega), \ldots, W_T(\omega)$. Assuma que podemos criar $N$ resultados possíveis dessa sequência, e deixe $\omega^n$ representar como indexamos a sequência $n^{th}$.
Se estivermos seguindo um caminho amostral $\omega$, reescreveríamos então nossa função de transição em $\eqref{eq:basetransition}$ usando
\[\begin{align} S_{t+1}(\omega) = S^M(S_t(\omega),X^\pi_t(S_t(\omega)),W_{t+1}(\omega)). \label{eq:basetransition2} \end{align}\]Indexamos cada variável na equação $\eqref{eq:basetransition2}$ por $\omega$ para indicar que estamos seguindo um único caminho amostral de valores de $W_t$.
Podemos agora substituir nossa função objetivo baseada em expectativa por uma média, que podemos escrever
\[\begin{align} \max_\pi \Fbar^\pi(S_0) = \frac{1}{N}\sum_{n=1}^N \sum_{t=0}^T C_t(S_t(\omega^n),X^\pi_t(S_t(\omega^n))). \label{eq:objectivecumulativerewardaverage} \end{align}\]Frequentemente, estamos trabalhando apenas com um único caminho amostral, possivelmente do histórico. Nesse caso, estamos aproximando o desempenho da política usando esse único caminho amostral, o que podemos escrever como
\[\begin{align} \max_\pi \Fhat^\pi(\omega\vert S_0) = \sum_{t=0}^T C_t(S_t(\omega),X^\pi_t(S_t(\omega))). \label{eq:objectivecumulativerewardsample} \end{align}\]Sempre que escrevermos uma função objetivo usando uma expectativa como em $\eqref{eq:objectivecumulativereward}$, lembre-se de que o que realmente faríamos seria usar uma média como fazemos em $\eqref{eq:objectivecumulativerewardaverage}$ ou uma amostra como em $\eqref{eq:objectivecumulativerewardsample}$.
A expectativa também pode precisar refletir a incerteza no estado inicial $S_0$, que pode capturar crenças sobre previsões incertas, ou estimativas incertas sobre o estado de uma doença em um paciente. Nesse caso, o caminho amostral $\omega$ precisa incluir amostras dessas distribuições iniciais.
Haverá algumas situações em que faz mais sentido usar um contador $n$ em vez do tempo. Nesse caso, deixamos $S^n$ ser o estado após $n$ observações (que podem ser experimentos, chegadas de clientes, iterações de um algoritmo). Usaremos o tempo $t$ como nosso índice padrão.
As variáveis de estado inicial $S_0$
Precisamos distinguir entre o estado inicial $S_0$ e os estados subsequentes $S_t$ para $t > 0$:
- $S_0$ – O estado inicial $S_0$ captura i) parâmetros determinísticos que nunca mudam, ii) valores iniciais de quantidades ou parâmetros que mudam (possivelmente devido a decisões), e iii) crenças sobre quantidades ou parâmetros que não conhecemos perfeitamente (isso pode ser os parâmetros de uma distribuição de probabilidade) como a forma como respondemos a uma vacina ou como o mercado responderá ao preço. As crenças podem permanecer estáticas, ou podemos atualizá-las à medida que aprendemos com as observações.
- $S_t$ – Esta é toda a informação de que precisamos no tempo $t$ a partir do histórico para modelar o sistema a partir do tempo $t$ em diante. $S_t$ para $t > 0$ inclui apenas variáveis que estão mudando ao longo do tempo, o que significa que no tempo $t$ também podemos estar usando informações estáticas contidas em $S_0$.
Escrevemos a dependência explícita do desempenho da política em relação ao estado inicial $S_0$, seja usando $F^\pi(S_0)$, $\Fbar^\pi(S_0)$ ou $\Fhat^\pi(\omega\vert S_0)$. Embora isso deva ser óbvio, é frequentemente esquecido. O estado inicial inclui elementos como:
- Valores iniciais das quantidades de recursos físicos ou financeiros $R_0$ – Isso pode ser estoques iniciais, a localização inicial de um veículo, as máquinas disponíveis e o conjunto inicial de instalações. Também inclui quaisquer valores estáticos, como uma rede de transporte, o tamanho de um armazém (que não muda) e o número de caminhões em uma frota.
- Valores iniciais de parâmetros, junto com quaisquer funções usadas para modelar o problema $I_0$ – Isso poderia ser um preço inicial, o nível de medicação em um paciente, junto com a escolha de funções para realizar previsões ou modelar a evolução de doenças em uma população.
- Crenças ou estimativas iniciais de qualquer quantidade ou parâmetro $B_0$ – Isso poderia ser uma previsão de demanda, a estimativa de como os mercados respondem aos preços, como um candidato presidencial está nas pesquisas, ou crenças no desempenho de um processo de fabricação.
Notamos que ajuda separar os valores iniciais que nunca mudam daqueles que evoluem ao longo do tempo, seja diretamente como resultado de decisões ou de informação exógena. Valores que nunca mudam são armazenados em $S_0$, mas não são representados em $S_t$ para $t > 0$. A razão para isso é o desejo de manter $S_t$ o mais compacto possível.
Suponha que nossa política $X^\pi(S_t\vert \theta)$ tenha parâmetros ajustáveis. Por exemplo, podemos estar gerenciando um sistema de estoque onde usamos a familiar política “pedir até o nível” (conhecida na literatura de estoque como uma política $(s,S)$) dada por
\[X^\pi(S_t\vert \theta) = \begin{cases} \theta^{max} - R_t & R_t < \theta^{min},\\ 0 & \text{otherwise.}\end{cases}\]onde $\theta = (\theta^{min},\theta^{max})$. Para simplificar, podemos assumir que quando fazemos um pedido ele chega imediatamente (uma suposição padrão de livro-texto que nunca é verdadeira na prática), o que nos permite escrever a evolução do nosso estado físico $R_t$ (a quantidade em estoque logo antes de fazermos nosso pedido instantâneo) usando
\[R_{t+1} = \max\{0,R_t + x_t - \Dhat_{t+1}\}\]onde $x_t = X^\pi(S_t\vert \theta)$ e $\Dhat_{t+1}$ é a demanda pelo nosso produto ao longo do intervalo $(t,t+1)$ (esta é nossa informação exógena $W_{t+1}$). Finalmente, seja $C(S_t,x_t,W_{t+1})$ nosso lucro líquido ao longo do intervalo $(t,t+1)$ (o que não é importante no momento).
Agora imagine que temos um processo de demanda histórico $W_1, W_2, \ldots, W_t, \ldots, W_T$ que nos permite executar uma simulação do nosso sistema. Seja $\omega$ representando essa sequência histórica de demandas (ou qualquer informação exógena). Escreveríamos o problema de encontrar o melhor conjunto de parâmetros de pedido $\theta$ usando
\[\begin{align} \max_\theta \Fhat^\pi(\omega,\theta\vert S_0) = \sum_{t=0}^T C_t(S_t(\omega),X^\pi_t(S_t(\omega))), \label{eq:optimizingtheta} \end{align}\]onde a variável de estado evolui de acordo com
\[S_{t+1}(\omega) = S^M(S_t(\omega), X^\pi_t(S_t(\omega)), W_{t+1}(\omega)).\]Seja $\theta^\ast $ o valor de $\theta$ que encontramos ao otimizar $\eqref{eq:optimizingtheta}$. A forma correta de escrever esse valor ótimo é como uma função $\theta^\ast (S_0)$ que depende da informação em $S_0$ (também depende do caminho amostral $\omega$). Isso ajuda a comunicar a realidade de que, se mudarmos os dados de entrada do nosso problema, representados por $S_0$, isso pode ter um impacto nos melhores valores dos nossos parâmetros de política $\theta$. Na verdade, podemos até ter que mudar nossa escolha de política!
Variações
Existem duas variações importantes do nosso modelo matemático básico:
-
Do tempo $t$ para a iteração $n$ – Existem configurações de problemas em que é mais natural usar um contador $n$ do que o tempo $t$. Fazemos mais do que apenas mudar $t$ para $n$, já que vemos as variáveis que mudam com iterações de forma diferente de uma evolução ao longo do tempo. Especificamente, colocamos o índice $n$ no sobrescrito, como $S^n$, $x^n$ e $W^{n+1}$.
Uma razão para isso é que vemos um conjunto de variáveis ao longo do tempo $x_1, x_2, \ldots, x_t, \ldots, x_T$ como um vetor $x=(x_1, x_2, \ldots, x_t, \ldots, x_T)$, o que é útil ao modelar problemas determinísticos (podemos otimizar sobre todo o vetor $x$ de uma vez). Em contraste, vemos $x^n$ como uma função que está evoluindo ao longo do tempo.
De forma mais prática, colocar $n$ no sobrescrito nos permite escrever simulações iterativas. Assim, escreveríamos o processo de informação ao longo do tempo para a iteração $n$ usando
Se estivermos buscando iterativamente a melhor política, poderíamos escrever nossa política para a iteração $n$ usando $X^{\pi,n}(S_t)$, que então produz
\[S^n_0, x^n_0, W^n_1, \ldots, S^n_t, x^n_t, W^N_{t+1}, \ldots, S^N_T,\]onde $x^n_t = X^{\pi,n}(S^n_t\vert \theta)$.
-
Otimizando a recompensa final – Uma configuração comum é aquela em que estamos realizando busca estocástica, como aconteceria ao procurar a melhor política. Cada iteração para avaliar o algoritmo pode exigir uma simulação ao longo do tempo, embora isso nem sempre seja o caso.
Agora vamos assumir que nossa variável de decisão é o parâmetro $\theta$, e que temos um algoritmo $\Theta^\pi(S^{\theta,n})$ que funciona exatamente como uma política $X^\pi(S_t\vert \theta)$, mas onde $S^{\theta,n}$ captura o “estado” do algoritmo na $n$-ésima iteração.
Algoritmos de busca são todos problemas de decisão sequencial, mas, ao contrário da maioria dos problemas de decisão sequencial ao longo do tempo, queremos executar $N$ iterações, e nos importamos apenas com nossa solução ao final. Seja $\theta^{\pi,N}$ o valor de $\theta^n$ após $N$ iterações, seguindo o “algoritmo” (política) $\pi$.
O valor $\theta^{\pi,N}$ depende da sequência específica do nosso processo de informação $W^1, \ldots, W^t, \ldots, W^N$, mas então temos que avaliá-lo usando um novo conjunto de amostras que vamos chamar de $\What$.
Avaliamos o desempenho do nosso algoritmo usando uma função objetivo de recompensa final, que escrevemos como
Dito de forma simples, avaliamos nossa política de aprendizado para $\theta$, que denotamos $\Theta^\pi(S^{\theta,N})$, simulando ao longo de $N$ iterações usando observações de $W^n$ (que pode ser uma simulação inteira ao longo do tempo $t$). Quando obtemos nossa estimativa final do parâmetro $\theta$, que chamamos de $\theta^{\pi,N}$, avaliamos o desempenho desse valor usando uma simulação separada onde fixamos $\theta = \theta^{\pi,N}$ e então criamos um novo conjunto de observações aleatórias que chamamos de $\What^m$ para $m=1, \ldots, M$.
Modelando a incerteza
Para muitos problemas complexos (cadeias de suprimentos, sistemas de energia e saúde pública são apenas alguns exemplos), identificar e modelar as diferentes formas de incerteza pode ser um exercício rico e complexo. Vamos indicar as questões que surgem, mas não tentaremos uma discussão completa dessa dimensão.
A incerteza é comunicada ao nosso modelo por meio de dois mecanismos: o estado inicial $S_0$, onde modelaríamos os parâmetros de distribuições de probabilidade que descrevem quantidades e parâmetros que não conhecemos perfeitamente, e o processo de informação exógena $W_1, \ldots, W_T$.
Incerteza no estado inicial
A variável de estado inicial pode conter parâmetros determinísticos ou valores iniciais de quantidades e parâmetros que variam dinamicamente. Se isso for tudo o que está no estado inicial, então ele não está capturando nenhuma forma de incerteza.
Existem muitos problemas em que não conhecemos algumas quantidades ou parâmetros, mas podemos representar o que sabemos por meio dos parâmetros de uma distribuição de probabilidade. Alguns exemplos são:
- A resposta de um paciente a um novo medicamento.
- Como um mercado responderá a uma mudança de preço.
- Quantas cabeças de alface vendáveis temos em estoque (um número incerto pode ter murchado e não estar mais vendável).
- O momento em que uma caixa de estoque previamente encomendada da China chegará.
- O valor dos depósitos em um fundo mútuo varia aleatoriamente em torno de uma média $\lambda$, mas não sabemos qual é $\lambda$.
Estas são algumas formas pelas quais podemos inicializar um modelo com incerteza em algumas das entradas.
Uma crença probabilística inicial pode vir de um julgamento subjetivo, ou de observações ou experimentos anteriores.
O processo de informação exógena
A segunda forma pela qual a incerteza entra em nosso modelo é através do processo de informação exógena. A variável $W_t$ contém informação que não é conhecida até o período de tempo $t$. Isso significa que temos que tomar uma decisão $x_t$ no tempo $t$ antes de conhecer o resultado de $W_{t+1}$.
Abaixo está uma lista de exemplos de $W_{t+1}$ que são revelados após uma decisão $x_t$ ser tomada:
- Escolhemos um caminho e depois observamos o tempo de viagem no caminho.
- Escolhemos um medicamento e depois observamos como o paciente responde.
- Escolhemos um catalisador e depois observamos a resistência do material que ele produz.
- Escolhemos um produto para anunciar em um mercado on-line e depois observamos as vendas.
- Selecionamos um design de interface web e depois observamos o número de cliques que ele pode gerar.
- Alocamos fundos em um investimento e depois observamos a mudança no preço do investimento.
Em cada caso, a informação que observamos após tomarmos a decisão afeta o desempenho da decisão (e qual decisão teria sido a melhor).
A esta altura, o leitor provavelmente já percebeu que $W_{t+1}$ é geralmente uma coleção de diferentes tipos de informação. Por exemplo, imagine que estamos tratando um paciente que está com o açúcar no sangue elevado. O médico deseja experimentar diferentes estratégias, desde dieta e exercícios ou medicamentos para reduzir o peso, até medicamentos que visam especificamente o açúcar no sangue. As fontes de informação que o médico precisa processar podem incluir:
- Disposição do paciente para fazer dieta.
- Adesão do paciente às instruções de dieta.
- Disposição do paciente para aceitar injeções diárias para perda de peso.
- Perda de peso real (de qualquer programa).
- Mudança real no açúcar no sangue.
Cada um desses é um fluxo de informação separado. Podemos modelar isso introduzindo o conjunto $\Ical_t$, o conjunto de processos de informação no tempo $t$ (o conjunto pode mudar à medida que mudamos as estratégias, abrindo novos fluxos de informação). Podemos agora expressar os diferentes tipos de informação usando $W_{t+1,i}$, a realização da informação da fonte $i\in\Ical_t$, de modo que $W_{t+1} = (W_{t+1,i})_{i\in\Ical_t}$.
Continuaremos usando $W_{t+1}$ para representar a nova informação que chega, mas o leitor deve lembrar que, em aplicações reais, isso normalmente incluirá todo um conjunto de fontes de informação, cada uma com seus próprios comportamentos.
Processos dependentes de estado/decisão
Existem muitas aplicações em que a informação $W_{t+1}$ depende do estado atual $S_t$ e/ou da decisão $x_t$. Alguns exemplos incluem:
- A falta de estoque pode desestimular os clientes, reduzindo a demanda.
- Comprar uma grande quantidade de ações pode aumentar seus preços.
- A decisão de recomendar vacinas pode influenciar a progressão de uma doença.
- O número de geradores de energia online pode alterar os preços da rede elétrica.
Por essa razão, é útil representar a informação exógena como uma função $W_{t+1}(S_t,x_t)$, a função de informação exógena que fornece a informação que chega no intervalo $(t,t+1)$.
Por exemplo, imagine que estamos comprando ou vendendo ações em grandes quantidades, o que pode influenciar o preço futuro. A dinâmica poderia ser escrita como
\[\begin{align} p_{t+1} = \theta^p_0 p_t + \theta^p_1 p_{t-1} + \theta^p_2 p_{t-2} + W_{t+1}(S_t,x_t). \label{eq:statedependentprice} \end{align}\]O estado desse processo de preços seria escrito
\[S_t = (p_t, p_{t-1}, p_{t-2}).\]A variação aleatória no preço, dada por $W_{t+1}(S_t,x_t)$, reflete nossa crença de que a mudança no preço pode depender do preço atual (se o preço estiver alto, é provável que mudanças futuras sejam negativas), bem como da quantidade que estamos comprando ($x_t > 0$) ou vendendo ($x_t < 0$).
Naturalmente, gostaríamos de usar dados históricos para tentar separar qualquer influência estrutural de $S_t$ e $x_t$ sobre preços futuros do ruído verdadeiramente exógeno. Assim, poderíamos propor um modelo
\[W_{t+1}(S_t,x_t) = \theta^x x_t + \varepsilon_{t+1},\]no qual poderíamos assumir que
\[\varepsilon_{t+1} \sim N(0, \vert x_t\vert \sigma^2_t),\]Esse modelo assume que $\varepsilon_{t+1}$ tem média 0 e variância que cresce com o valor absoluto de $x_t$. A informação $W_{t+1}(S_t,x_t)$ teria então média $\theta^x x_t$, que é positiva se estivermos comprando ações ($x_t > 0$), e negativa se estivermos vendendo no mercado ($x_t < 0$).
Este livro continuará a usar $W_{t+1}$ como a notação padrão, mas o leitor deve estar ciente de que ela pode depender do estado atual e/ou da decisão tomada dado o estado.
Estilos de incerteza
Identificar os tipos de informação é o primeiro passo para entender a incerteza. O próximo passo é caracterizar os diferentes estilos de incerteza. Um resumo de algumas das formas mais importantes pelas quais os processos de informação podem se comportar inclui:
- Variabilidade de granulação fina – Isso pode surgir em escalas de tempo de segundos (até frações de segundo), minutos, horas ou diariamente.
- Mudanças – A variabilidade de granulação fina de um processo tipicamente representa variações em torno de uma média, mas há momentos em que a média mudará periodicamente para um novo nível. Isso pode refletir novas tecnologias, ajustes de concorrentes ou mudanças na economia.
- Surtos e demandas intermitentes – A propagação de doenças pode criar um surto de infecções, pois epidemias podem se espalhar localmente. Um cliente pode experimentar um produto e recomendá-lo a seus amigos, que então contam a seus amigos.
- Picos – Uma tempestade de neve iminente pode criar um salto na demanda por leite, ovos e papel higiênico; a falha de um gerador de energia pode criar um pico nos preços de eletricidade.
- Eventos espaciais – Clima, doenças e mudanças em regulamentações podem criar mudanças aleatórias que são regionais em natureza.
- Eventos sistêmicos – Estes são eventos que podem afetar toda uma empresa (atravessando fronteiras internacionais), um país inteiro, ou até mesmo ter um impacto global. Isso pode surgir por causa de um ataque cibernético às comunicações, mudanças na percepção pública e propaganda negativa.
- Eventos raros – Eventos raros podem surgir de várias fontes, como terremotos, surtos de doenças ou ataques terroristas. Estes tendem a ser eventos que ocorrem muito raramente, mas que podem ter um grande impacto em uma organização quando ocorrem.
- Contingências – Esta categoria se refere a eventos que podem acontecer, mas para os quais não há histórico. Por exemplo, operadores de redes elétricas planejarão para uma falha de usinas nucleares. Embora isso possa nunca ter acontecido dentro de um país, o operador da rede pode ainda assim querer se preparar para o evento caso ele ocorra.
Esses comportamentos podem ter um impacto na escolha da política para tomar decisões, um tópico que trataremos a seguir.
A incerteza é amplamente reconhecida como um problema para o qual empresas, organizações e até governos precisam se planejar. Frequentemente negligenciado é o fato de que a razão para modelar a incerteza é entender como ela afeta as decisões. A incerteza está sempre associada a processos de informação que chegam no futuro, então precisamos pensar em como uma decisão tomada agora é afetada por essa informação no futuro.
Projetando políticas
Uma política é um método para tomar uma decisão… qualquer método.
Políticas são funções que usam a informação na variável de estado para tomar uma decisão. Isso soa como um problema bem definido; afinal, a comunidade de aprendizado de máquina é construída inteiramente em torno do desafio de encontrar funções que se ajustem a um conjunto de dados de treinamento. No entanto, projetar políticas é muito mais rico, como evidenciado pela diversidade de comunidades que trabalham nessa área.
A Figura 1.2 mostra as capas de livros representando aproximadamente 15 campos distintos que lidam com decisões sequenciais sob incerteza. Eles usam oito sistemas notacionais diferentes e adotam abordagens fundamentalmente diferentes sobre como abordam a modelagem. Alguns confundem políticas (que envolvem problemas de otimização embutidos) com funções objetivo.
Métricas de desempenho de políticas
A otimização determinística é caracterizada por uma função objetivo que determina se uma decisão é melhor que outra. Com problemas de decisão sequencial, tipicamente teremos uma função objetivo que avalia o desempenho de uma política, como fizemos com as equações $\eqref{eq:objectivecumulativereward}$, $\eqref{eq:objectivecumulativerewardaverage}$ e $\eqref{eq:objectivecumulativerewardsample}$.
Na prática, porém, as políticas são escolhidas com base em vários critérios concorrentes:
- Qualidade da solução – Estamos tipicamente olhando para o desempenho (por exemplo, custos, lucros, resultados de saúde) ao longo de algum período de tempo, conforme expresso na versão amostrada do objetivo na equação $\eqref{eq:objectivecumulativerewardsample}$. Como isso é aleatório, temos que considerar o desempenho médio e o desempenho no pior caso.
- Requisitos computacionais – Em contextos operacionais, os tempos de execução importam. Assim como com o objetivo, o tempo que leva para calcular uma política é aleatório, então precisamos considerar o tempo médio de execução e os tempos de execução no pior caso.
- Transparência – Quão fácil é rastrear uma decisão de volta aos dados de entrada, que podem conter erros.
- Flexibilidade/adaptabilidade – Problemas do mundo real podem ser complicados, e frequentemente temos que nos adaptar a situações complexas.
- Complexidade metodológica – Se uma política está sendo implementada por um grupo interno de análise (por exemplo), eles terão que considerar a probabilidade de conseguirem fazer um método realmente funcionar.
- Requisitos de dados – Diferentes políticas têm diferentes requisitos de dados.
As comunidades de otimização matemática ilustradas na Figura 1.2 podem falar sobre políticas ótimas, o que implica otimizar a expectativa na equação $\eqref{eq:objectivecumulativereward}$. No entanto, é importante prestar atenção a todas essas características.
As quatro classes de políticas
Os livros na Figura 1.2 apresentam uma variedade de formas de tomar decisões ao longo do tempo. Acontece que todas elas podem ser divididas em classes bem definidas de políticas. Existem duas estratégias fundamentais para criar políticas, cada uma das quais pode então ser dividida em duas classes, criando quatro classes de políticas:
Busca de políticas – É quando você busca entre métodos (funções) para tomar decisões, simulando seu desempenho (como fazemos na equação $\eqref{eq:objectivecumulativereward}$), para encontrar o método que funciona melhor em média ao longo do tempo. Isso pode envolver a busca entre diferentes classes de métodos, bem como quaisquer parâmetros ajustáveis para um determinado método. Essa ideia abre duas classes de políticas:
- 1) Aproximações de função de política (PFAs) – São funções analíticas de um estado que especificam diretamente uma ação. A política de pedido até um nível-alvo (order-up-to) na equação $\eqref{eq:introorderupto}$ é um bom exemplo, junto com nossa política de usar uma previsão ajustada na equação $\eqref{eq:adjustedforecastpolicy}$.
- 2) Aproximações de função de custo (CFAs) – São políticas que envolvem resolver um problema de otimização que é tipicamente uma simplificação do problema original, com parâmetros introduzidos para ajudar a fazer a política funcionar melhor ao longo do tempo. Essa é uma ideia particularmente poderosa que é amplamente usada na indústria. Temos várias ilustrações de CFAs mais adiante no livro (começando pelo Capítulo 4, para aprender a melhor medicação para diabetes).
Políticas de horizonte de previsão – Podemos construir políticas eficazes otimizando através da contribuição (ou custo) de uma decisão, mais uma aproximação das contribuições (ou custos) posteriores resultantes da decisão tomada agora. Novamente, podemos dividir estas em mais duas classes de políticas:
- 3) Aproximações de função de valor (VFAs) – Imagine que estamos percorrendo uma rede representada na Figura 1.3, onde desejamos encontrar um caminho do nó 1 ao nó 11. Agora imagine que estamos no nó $S_t = i = 2$, onde $t$ conta quantos elos já percorremos. Seja $V_{t+1}(S_{t+1})$ o valor (assumindo que estamos maximizando) do caminho do nó $S_{t+1}$ (como os nós 4 ou 5) ao nó 11 (não se preocupe em como obtivemos $V_{t+1}(S_{t+1})$). Seja uma decisão $x_t$ o elo que percorremos ao sair do nó $S_t = i$. O valor de estar no nó $S_t$ seria dado por
A equação $\eqref{eq:bellmangraph}$ é conhecida como equação de Bellman. Quando usada para encontrar o melhor caminho em uma rede determinística como a que representamos na Figura 1.3, é bastante fácil de visualizar.
Há muitos problemas em que a transição do estado $S_t$ para $S_{t+1}$ envolve informação aleatória que não é conhecida no instante $t$. Vimos um exemplo simples de aleatoriedade em nosso primeiro problema de estoque, e um exemplo mais complicado em nosso segundo problema de estoque.
Para esses problemas mais gerais, se estamos em um estado $S_t$, tomamos uma decisão $x_t$, e então observamos nova informação $W_{t+1}$ (que não é conhecida no instante $t$), ela nos levará a um novo estado $S_{t+1}$ de acordo com nossa função de transição
\[S_{t+1} = S^M(S_t,x_t,W_{t+1}).\]Isso significa que no instante $t$, quando temos que escolher $x_t$, $W_{t+1}$ é uma variável aleatória, o que significa que $S_{t+1}$ é uma variável aleatória também. Nesse caso, temos que inserir uma esperança na equação de Bellman e escrever a equação $\eqref{eq:bellmangraph}$ como
\[\begin{align} V_t(S_t) = \max_{x_t} \big(C(S_t,x_t) + \E_{W_{t+1}} \left\{V_{t+1}(S_{t+1})\vert S_t,x_t\right\}\big). \label{eq:bellmanstochastic} \end{align}\]Aqui inserimos a esperança $\E_{W_{t+1}}\lbrace \cdot\rbrace $, que significa literalmente calcular a média sobre todos os resultados aleatórios de $W_{t+1}$.
A versão estocástica da equação de Bellman em $\eqref{eq:bellmanstochastic}$ é extremamente geral. O estado $S_t$ não significa apenas um nó em um grafo; ele captura qualquer (e toda) informação relevante para o problema. A dificuldade é que não podemos mais calcular a função de valor $V_t(S_t)$, o que por sua vez significa que não teremos acesso a $V_{t+1}(S_{t+1})$, que assumíamos conhecer nas equações $\eqref{eq:bellmangraph}$ e $\eqref{eq:bellmanstochastic}$.
A estratégia que a comunidade de pesquisa tem usado ao tentar aplicar a equação de Bellman é recorrer ao campo de aprendizado de máquina para estimar uma aproximação estatística que vamos chamar de $\Vbar_t(S_t)$. Assumindo que possamos elaborar uma aproximação razoável $\Vbar_{t+1}(S_{t+1})$, escreveríamos nossa política (nosso método para tomar uma decisão) usando
\[\begin{align} X^\pi(S_t) = \argmax_{x_t\in\Xcal_t} \big(C(S_t,x_t) + \E_{W_{t+1}} \{\Vbar_{t+1}(S_{t+1})\vert S_t,x_t\}\big). \label{eq:introvbarpolicy} \end{align}\]A notação “$\argmax_x f(x)$” significa o valor de $x$ que maximiza a função $f(x)$. O índice $\pi$ carrega a informação que especifica a estrutura da função $f$, e quaisquer parâmetros ajustáveis $\theta$ que precisaríamos na aproximação $\Vbar_{t+1}(S_{t+1})$.
Essa classe de política se enquadra em categorias como programação dinâmica aproximada e, mais frequentemente, aprendizado por reforço. Embora seja uma ideia poderosa, não é fácil de aplicar e depende de nossa capacidade de criar uma aproximação precisa $\Vbar_{t+1}(S_{t+1})$.
Existe uma literatura muito rica sobre métodos para aproximar funções de valor, mas não é uma panaceia. Este livro ilustrará essa ideia em alguns pontos, mas os leitores devem ser advertidos de que essa classe de políticas é bastante difícil de usar.
-
4) Aproximações de horizonte de previsão direto (DLAs) – Existem muitos problemas para os quais simplesmente não conseguimos desenvolver políticas eficazes usando nenhuma das três primeiras classes, e quando isso acontece, temos que recorrer às aproximações de horizonte de previsão direto. Vamos escrever isso em sua forma matemática completa mais adiante, mas por enquanto, vamos descrever as DLAs como a tomada de uma decisão agora enquanto se otimiza sobre um modelo (tipicamente aproximado) que se estende por algum horizonte de planejamento.
Uma DLA comum é criar um modelo aproximado que seja determinístico. É isso que fazemos quando usamos um sistema de navegação que encontra o caminho mais curto até o destino, assumindo que conhecemos o tempo de viagem ao longo de cada elo da rede. Como regra geral, resolver um modelo estocástico exato do futuro é quase sempre impossível, então vamos investigar diferentes estratégias para aproximar o problema.
Ilustramos nosso arcabouço de modelagem usando dois problemas de estoque, e sugerimos duas políticas simples (formas de PFAs) com as equações $\eqref{eq:introorderupto}$ e $\eqref{eq:adjustedforecastpolicy}$, mas fizemos isso apenas para ter um exemplo concreto de uma política. Embora as PFAs sejam amplamente usadas na tomada de decisão do dia a dia, esses são exemplos especializados.
Em contraste, vamos afirmar que as quatro classes de políticas que acabamos de delinear (PFAs, CFAs, VFAs e DLAs) são universais, no sentido de que cobrem qualquer método que possamos usar para resolver qualquer problema de decisão sequencial. Para ser claro, essas são meta-classes. Ou seja, se acharmos que um problema se presta a uma classe em particular, ainda não terminamos, pois ainda temos que projetar a política específica dentro da classe. Mesmo assim, sentimos que essas quatro classes fornecem um roteiro para guiar o processo de projeto de políticas.
Testando políticas
Para testar o valor de uma política, vamos usar a equação $\eqref{eq:objectivecumulativerewardsample}$, que simula uma política sobre uma única amostra de trajetória do processo de informação $W_t$. A parte mais difícil ao simular uma política é geralmente criar o processo de informação exógena.
Seja $\omega$ uma amostra de trajetória, onde $W_1(\omega), \ldots, W_T(\omega)$ representa uma amostra de trajetória particular. A Tabela 1.3 ilustra 10 amostras de trajetórias de preços que são indexadas de $\omega^1$ a $\omega^{10}$. Se escolhermos $\omega^6$, então $W_7(\omega^6) = 44.16$.
| $t=1$ | $t=2$ | $t=3$ | $t=4$ | $t=5$ | $t=6$ | $t=7$ | $t=8$ | |
|---|---|---|---|---|---|---|---|---|
| $\omega^n$ | $p_1$ | $p_2$ | $p_3$ | $p_4$ | $p_5$ | $p_6$ | $p_7$ | $p_8$ |
| $\omega^1$ | 45.00 | 45.53 | 47.07 | 47.56 | 47.80 | 48.43 | 46.93 | 46.57 |
| $\omega^2$ | 45.00 | 43.15 | 42.51 | 40.51 | 41.50 | 41.00 | 39.16 | 41.11 |
| $\omega^3$ | 45.00 | 45.16 | 45.37 | 44.30 | 45.35 | 47.23 | 47.35 | 46.30 |
| $\omega^4$ | 45.00 | 45.67 | 46.18 | 46.22 | 45.69 | 44.24 | 43.77 | 43.57 |
| $\omega^5$ | 45.00 | 46.32 | 46.14 | 46.53 | 44.84 | 45.17 | 44.92 | 46.09 |
| $\omega^6$ | 45.00 | 44.70 | 43.05 | 43.77 | 42.61 | 44.32 | 44.16 | 45.29 |
| $\omega^7$ | 45.00 | 43.67 | 43.14 | 44.78 | 43.12 | 42.36 | 41.60 | 40.83 |
| $\omega^8$ | 45.00 | 44.98 | 44.53 | 45.42 | 46.43 | 47.67 | 47.68 | 49.03 |
| $\omega^9$ | 45.00 | 44.57 | 45.99 | 47.38 | 45.51 | 46.27 | 46.02 | 45.09 |
| $\omega^{10}$ | 45.00 | 45.01 | 46.73 | 46.08 | 47.40 | 49.14 | 49.03 | 48.74 |
Tabela 1.3. Ilustração de um conjunto de amostras de trajetórias de preços, todas começando em $45,00.
A questão é: como criamos uma amostra de observações como as retratadas na Tabela 1.3? Existem três estratégias típicas:
- Criar amostras a partir de dados históricos. Como existe apenas um resultado em qualquer ponto no tempo, podemos criar múltiplas amostras de trajetórias combinando observações de diferentes períodos de tempo. Podemos escolher preços de diferentes anos, ou demandas de meses diferentes, ou tempos de viagem observados em dias diferentes. Essa abordagem não é possível quando a informação exógena depende do estado $S_t$ ou das decisões $x_t$.
- Simular a partir de um modelo matemático. Essa abordagem oferece a vantagem de poder gerar grandes amostras para obter estimativas estatisticamente confiáveis do desempenho de uma política. Esses modelos podem ser muito sofisticados, mas é bastante fácil criar modelos (mesmo sofisticados) que não reproduzam o comportamento dos dados reais. O maior desafio é capturar correlações, seja ao longo do tempo, seja entre amostras (por exemplo, as demandas de produtos diferentes, os preços de ações diferentes, ou a velocidade do vento em locais diferentes).
- Podemos testar uma ideia em campo, usando observações conforme elas realmente ocorrem. A vantagem disso é que estamos trabalhando com dados reais (a história pode não ser igual ao futuro). A desvantagem é que leva um dia para observar um dia de dados novos (e podemos precisar de muito mais do que um único dia de observações).
Se $W_{t+1}$ depende do estado $S_t$ e/ou da decisão $x_t$, então temos que conceber uma forma de refletir essa dependência. Criar um modelo matemático torna possível realizar muitas simulações no computador, mas criar amostras do processo de informação também requer recriar correlações ao longo do tempo, bem como no espaço. Remetemos o leitor ao RLSO, Capítulo 10, para uma discussão mais aprofundada sobre modelagem de incerteza.
Próximos passos
Os próximos cinco capítulos do livro vão aplicar nosso arcabouço de modelagem a cinco problemas diferentes:
- Capítulo 2 – Um problema de venda de ativos
- Capítulo 3 – Planejamento de mercado adaptativo
- Capítulo 4 – Aprendendo a melhor medicação para diabetes
- Capítulo 5 – Problemas de caminho mais curto estocástico - Estático
- Capítulo 6 – Problemas de caminho mais curto estocástico - Dinâmico
Cada um desses capítulos seguirá o mesmo esquema que usamos acima para descrever os dois problemas de estoque. Esse esquema consiste em:
- Narrativa – Uma descrição em português simples do problema.
- O modelo universal – Este modelo seguirá nosso formato de descrever os cinco elementos de um problema de decisão sequencial: variáveis de estado, variáveis de decisão, variáveis de informação exógena, a função de transição e a função objetivo.
- Modelo de incerteza – Aqui forneceremos um possível modelo de quaisquer incertezas no problema.
- Projetando políticas – Vamos sugerir possíveis políticas para tomar decisões. Escolhemos nossos problemas de forma que os cinco contextos de aplicação nos proporcionem um tour por todas as quatro classes de políticas. Por enquanto, vamos deixar o leitor tentar reconhecer qual das quatro classes estamos escolhendo.
- Extensão – Por fim, podemos sugerir uma ou mais possíveis extensões de nosso problema básico que podem exigir a mudança da política.
Depois retornamos às quatro classes de políticas no Capítulo 7 e discutimos nosso arcabouço geral de modelagem, usando os problemas dos Capítulos 2–6 para ilustrar diferentes ideias de modelagem.
Após essa discussão, retomamos nosso padrão de capítulos de ensino por exemplo, mas usando problemas mais complexos. Nossos capítulos restantes cobrem os seguintes problemas:
- Capítulo 8 – Armazenamento de energia I
- Capítulo 9 – Armazenamento de energia II
- Capítulo 10 – Gestão da cadeia de suprimentos I: O jornaleiro de dois agentes
- Capítulo 11 – Gestão da cadeia de suprimentos II: O jogo da cerveja
- Capítulo 12 – Otimização de cliques em anúncios
- Capítulo 13 – Problema de gestão de sangue
- Capítulo 14 – Otimizando ensaios clínicos
O que aprendemos?
- Para começar, aprendemos o que é uma decisão!
- Apresentamos um modelo geral, chamado de arcabouço universal de modelagem, para qualquer problema de decisão sequencial.
- Ilustramos o modelo usando primeiro um problema clássico de estoque, em que o estado do sistema é a quantidade em estoque.
- Depois, passamos para um problema de estoque um pouco mais complicado, em que a variável de estado inclui o estado do recurso $R_t$ de estoque, uma variável de estado informacional na forma de preço $p_t$, e finalmente um estado de crença sobre a demanda futura $\Dhat_{t+1}$ na forma de uma média e variância estimadas.
- Aprendemos como modelar o fluxo de informação exógena que pode chegar de várias fontes diferentes. A informação exógena é representada como uma função que pode depender do estado e/ou da decisão.
- Ilustramos duas formas de uma classe simples de política conhecida como aproximação de função de política (ou PFA).
- Aprendemos que as políticas podem ser avaliadas de várias maneiras diferentes, dependendo do contexto e de como as decisões são usadas.
- Encerramos com uma breve visão geral de quatro classes de políticas. Ilustrações de todas as quatro classes serão fornecidas nos Capítulos 2–6, momento em que fazemos uma pausa no Capítulo 7 para discutir as políticas com maior profundidade, preparando o terreno para os problemas mais complexos dos Capítulos 8–14.
Exercícios
Questões de revisão
- Quais são os cinco elementos do modelo matemático de um problema de decisão sequencial?
- Qual é a diferença entre as variáveis no estado inicial $S_0$ e aquelas no estado dinâmico $S_t$ para $t > 0$?
- Qual é a diferença entre uma decisão e a informação exógena?
- Quais são as duas grandes categorias de políticas, e como elas diferem?
- Compare as variáveis de estado do problema de estoque simples com as do problema de estoque mais complicado.
Questões de resolução de problemas
- Compare as políticas para os dois problemas de estoque em termos de como elas lidariam com um comportamento dependente do tempo. Por exemplo, nossa pizzaria pode ter demandas muito mais altas nos fins de semana do que nos dias úteis. Comente sobre o valor de tornar o parâmetro ajustável $\theta$ dependente do tempo (ou dependente do dia da semana) em termos de como isso poderia melhorar a solução.
- Contraste como você abordaria o ajuste do parâmetro $\theta$ para os problemas de estoque:
- Em um simulador.
- No campo.