第7章:応用、再考
ここまで一連の問題設定を見てきたので、いったん立ち止まり、これらの応用例を用いて、Chapter 1 で触れたモデリング上の論点をより深く掘り下げていきます。
Chapter 1 の在庫問題から始めて、これまでに6つのクラスの逐次決定問題を扱いました。それぞれの問題について、決定を行うための1つか2つの戦略を示しました。
- Chapter 1) 在庫問題 – 単純な在庫問題のバリエーションを用いて逐次決定問題を導入しました。方策には、order-up-to 方策と、調整済み予測に基づく方策が含まれます。
- Chapter 2) 資産の売却 – 金融資産をいつ売却するかを決める必要がありました。方策には、buy-low, sell-high のバリエーションが含まれます。
- Chapter 3) 適応的市場計画 – この問題では微分に基づく確率的探索を用い、逐次決定問題はステップサイズの選択であり、単純なパラメトリック関数を用いて示しました。
- Chapter 4) 最良の糖尿病治療法の学習 – これは多腕バンディット問題として知られる古典的な能動学習問題です。パラメータ化された最適化問題に基づく方策を設計しました。
- Chapter 5) 静的確率的最短経路 – 確率的最短経路問題の特定のバージョンについて、厳密に解ける古典的な動的計画法の再帰を用いて最適解を求め、その後、決定後状態変数を活用した近似動的計画法によって解く、より複雑な確率的バージョンを導入しました。
- Chapter 6) 動的確率的最短経路 – ここでは、期待経路コストの推定値が時間とともに変化する動的最短経路問題に切り替えます(Chapter 5 の静的なケースでは、期待コストの推定値は変化しませんでした)。これを用いて、基本的な決定論的先読み方策と、パラメータ化された先読み方策を示しました。
先に、4つのクラスの方策を導入しました。これまでに見てきた応用例では、4つのクラスそれぞれの例を見てきました。この章では、4つのクラスをより深く復習し、その後、応用例の集合に戻って、提案された各方策がどのクラスに属するかを特定します。
4つのクラスの方策
まず、4つのクラスの方策は2つのカテゴリに分けられることに注目します。すなわち、方策探索クラスと先読みクラスです。それぞれがさらに2つのクラスに分けられ、合計4つのクラスの方策が生まれます。以下でより詳しく説明します。
方策探索
「方策探索」クラスの方策は、決定を行うための関数の集合の中を探索し、その問題に適した目的を用いて、平均的に最もよく機能する関数を見つけるというものです。ほとんどの場合、これはパラメータ化された方策を特徴づけるパラメータ集合の最良の値を探索することを意味しますが、異なるパラメータ化を評価しなければならない場合もあります。
方策探索型の方策は2つのクラスに分けられます。
- 方策関数近似(PFA) – これは状態を行動に直接写す解析的な関数です。いくつかの例を挙げます。
- Chapter 2 で与えた「high-low」方策のようなパラメータ化された関数。ここに再掲します。
ここで $\theta^{sell-low} = (\theta^{low},\theta^{high})$ です。他の例としては、Chapter 1 で見た order-up-to 方策や、調整済み予測方策があります。
- 次のような線形関数
ここで $(\phi_f(S_t)),~f=1, \ldots, F$ は特徴量の集合です(「線形」とはパラメータベクトル $\theta$ について線形であることを意味します — 特徴量 $\phi_f(S_t)$ は $S_t$ について高度に非線形であってもかまいません)。例えば、ある映画をウェブサイトで広告するためにいくら入札するかを決めようとしている場合、特徴量は映画のジャンルや主演俳優・女優の名前かもしれません。
線形関数(「アフィン方策」としても知られる)は人気がありますが、上で示した buy-low, sell-high 方策や order-up-to 方策のようなステップ関数を近似するのに線形関数は使えないことに注意してください。
- 局所線形関数やニューラルネットワークのような高度な関数。ただしこれらは通常、調整が必要なパラメータ(ニューラルネットワークにおける重み)が非常に多くなります。
- コスト関数近似(CFA) – これは、パラメータ化された最適化問題を解くことを要する方策であり、目的関数または制約のいずれかをパラメータ化することがあります。CFA は高次元の決定問題を解く道を開きます。いくつかの例を挙げます。
- パラメータ化されたコスト関数近似の簡単な例は、Chapter 4 で導入した区間推定方策です。ここに再掲します。
- パラメータ化された最適化モデル – これは Chapter 6 で、リンクコストの $\theta$ パーセンタイルを選んだときに見ました。これは産業界で広く使われているヒューリスティックですが、研究文献では見過ごされてきました。航空会社は、大きな天候遅延がある状況下で航空機と乗務員の移動を最適化するためにこの考え方を使います。発電機のスケジューリングを計画する系統運用者は、発電機が故障しても需要をカバーできるように予備容量を挿入します。
PFA も CFA も、調整しなければならないパラメータを持ちます。唯一の違いは、方策が最適化問題を内部に埋め込んでいるかどうかです。どちらも非常に強力であり、さまざまな場面で広く使われています。
先読み近似
先読み近似に基づく方策は、いま決定を行うことによる下流のコスト(または報酬)を近似し、それを初期決定の初期コスト(または報酬)と併せて考えることで構成されます。
- 価値関数近似(VFA)に基づく方策 – これはベルマン方程式に基づく方策です。決定論的問題に対するベルマン方程式の最も基本的な形は、Chapter 5 で次のように最初に示されました。
$S_{t+1}$ への遷移が、時刻 $t$ には分かっていない情報($W_{t+1}$ に含まれる)を伴う問題が多くあり、これは $S_{t+1}$ が時刻 $t$ において確率変数であることを意味します。この場合、先に行ったように期待値を挿入する必要があり、次が得られます。
\[V_t(S_t) = \min_{x\in\Xcal_s} \big(C(S_t,x) + \E \{V_{t+1}(S_{t+1})\vert S_t,x\} \big).\]実際には通常、Chapter 5 の近似動的計画法の節で行ったように、価値関数 $V_{t+1}(S_{t+1})$ を近似 $\Vbar_{t+1}(S_{t+1})$ で置き換えなければなりません。こうした近似を研究する分野は、近似動的計画法、強化学習(計算機科学に起源を持つ)、適応動的計画法(工学の制御コミュニティで使われる用語)などの名前で呼ばれています。この場合、方策は次のように与えられます。
\[X^\pi(S_t) = \argmin_{x\in\Xcal_s} \big(C(S_t,x) + \E \{\Vbar_{t+1}(S_{t+1})\vert S_t,x\} \big).\]決定後状態 $S^x_t$ を使うなら、方策は次のように書けます。
\[X^\pi(S_t) = \argmin_{x\in\Xcal_s} \big(C(S_t,x) + \Vbar^x_t(S^x_t) \big),\]これは Chapter 5 で示しました。
価値関数を厳密に計算できる応用例を示すために、決定論的最短経路問題を用いました。これは確率的問題でも時に可能ですが、ほとんどの応用では近似的に行わなければなりません。課題は、効果的な方策を生み出すのに十分な品質の計算を行うことです。
価値関数に対する一般的な近似戦略は、次で与えられる線形モデルを使うことです。
\[\begin{align} \Vbar^x_t(S^x_t\vert \theta^{VFA}) = \sum_{f\in\Fcal} \theta^{VFA}_f \phi_f(S^x_t), \label{eq:hybridlinearvfa} \end{align}\]ここで $(\phi_f(S^x_t))_{f\in\Fcal}$ はユーザーが定義する特徴量の集合であり、$\theta^{VFA}$ は近似動的計画法のアルゴリズムを用いて選ばれるパラメータの集合です。
この線形モデルは、$n$ 回目の反復で状態 $S^n_t$ にいることの価値 $\vhat^n_t$ の「観測値」を収集することで当てはめます。$n-1$ 回の更新後の $\theta^{VFA}$ の推定値を $\thetabar^{VFA,n-1}$ とします。$\vhat^n_t$ を用いて $\thetabar^{VFA,n-1}$ を容易に更新し $\thetabar^{VFA,n}$ を得る方法があります。これにより、次のように書ける VFA 方策が得られます。
\[\begin{align} X^{VFA}_t(S_t\vert \theta^{VFA}) &= \argmax_x \big(C(S_t,x) + \Vbar^x_t(S^x_t\vert \theta^{VFA})\big) \nonumber \\ &= \argmax_x \left(C(S_t,x) + \sum_{f\in\Fcal} \theta^{VFA}_f \phi_f(S^x_t)\right). \label{eq:linearvfa} \end{align}\]線形モデルを用いて価値関数を近似することは非常に人気がありますが、得られる解の品質に関する理論的保証は実質的にありません。さらに悪いことに、結果が非常に悪くなりうるという経験的な証拠もあります。それでもなお、「数値を得る」ための容易な方法であるため、人気が続いています。
今日また人気があるのは、価値関数を近似するためにニューラルネットワーク(特に深層ニューラルネットワーク)を使うことです。ニューラルネットワークは、$f\in\Fcal$ のための特徴量集合 $(\phi_f(S_t))$ を設計する必要がなくなるため魅力的です。ただし、特に価値関数のノイズの多い観測値を扱わなければならない場合には注意が必要です。ニューラルネットワークの膨大な柔軟性が過学習を引き起こしうるからです。
-
直接先読み近似(DLA) – 最初の3つのクラスの方策は、何らかの形の関数近似を見つけることを要します。すなわち、方策そのもの(PFA)、最適化される関数(CFA)、あるいは下流状態にいることの価値(VFA)です。しかし、こうした関数近似がまったく不可能な問題も数多くあります。
DLA を解く「正しい」方法は、状態 $S_t$ から出発し、行動 $x_t$ を取り、ランダムな情報 $W_{t+1}$ を観測することで生じる状態 $S_{t+1}$ を起点として、将来における真の問題を解くことです。難しいのは、将来の不確実性 $W_{t+1}, W_{t+2}, \ldots$ をモデル化するのに加えて、最適な決定 $x_{t+1}, x_{t+2}, \ldots$ も行わなければならず、そのそれぞれがランダムな将来状態 $S_{t+1}, S_{t+2}, \ldots$ に依存することです。
かなり煩雑(そしておそらく恐ろしい)ですが、この方策は次を解くことを意味します。
式 $\eqref{eq:policiesDLA}$ を計算できるなら、最適方策が得られます。式 $\eqref{eq:policiesDLA}$ を厳密に解けることはごく稀です。Chapter 5 の基本的な確率的最短経路問題はその一例ですが、これは不確実性が特に単純な形で生じるためです。
ほとんどの応用では、近似先読みモデルを解くことによって $\eqref{eq:policiesDLA}$ を解くことに取り組みます。状態、決定、情報の列を
\[(S_0, x_0, W_1, \ldots, S_t, x_t, W_{t+1}, \ldots),\]と書く代わりに、時刻 $t$ に解くモデルのための、状態、決定、情報の簡略化された集合を作り、次のように表します。
\[(\Stilde_{tt}, \xtilde_{tt}, \Wtilde_{t,t+1}, \ldots, \Stilde_{tt'}, \xtilde_{tt'}, \Wtilde_{t,t'+1}, \ldots),\]ここで $\Stilde_{tt’}$ は通常、時刻 $t$ に決定を行う際に作成する先読みモデルにおける、先読みモデル内の時刻 $t’$ の簡略化された状態変数です。$\xtilde_{tt’}$ は先読みモデル内の時刻 $t’$ について作成した(場合によっては簡略化された)決定であり、$\Wtilde_{tt’}$ は先読みモデル内の時刻 $t’$ における簡略化された情報過程です。決定 $\xtilde_{tt’}$ は先読み方策 $\Xtilde^{\tilde \pi}_t(\Stilde_{tt’})$ を用いて行われ、これは計算が容易であるという理由で選ばれた簡略化された方策であるのが通常です。
近似先読みモデルに基づく方策は次のように書けます。
\[\begin{align} X^{DLA}(S_t) &= \argmin_{x_t\in\Xcal}\Big(C(S_t,x_t) + {} \nonumber \\ & \ \Etilde_{\Wtilde_{t,t+1}} \Big\{\min_{\tilde \pi} \E_{\Wtilde_{t,t+2}, \ldots, \Wtilde_{tT}} \Big\{\sum_{t'=t+1}^T C(\Stilde_{tt'},\Xtilde^{\tilde \pi}_t(\Stilde_{tt'}))\Big\vert \Stilde_{t,t+1}\Big\} \Big\vert S_t,x_t\Big\}\Big). \label{eq:policiesapproximateDLA} \end{align}\]式 $\eqref{eq:policiesapproximateDLA}$ は、図 7.1 の決定木を用いて示されており、将来を見通す際に近似的な状態、決定、不確実性を用いることを図示しています。これらの近似を作ることには、技術と科学の融合が必要です。将来を正確にモデル化することと計算要件とのバランスを取りたいのです。
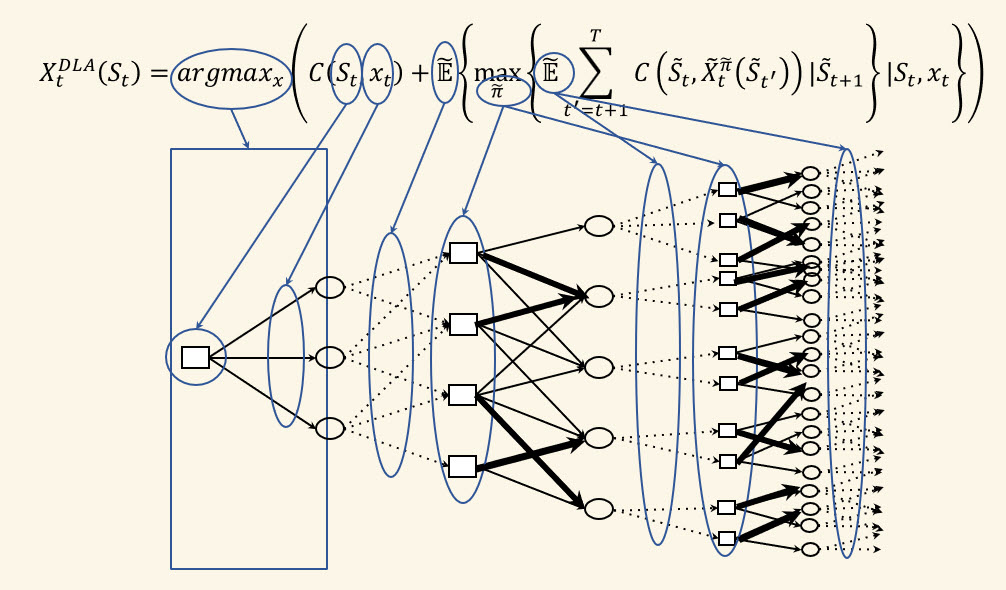
先読み方策 $\tilde \pi$(方策の中の方策と呼ばれることもあります)の設計は、問題に強く依存します。実際、4つのクラスの方策のいずれを使うこともできます。重要なのは、何度も計算しなければならないため、計算的に単純である必要があるということです。先読みモデルは厳密である必要はないことを思い出してください(ほとんどの場合、厳密な先読みモデルを使おうとすればまったく解けません)。そうではなく、将来に行うかもしれない決定を近似することによって、いま良い決定を生み出すと考えられる近似を選んでいるのです。
この手法の応用はすでに見てきた。Chapter 6 の動的最短経路問題では、決定論的な先読みモデルを解くという広く用いられている手法に頼った。そこでは、将来何が起こりうるかについての最良の推定値を用い、決定論的な最適化問題を解いた。この手法は将来の不確実性の影響を無視するが、パラメータ化された決定論的最適化問題を用いるという考え方を導入した。ただし、パラメータをチューニングしなければならない。
これら4つの方策クラス(PFA、CFA、VFA、DLA)は普遍的である。つまり、逐次決定問題(あらゆる逐次決定問題)に対して選ばれるどんな方策も、この4クラスのいずれかに属する。さらに、これらはハイブリッド方策の構成要素にもなりうる。
4つのクラスすべてを例示してきたが、ここで疑問が残る。どれを使えばよいかをどう判断するのか? 目的地への最良の経路を見つける場合のように、明らかに思えることもある。このような問題では、直接先読みが自然な選択となる。しかし、4つのクラスのどれもが有力な候補となる問題も存在する。
4つのクラスすべてをうまく実証できた問題が2つある。Chapter 1 の在庫問題と、Chapter 4 の糖尿病学習問題である。鍵となるのは、今日あまりにも頻繁に行われているように1つだけに注目するのではなく、4つのクラスすべてについて注意深く考えることである。
モデルの再考
本節では、まず状態変数の復習から始めて、さまざまな応用例を巡っていく。その後、これまでに見てきた方策を振り返り、4つのクラスに分類する。
状態変数の再考
学術文献では状態変数が何を意味するのかについてかなりの混乱がある。動的計画法、確率計画法、強化学習に関する書籍において、状態変数とは何かという定義が目立って欠落していることがその証拠である。
このパターンの唯一の例外として際立っているのが最適制御の文献であり、そこでは状態変数の定義がごく一般的である。制御コミュニティでは、状態変数は一般に「時刻 $t$ 以降のシステムをモデル化するために時刻 $t$ において必要なすべての情報」と定義される。しかし欠けているのは、時刻 $t$ 以降のシステムをモデル化するために正確にどのような情報が必要なのかについての記述である。
私たちは状態変数について2つの版を定義する(Reinforcement Learning and Stochastic Optimization、Section 9.4 より)。
状態変数とは:
a) 方策依存版 – 履歴の関数であって、外生情報(および方策)と組み合わせることで、コスト/貢献関数、決定関数(方策)、およびコスト/貢献関数と決定関数に必要な情報をモデル化するために遷移関数が要求する任意の情報を計算するのに必要十分なもの。
b) 最適化版 – 履歴の関数であって、コスト/貢献関数、制約、およびコスト/貢献関数と制約に必要な情報をモデル化するために遷移関数が要求する任意の情報を計算するのに必要十分なもの。
この2つの版が必要なのは、方策の構造を指定したシステムを扱う場合、その方策が必要とする情報をすべて含めることを確実にしなければならないからである。たとえば在庫問題があり、2つの方策を検討するとしよう。1つは将来需要の予測を用いる方策、もう1つは単に発注点補充(order-up-to)方策である。予測は確かに関連がありそうに見えるが、発注点補充方策を用いるならば予測は使われないので、状態変数には含まれないことになる。
ここまでの応用例を一巡し、それぞれの状態変数を振り返っておくと役に立つ。各応用について状態変数を要約する。状況に応じて $S_t$ あるいは $S^n$ と書き、その要素を物理状態変数 $R_t$、情報変数 $I_t$、信念状態変数 $B_t$ に分類していく。
Chapter 1 – この章では2つの在庫問題を導入したが、これらは状態変数のさまざまな趣を引き出すようにも設計されていた。単純な在庫問題は、時刻 $t$ における在庫 $R^{inv}_t$ だけからなる状態変数 $S_t$ によって特徴づけられた。この問題は動的計画法を説明するために最も広く使われている応用の1つである。
より複雑な在庫問題では、次の状態変数が必要であった。
\[S_t = (\underbrace{R^{inv}_t}_{R_t},\underbrace{c_t}_{I_t},\underbrace{f^D_{t,t+1},\sigmabar^D_t,\sigmabar^f_t}_{B_t}).\]この状態変数は、状態変数における3つのクラスの情報すべてを示している。物理状態変数 $R_t = R^{inv}_t$、その他の情報 $I_t = c_t$、そして信念状態変数 $B_t = (f^D_{t,t+1}, \sigmabar^D_t, \sigmabar^f_t)$ である。ここで $(f^D_{t,t+1},\sigmabar^D_t,\sigmabar^f_t)$ は将来需要 $\Dhat_{t+1}$ の予測平均と誤差の標準偏差、および時刻 $t$ から $t+1$ への予測の変化の標準偏差を表す(予測の変化の平均は0と仮定する)。
Chapter 2 – この章では、次の状態変数をもつ単純な資産売却問題を導入した。
\[S_t = (R^{asset}_t, p_t).\]ここで物理状態変数 $R_t$ はまだ資産を保有しているかどうかを表し(株を何株保有しているかを表すこともできた)、情報状態 $I_t = p_t$ は株を売却する価格である。
また、次式を用いて資産価格の平滑化推定値を計算するという考え方も導入した。
\[\pbar_t = (1-\alpha) \pbar_{t-1} + \alpha \phat_t.\]そして、価格 $p_t$ がこの平滑化推定値からどれだけ乖離しているかに基づいて意思決定を行う方策を設計した。このとき状態変数は次のようになる。
\[S_t = \big(\underbrace{R^{asset}_t}_{R_t}, \underbrace{(p_t,\pbar_t)}_{I_t}\big).\]さて、時刻 $t$ に株を売却すると決めたとき、未知の価格 $p_{t+1}$ で売却し、それが次のように推移するとしよう。
\[p_{t+1} = \eta_0 p_t + \eta_1 p_{t-1} + \eta_2 p_{t-2} + \varepsilon_{t+1},\]ここで $\varepsilon_{t+1}$ は平均0のノイズ項である。このとき状態変数は次のようになる。
\[S_t = \big(\underbrace{R^{asset}_t}_{R_t}, \underbrace{(p_t,p_{t-1},p_{t-2})}_{I_t}\big).\]Chapter 3 – ここでは、次式で与えられる古典的な確率的探索の反復に従って進む勾配ベースの探索アルゴリズムを説明した。
\[\begin{align} x^{n+1} = x^n + \alpha_n \nabla_x F(x^n,W^{n+1}). \label{eq:stochasticgradientaltransitionrevisited} \end{align}\]この手続きは $x$ の最良値を探索する方法だが、これはステップサイズ $\alpha_n$ が決定である逐次決定問題である。$\alpha_n =1/n$ のような決定論的な式でステップサイズを選ぶなら、探索手続きの「状態」は
\[S^n = (x^n).\]となる。しかし、次のような適応的(確率的)ステップサイズ公式を使うかもしれない。
\[\begin{align} \alpha_n = \frac{\theta}{\theta + N^n - 1} \label{eq:adaptivealpharevisited} \end{align}\]ここで $N^n$ は勾配 $\nabla_x F(x^n,W^{n+1})$ が向きを変えた回数であり、この場合 $N^n$ を知る必要があるので、状態変数は次のようになる。
\[S^n = (x^n,N^n).\]Chapter 4 – 糖尿病問題は純粋な学習問題の一例であり、薬剤に対する患者の真の反応 $\mu_x$ を学習しようとしている。いくつかの薬剤を試した後、私たちの信念は次の状態で表せるだろう。
\[S^n = (\underbrace{\mubar^n_x, \sigmabar^n_x}_{B^n})_{x\in\Xcal},\]ここで真の反応は $\mu_x \sim N(\mubar^n_x, (\sigmabar^n_x)^2)$ と仮定する。
この信念モデルは、患者ごとに異なる信念をもつ場合には機能するかもしれないが、おそらく私たちは、その薬剤が全患者にわたってどのように働くかについての知識体系から出発する。これは初期状態
\[S^0 = (\mubar^0_x, \sigmabar^0_x)_{x\in\Xcal}.\]として表せるだろう。ここで、$n$ 番目の患者が属性 $a^n$(性別、体重、喫煙歴、…)をもって到着したとしよう。薬剤 $x$ に対する患者の反応は、薬剤と患者の属性の両方に依存する。つまり、状態変数(すなわち意思決定を行うために利用できる情報)は、私たちが制御しない情報(患者の属性 $a^n$)と、私たちが制御する情報(薬剤の選択 $x^n$)から構成される。したがって、状態変数(意思決定に用いる情報)を次のように書くことになる。
\[S^n = (\underbrace{a^n}_{I^n}, \underbrace{(\mubar^n_x, \sigmabar^n_x)}_{B^n})_{x\in\Xcal},\]ここでは $a^n$ を情報状態変数 $I^n$ に、変数 $(\mubar^n_x, \sigmabar^n_x)$ を信念状態変数 $B^n$ に入れることにした。
Chapter 5 – 確率的最短経路問題では、旅行者がリンクを通過する際にランダムなコストを被るが、ノード $i$ でどのリンク $(i,j)$ を通るかを決定する前にはコストの平均と分散しか知らないという基本的な問題から始めた。この問題では、旅行者の状態は $t$ 本のリンクを通過した後に位置しているノード $N_t$ にすぎず、次のようになる。
\[S_t = N_t.\]次に、ノード $i$ にいる旅行者が、リンク $(i,j)$ を通った場合に被る実際のコスト $\chat_{tij}$ を見ることができる問題へと移行した。この追加情報により、状態変数は次のようになる。
\[S_t = \left(\underbrace{N_t}_{R_t},(\underbrace{\chat_{t, N_t, j}}_{I_t})_{j\in\Ncal^+_i}\right).\]Chapter 6 – リンク $(i,j)$ 上の推定コスト $\cbar_{tij}$ が時間とともに変化する動的最短経路問題を考えた。すなわち、時刻 $t+1$ において、$\cbar_{t+1}$ と表す更新された推定値の集合が与えられると仮定する。旅行者がノード $N_t= i$ にいるとしよう。すると、(旅行者にとっての)システムの状態は次で与えられる。
\[S_t = (\underbrace{N_t}_{R_t}, \underbrace{\cbar_t}_{I_t}).\]ここで、$p_t$ と表す経路——現在のノード $N_t$ から目的地へ到達するために計画しているリンクの集合——を旅行者に提示するとしよう。ちょうど経路を更新し、旅行者に新しい経路を受け入れるかどうか尋ねたとする。彼が「はい」と答えれば、ナビゲーションシステムは再最適化を続けるが、旅行者が受け入れたばかりの最新の経路 $p_t$ に留まることに対して小さなボーナスを導入する(これは、ほぼ同等な2つの経路の間でシステムが振動するのを防ぐために行われる)。
$p_t$ が最も最近受け入れられた経路であれば、これは将来の意思決定に必要な情報である。この場合、状態変数は次のようになる。
\[S_t = (\underbrace{N_t}_{R_t}, (\underbrace{\cbar_t,p_t}_{I_t})).\]これらの決定問題は、3種類の状態変数すべてを示してきた。すなわち、物理状態変数 $R_t$、情報状態変数 $I_t$、信念状態変数 $B_t$ である。$R_t$ だけの問題、$B_t$ だけの問題、そして $(R_t, I_t)$ や $(I_t, B_t)$ のような $I_t$ との組み合わせ、さらには3つすべての $(R_t, I_t, B_t)$ を見てきた。$R_t$ と $I_t$ の区別は時に恣意的になりうることを強調しておくが、物理的または金融的な資源の管理(購入、売却、移動、変更)を伴い、物理的・金融的資源に影響を与える(あるいはそれによって制約される)決定を伴う問題は非常に多いため、資源のためだけに特別なクラスを設けることが必要だと考えた。
不確実性を伴う問題の多くは学習も伴い、しかも決定が観測内容に影響を与えうる(糖尿病の例のように)ため能動的学習を伴う場合もあると考える。モデル作成者が逐次決定問題に信念状態変数を含めることに慣れるにつれ、それらがより頻繁に使われるようになるだろうと予想している。
方策の再考
6つの応用設定(および場合によってはその拡張)は、4つの方策クラスそれぞれを浮き彫りにするように選ばれた。以下では、さまざまな方策を振り返り、それらが属するクラスを特定する。
Chapter 1 – 2つの在庫問題を導入した。1つは次の形の発注点補充方策を用いた。
\[X^\pi(S_t\vert \theta) = \begin{cases} \theta^{max} - R_t & \text{if } R_t < \theta^{min}, \\ 0 & \text{otherwise,}\end{cases}\]もう1つは、在庫を予測需要にバッファを加えた水準まで引き上げる方策を用いた。
\[X^\pi(S_t\vert \theta) = \max\{0,f^D_{t,t+1}-R_t\} + \theta.\]これらの方策はいずれも1つまたは2つのチューニング可能なパラメータを含む。どちらも最適化演算子($\min$ や $\max$)を内包しない解析的な関数である。これらは方策関数近似(PFA)の際立った特徴である。
Chapter 2 – この章では、資産をいつ売却するかを決める問題を扱った。いくつかの方策が提案されたが、代表的な例は次の「セル・ロー(sell-low)」方策
\[X^{sell-low}(S_t\vert \theta^{low}) = \begin{cases} 1 & \text{if } p_t < \theta^{low} \text{ and } R_t = 1, \\ 1 & \text{if } t=T, \\ 0 & \text{otherwise.}\end{cases}\]と、「トラッキング方策」
\[X^{track}(S_t\vert \theta^{track}) = \begin{cases} 1 & \text{if } p_t \geq \pbar_t + \theta^{track}, \\ 1 & \text{if } t=T, \\ 0 & \text{otherwise.}\end{cases}\]である。これらの方策はいずれも、チューニング可能なパラメータをもつパラメトリック関数であるという点で「発注点補充」在庫発注方策と類似しており、方策関数近似(PFA)のさらなる例である。これが資産売却問題を解く唯一の方法というわけでは決してないが、このクラスの方策はウォール街でかなり人気がある。
PFA はその単純さと透明性から実務で人気があるが、次のことを心に留めておくことが重要である。単純さの代償はチューニング可能なパラメータであり…そしてチューニングは難しい!
第 3 章 – 適応的市場計画 – この問題では、広く用いられている勾配ベースの探索法(式 $\eqref{eq:stochasticgradientaltransitionrevisited}$ を参照)を使い、ステップサイズ $\alpha_n$ が決定となる。もし決定論的な問題であれば、$\alpha_n$ を次の 1 次元最適化問題を解くことで計算するだろう。
\[\alpha_n = \argmax_{\alpha \geq 0} \big(F(x^n + \alpha \nabla_x F(x^n))\big),\]これは直接先読み近似(DLA)の一形態である。しかし、不確実性を扱わなければならない場合、1 次元探索は期待値 $F(x) = \E F(x,W)$ を計算できる必要があることを意味し、これは実際には一般に不可能である。代わりに、次のような決定論的方策を用いるかもしれない。
\[\alpha^\pi_n(\theta) = \frac{\theta}{\theta+n-1},\]ここではこれをパラメータ化された関数(すなわち PFA の一形態)として書いている。また、式 $\eqref{eq:adaptivealpharevisited}$ で与えられる適応的(状態依存の)方策も示した。そこでは $n$ を、勾配が方向を変えた回数を数えるカウンタ $N^n$ に置き換えた(あるいは目的関数が改善しなかった回数を数えることもできる)。この方策は次のように書ける。
\[\alpha^\pi_n(S^n\vert \theta) = \frac{\theta}{\theta+N^n-1},\]ここで状態 $S^n$ は情報 $N^n$ を保持している。
補足:PFA 型の方策は確率的勾配アルゴリズムで普遍的に使われている。実際にそれが最良である可能性はあるが、現実には他の 3 つの方策クラスを試した人は誰もいない。検討してみる価値はあるだろう。
第 4 章 – 最良の糖尿病治療の学習 – これは純粋な学習問題であり、上側信頼限界(upper confidence bounding)として知られる非常に人気のある方策クラスを用いてアプローチした。おそらく最もよく知られた UCB 方策は次で与えられる。
\[X^{UCB}(S^n\vert \theta^{UCB}) = \argmax_{x\in\Xcal} \left(\mubar^n_x + \theta^{UCB} \sqrt{\frac{\log n}{N^n_x}}\right).\]非常によく機能する別の変種は、もともと区間推定(interval estimation)として導入されたもので、次で与えられる。
\[X^{IE}(S^n\vert \theta^{IE}) = \argmax_{x\in\Xcal} \left(\mubar^n_x + \theta^{IE} \sigmabar^n_x \right).\]最後に、1933 年に最初に発見され、その後数年前に再発見された変種がトンプソンサンプリングであり、次で与えられる。
\[X^{TS}(S^n\vert \theta^{TS}) = \argmax_{x\in\Xcal} \muhat^n_x.\]ここで $\muhat^n_x$ は平均 $\mubar^n_x$、分散 $\theta^{TS} \sigmabar^n_x$ の正規分布からランダムにサンプリングされる。
これら 3 つの方策はいずれも 2 つの特徴を共有していることに注意しよう。すなわち、最適化演算子(これらの方策では $\argmax_x$)と調整可能なパラメータである。これらはパラメータ化された最適化問題と見ることができ、パラメトリック・コスト関数近似(すなわち CFA)のクラスに属する。
CFA 方策は実務では広く使われているが、糖尿病の応用のような学習方策という特定の応用を除いては、学術文献ではほとんど注目されてこなかった。この考え方が後の章で全く異なる設定に適用されるのを見ることになる。
第 5 章 – 静的確率的最短経路 – 最初の確率的最短経路問題では、旅行者が確率的なコストを負担するが、それはリンクを通過した後にのみ知られると仮定した。この仮定により、問題を決定論的最短経路問題として解くことができ、それはベルマン方程式を用いて容易に解ける。得られる方策は次で与えられる。
\[X^\pi_t(S_t=i) = \argmin_{j\in\Ncal^+_i} \big(\cbar_{tij} + V_{t+1}(S_{t+1}=j)\big).\]ここで $S_t = N_t = i$ は旅行者がいるノードである。価値関数 $V_t(S_t)$ は時間を逆向きに進めて計算され、$t=T$ から始めて、すべてのノード $S_T$ について $V_T(S_T) = 0$ と設定する。これは価値関数近似に基づく方策の一形態であり、VFA 方策が実際に最適となる稀なケースである。
次に、旅行者がノード $i = N_t$ から出るコスト $\chat_{tij}$ を見ることができる、より難しい問題に移った。この問題では、状態変数は $S_t = (N_t, (\chat_{t,N_t,j},~j\in\Ncal^+_i))$ となる。この問題では、決定後状態 $S^x_t = N^x_t$ を用いて価値関数を近似しなければならなかった。ここで $N^x_t$ は、ノード $N_t$ にいるときに決定 $x_t$ を行った後に向かうことを選んだノードである。この場合、方策は次のようになった。
\[X^\pi_t(S_t=i) = \argmin_{j\in\Ncal^+_i} \big(\chat_{tij} + \Vbar^x_t(S^x_t)\big).\]これも再び VFA ベースの方策であるが、今回は $\Vbar^x_t(S^x_t)$ がデータから推定しなければならない近似であるため、もはや最適ではない。しかし、注意深く扱えば、漸近的に最適な方策を考案することができる。
第 6 章 – 動的確率的最短経路 – ここでは、各リンク $\cbar_{tij}$ の推定コストが時間とともに変化する問題に遭遇する。すなわち、時刻 $t$ において $\cbar_t$ は推定リンクコストのベクトルであり、それが次の時間期には $\cbar_{t+1}$ となる。これは、状態変数が旅行者のいるノードだけである $S_t = N_t$ から、極めて高次元の状態変数である $S_t = (N_t, \cbar_t)$ へと遷移することを意味する。これは近似動的計画法をもってしても取り組めない問題である(この状態変数を中心に構築された VFA を想像するのは困難である)。
代わりに、先読みモデルを使うという考え方を提案する。そこでは、旅行者がネットワークを進むにつれて推定リンクコストのベクトル $\cbar_t$ が時間とともに変化するという事実を無視する。代わりに、それが固定されている(そして決定論的であるとしよう)と仮定できる。これにより、実質的に決定論的最短経路問題である先読みモデルが得られるが、我々が最適化しているのは決定論的な先読みモデルであること、すなわちこれは DLA 方策であることを忘れてはならない。もちろん、これを最適に解く方法は知っているが、近似的な先読みモデルの最適解は最適方策ではない!
決定論的先読みは人気があるが、複雑にすることなくさらに良くする方法がある。その考え方は、平均 $\cbar_t$ ではなくコストの $\theta$ パーセンタイルを使うことを提案したときに導入した。$\ctilde_{tij}(\theta)$ を、時刻 $t$ に分かっていることを所与としたリンク $(i,j)$ のコストの $\theta$ パーセンタイルとしよう。そして、コスト $\ctilde_{tij}(\theta)$ を用いて決定論的先読みモデルを解く。これでパラメータ化された決定論的先読みモデルが得られ、これはパラメトリック CFA と DLA のハイブリッドである。
オンライン目的とオフライン目的
方策の性能を評価する視点は 2 つある。
- オンライン学習 – 現場で進めながら学ばなければならない場面は多い。例えば、製品の最良価格、混雑した都市を通る最良経路、あるいは血圧を下げる患者に最適な薬剤を学習しようとしているかもしれない。これらのいずれの場合でも、分かっていることを所与としてできるだけ良い結果を出したいが、同時に将来より良い決定ができるよう学習も続けている。これは、学習している間の成績を捉えるために、時間(または反復)にわたる累積報酬を最大化する必要があることを意味する。
- オフライン学習 – 他のケースでは、実験室環境で学習できる。それは物理的な実験室(異なる材料を試験したり、マウスへの薬剤の効果を観察したり)、コンピュータシミュレータ、あるいは(製品を評価する)テストマーケットや(薬剤を試験する)臨床試験として実施される現場環境かもしれない。実験室環境(「オフライン」)で学習しているのであれば、成績の良し悪しを気にせず試行錯誤を行う意思がある。代わりに、我々が気にするのは最終的な解の品質だけであり、これは最終報酬を最適化したいことを意味する。
オンラインとオフラインという用語について一言注意しておく。機械学習のコミュニティでは、「オフライン」とは単一のバッチデータセットを用いたモデルの推定を指す。対照的に、オンライン学習はデータが時間とともに到着する完全に逐次的な設定を指すのに使われる。これは通常、(医院に到着する患者を観察するような)何らかの外生的プロセスによってデータが生成される現場の状況であり、我々が「オンライン」という用語を使うときに想定するのと同じ設定である。しかし、機械学習では「オンライン」はシミュレーションで使われる反復的アルゴリズムを指すのにも依然として使われるだろう。
逐次決定問題を扱う分野全体が、最終報酬に着目するか累積報酬に着目するかで分かれている。例えば、「確率的探索」に取り組むコミュニティは最終報酬に焦点を当てる傾向があり、一方「多腕バンディット問題」(確率的探索問題の一形態)に取り組むコミュニティは一般に累積報酬を最適化する。実のところ、どちらの目的にも同じ方策を使うことができるが、選んだ目的に合わせて調整しなければならない。
オンライン(累積報酬)最適化
方策探索を行う際には、通常 $X^\pi(S_t\vert \theta)$ と書けるパラメータ化された方策を持っている。決定 $x_t = X^\pi(S_t\vert \theta)$ は製品の価格、血圧薬の選択、あるいは広告クリックを最大化するために入れる入札額かもしれない。これらすべての場合において、進めながら学習しなければならず、それは学習しながら性能を最大化する必要があることを意味する。
$C(S_t,x_t)$ を我々の性能指標(収益、血圧の低下、広告クリックからの純収益)とする。次の最適化問題を解く方策 $X^\pi(S_t\vert \theta)$ を生み出す $\theta$ を見つけたい。
\[\begin{align} \max_\theta F^\pi(\theta) = \E_{S_0} \E_{W_1, \ldots, W_T\vert S_0} \left\{\sum_{t=0}^T C(S_t,X^\pi(S_t\vert \theta))\vert S_0\right\}, \label{eq:derivativebasedonline} \end{align}\]ここで $S_{t+1} = S^M(S_t, X^\pi(S_t\vert \theta),W_{t+1})$ である。$\eqref{eq:derivativebasedonline}$ における期待値は、$W_1, \ldots, W_T$ のすべての可能な実現、および初期状態 $S_0$ に含まれる不確実なパラメータの可能な値(市場反応に関する不確実な初期信念や、ある人が薬にどう反応するかなど)にわたって取られる。
式 $\eqref{eq:derivativebasedonline}$ は「オンライン」あるいは「累積報酬」目的関数の例であり、ある期間にわたるすべての報酬の和を最大化したいからである。これは、価格からの収益や特定の患者に対する薬剤の効果のように性能を学習しなければならないオンライン学習問題において特に興味深く、学習のプロセスとできるだけ良い成績を出そうとすることのバランスを取ることを意味する。
オフライン(最終報酬)最適化
オフラインの設定では、通常 $N$ 回の実験という予算がある。オフラインの微分不要学習を説明するのにしばしば使われる古典的な(適切とは言えないが)問題は、第 3 章 で扱った新聞売り子問題である。復習として、新聞売り子問題は次のように書かれる。
\[F(x) = \E_W \big(p \min\{x,W\} - cx\big),\]ここで $x$ は単価 $c$ で発注する資源の量であり、これが需要 $W$($x$ を選ぶ時点では未知)を満たすために使われる。$W$ の分布は未知であると仮定する。
$x^n = X^\pi(S^n\vert \theta)$ を、$S^n$ に捉えられた既知情報を所与とした $x$ の選択とする。ここで方策 $X^\pi(S^n\vert \theta)$ は $\theta$ 内の 1 つ以上のパラメータに依存する。$x^n$ を実行した後、$W^{n+1}$ を観測し、$S^{n+1}$ を更新して、そのプロセスを繰り返す。$N$ 回の反復の後、$x^{\pi,N}(\theta)$ と表す最終設計が得られる。
次に、最終設計 $x^{\pi,N}(\theta)$ を評価しなければならない。この評価を行うには、2 つ、場合によっては 3 つの不確実性の源を考慮する必要がある。第 1 に、$W$ の平均のような未知パラメータに不確実性があるかもしれない。例えば、$W$ が平均 $\mu$ のポアソン分布から来ているかもしれず、$p_k = Prob[\mu = \mu_k]$ として $\mu \in \lbrace \mu_1, \ldots, \mu_K\rbrace $ と仮定するかもしれない。分布 $(p_k)_{k=1}^K$ は初期状態 $S_0$ に含まれる。
次に、平均 $\mu$ の分布からサンプリングされる需要 $W^1, \ldots, W^N$ のランダムな到着がある。これらの観測と方策 $X^\pi(S^n\vert \theta)$ を用いて $x^{\pi,N}(\theta)$ を計算する。$x^{\pi,N}(\theta)$ が、(決定論的かランダムかにかかわらず)$S^0$ 内の任意の情報に依存する確率変数であることを認識するのが重要である。
$x^{\pi,N}(\theta)$ を計算した後、それがどれだけうまく機能するかを評価するために最終のシミュレーション一式を実行しなければならない。最終設計の評価に使う $W$ のサンプルを表すために、新しい確率変数 $\What$ を導入する。
この記法により、オフライン学習の目的関数を次のように書くことができる。
\[\begin{align} \max_\theta F^\pi(\theta) = \E_{S^0} \E_{W^1, \ldots, W^N\vert S^0} \E_{\What\vert S^0} F(x^{\pi,N}(\theta),\What).\label{eq:derivativebasedoffline} \end{align}\]期待値を書くのは、ランダムな情報にわたって平均を取らなければならないことを示す方法にすぎないことを強調しておく。これらの期待値を計算する問題は次に扱う。
方策の評価
累積報酬($\eqref{eq:derivativebasedonline}$ で与えられる)と最終報酬($\eqref{eq:derivativebasedoffline}$ で与えられる)の目的関数はいずれも期待値を用いて書かれており、これはランダムなものにわたって平均を取るという意味である。数学的に書くには良いが、これらは実質的にほぼ決して計算可能ではない。
期待値を取る必要があるときはいつでも、サンプリングを通じて期待値を推定するつもりだと仮定すると理解しやすくなります。まず、$\eqref{eq:derivativebasedonline}$で与えられる累積報酬目的についてこれをどう行うかを示します。ここでは、初期状態$S_0$の中に不確実な量が含まれているかもしれません。たとえば、市場が価格にどう反応するかの不確実性、油井によるメタン生成量、あるいは患者が薬にどう反応するかなどです。次に、外生情報$W_1, \ldots, W_T$があります。これは販売の観測値、大気温度の変化、あるいは患者が投薬にどう反応するかなどです。
$\omega$を、これらすべての不確実な量のサンプル実現値としましょう。これらすべての不確実な量のサンプル集合を生成し、集合$\Omega = \lbrace \omega^1, \ldots, \omega^K\rbrace $に保存すると仮定します。したがって、$W_t(\omega)$と書くときはいつでも、これは時刻$t$に観測するもののサンプル実現値です。方策$X^\pi(S_t\vert \theta)$を用いている場合、遷移関数によって支配される状態$S_t(\omega)$、決定$x_t(\omega) = X^\pi(S_t(\omega)\vert \theta)$、外生情報$W_{t+1}(\omega)$のサンプルパスをたどることになります。
\[S_{t+1}(\omega) = S^M(S_t(\omega), x_t(\omega), W_{t+1}(\omega)).\]サンプル観測値の集合$\Omega$を用いて、期待値$F^\pi(\theta)$を次のように近似できます。
\[\begin{align} \Fbar^\pi(\theta) = \frac{1}{K} \sum_{k=1}^K \sum_{t=0}^T C(S_t(\omega^k),X^\pi(S_t(\omega^k)\vert \theta)). \label{eq:simulatedcumulativereward} \end{align}\]最終報酬目的を用いている場合、まず$x^{\pi,N}(\theta)$を推定する必要があります。サンプルパス$\omega$をたどるなら、最終的な設計を$x^{\pi,N}(\omega\vert \theta)$と書くことになります。ここで$\omega$は、$(S_0(\omega), W_1(\omega), \ldots, W_T(\omega))$によって与えられる学習を実行するために用いたすべてを捉えています。
次に、$\What$に含まれるテストデータを用いて設計$x^{\pi,N}(\omega\vert \theta)$を評価する必要があります。$\psi$を$\What$のサンプル実現値とし、$\omega$に対してサンプル集合$\Omega$を持つと仮定したのと同様に、$\Psi = \lbrace \psi^1, \ldots, \psi^L\rbrace $で与えられる$\What$のサンプル結果の集合を作成すると仮定しましょう。$\What$は、設計$x^{\pi,N}$を評価するために必要な任意のシミュレーション情報を表すことに注意してください。それは確率変数の集合(患者の属性、天候、市場条件)かもしれませんし、時間とともに変化する情報を表すことさえあります。言い換えれば……何でもありです。
さて、最終報酬設定における方策の性能の推定値は次のように書けます。
\[\begin{align} \Fbar^\pi(\theta) = \frac{1}{K} \frac{1}{L} \sum_{k=1}^K \sum_{\ell=1}^L F(x^{\pi,N}(\omega^k),\What(\psi^\ell)). \label{eq:simulatedfinalreward} \end{align}\]両者をまとめる
式$\eqref{eq:derivativebasedonline}$は、学習過程の間の総性能を最大化しなければならないオンライン、つまり累積報酬の目的関数を示しています。式$\eqref{eq:derivativebasedoffline}$は、設計を固定した後に平均的に最も良く機能する最良の設計を探索しなければならないオフライン、つまり最終報酬の目的関数を示しています。現時点で重要なのは、どちらの問題も次を解くことを含むという点です。
\[\begin{align} \max_\theta F^\pi(\theta), \label{eq:searchovertheta} \end{align}\]ここで$F(\theta)$は未知の関数であり、ノイズを伴う形でサンプリングできます。
$\eqref{eq:searchovertheta}$の目的関数を拡張して、異なる方策クラスにわたる探索を含めることができます。$\Fcal$を、主要なクラス(PFA、CFA、VFA、DLA)およびそれぞれのクラス内の異なる関数を含む、すべての可能な方策タイプの集合を表すものとします。次に$\Theta^f$を、選択した方策クラス$f\in\Fcal$に対応するすべての可能なパラメータベクトル$\theta$の集合とします。この場合、最適化問題は次のように書けます。
\[\max_{\pi=(f\in\Fcal, \theta\in\Theta^f)} F^\pi(\theta).\]実際には、直感と問題の構造の理解を用いて方策クラス$f\in\Fcal$を選ぶ傾向がありますが、これは必ずしも自明ではありません。読者には直感と常識を使う準備をしつつ、4つのクラスすべてを認識しておくよう強くお勧めします。これは4つのクラスすべてをテストしなければならないという意味ではありませんが、なぜその選択をしたのかを説明できるようにしておくべきです。
次に、$\theta$にわたる最適化の問題に移ります。$\theta$は連続で、多くの場合ベクトル値であると仮定します。$\theta$を見つけるために適用できる探索手法には、微分ベースと微分不要という2つの大きなクラスがあります。
初期状態への依存性
累積報酬目的(式$\eqref{eq:derivativebasedonline}$など)を用いているか最終報酬目的(式$\eqref{eq:derivativebasedoffline}$など)を用いているかにかかわらず、$\theta$の最適化は初期状態$S_0$に依存します。これは、$S_0$の情報を変えると、方策の選択を含めて結果が変わる可能性があることを意味します。
初期状態$S_0$は、何らかの形でシステムの挙動に影響を与えるあらゆる情報を含みます。決定論的なパラメータ、不確実なパラメータに関する分布、さらには探索アルゴリズムの開始位置さえ含まれるかもしれません。
最適解が$S_0$内の情報に依存することは、アルゴリズムに関する文献で広く見落とされています。この依存性を捉えるために関数$\theta(S_0)$を計算できれば良いのですが、この関数を推定することは扱いにくいものです。これは、$S_0$が変われば$\theta$を再最適化しなければならないかもしれないことを意味します。それ自体は問題ないのですが、$S_0$が変わる状況は数多くあり、単にそれがかなり難しいという理由だけで$\theta$を再最適化しないことがあります。
これは読者が認識しておくべきことです。
微分ベースの方策探索
次の問題を解こうとしていると仮定します。
\[\begin{align} \max_\theta F(\theta), \label{eq:maxFtheta} \end{align}\]ここで$F(\theta)$は$\theta$に関する何らかのパラメトリック関数です。さらに$\theta$はベクトルであり、勾配を計算できると仮定します。
\[\nabla_\theta F(\theta) = \begin{pmatrix} \frac{\partial F(\theta)}{\partial \theta_1} \\ \frac{\partial F(\theta)}{\partial \theta_2} \\ \vdots \\ \frac{\partial F(\theta)}{\partial \theta_K} \end{pmatrix}.\]実際には、導関数を厳密に計算することはしばしば不可能です。
高次元のパラメータベクトルを扱うのに有用な手法が、Spall (2003) によって開発された同時摂動確率近似(SPSA)であり、次のように勾配を近似します。$Z_p, p=1, \ldots, P$を、平均0の確率変数の実現値のサンプル(正規分布に従うかもしれません)とします。$Z^n$を、反復$n$における実現値を持つ$p$次元ベクトルとします。$x^n+\eta^nZ^n$および$x^n-\eta^nZ^n$を用いて、$x^n$をベクトル$Z$によって摂動させることで勾配を近似します。ここで$\eta^n$はスケーリングパラメータであり、反復を通じて定数であることも、変化する(通常は減少する)こともあります。
さて、$W^{n+1,+}$と$W^{n+1,-}$を、シミュレーションを駆動する確率変数の2つの異なるサンプルを表すものとします(これらは事前に生成することもその場で生成することもできます)。そしてシミュレーションを2回実行します。1回は$F(x^n + \eta^nZ^n,W^{n+1,+})$を求めるため、もう1回は$F(x^n - \eta^nZ^n,W^{n+1,-})$を求めるためです。すると勾配の推定値は次で与えられます。
\[\begin{align} \nabla_\theta F(\theta^n,W^{n+1}) \approx \begin{bmatrix} \dfrac{F(x^n + \eta^nZ^n,W^{n+1,+}) - F(x^n - \eta^nZ^n,W^{n+1,-})}{2\eta^nZ^n_1} \\[6pt] \dfrac{F(x^n + \eta^nZ^n,W^{n+1,+}) - F(x^n - \eta^nZ^n,W^{n+1,-})}{2\eta^nZ^n_2} \\[6pt] \vdots \\[6pt] \dfrac{F(x^n + \eta^nZ^n,W^{n+1,+}) - F(x^n - \eta^nZ^n,W^{n+1,-})}{2\eta^nZ^n_P} \end{bmatrix}. \label{eq:SPSAgradient} \end{align}\]式$\eqref{eq:SPSAgradient}$における勾配の各要素の分子は同じであることに注意してください。つまり、必要な関数評価は$F(x^n + \eta^nZ^n,W^{n+1,+})$と$F(x^n - \eta^nZ^n,W^{n+1,-})$の2回だけです。唯一の違いは各次元$p$に対する分母の$Z^n_p$です(これがSPSAの魔法です)。(SPSAの解説についてはReinforcement Learning and Stochastic Optimization、Chapter 5、section 5.4.4を参照してください。)
SPSAの「魔法」について簡単に注意を述べると、勾配はかなりノイズが多くなり得ます。このため、一般的な戦略は、摂動させた各シミュレーションを複数回実行(文献ではミニバッチと呼ばれます)して平均を取ることです。ミニバッチの適切なサイズは問題の特性に依存するので、このパラメータの調整にある程度の時間を費やすことを見込んでおいてください。
どのように勾配を計算するにせよ、探索アルゴリズム(Chapter 3で見たもの)は次で与えられます。
\[\theta^{n+1} = \theta^n + \alpha_n \nabla_\theta F(\theta^n,W^{n+1}).\]ここでステップサイズ$\alpha_n$の方策を選ばなければなりません。これについてはChapter 3で議論しましたが、ステップサイズ方策の徹底的な議論についてはReinforcement Learning and Stochastic Optimization、Chapter 6を参照してください。確率的勾配アルゴリズム自体が逐次決定問題であることを読者に思い出していただきます(Chapter 3で見たとおりです)。
微分不要の方策探索
微分不要の方策探索は、本書全体の焦点である逐次決定問題のもう一つの例に過ぎません。主な違いは、唯一の状態変数が最大化しようとしている関数についての信念となる点です(これはChapter 4の糖尿病の応用と同じです)。
以下のいずれかを用いて信念を形成できます。
-
ルックアップテーブル – $\theta$の取り得る値の集合を集合$\Theta = \lbrace \theta_1, \ldots, \theta_K\rbrace $に離散化できると仮定します。$F(\theta)$(あるいは$\mu_\theta$)が分からないため確率変数となる確率変数$\mu_\theta = F(\theta) = \E F(\theta,W)$を定義します。$\Fhat^{n+1} = F(\theta^n, W^{n+1})$をサンプリングする実験を実行できると仮定します。これらのサンプルを用いて、$\theta \in \Theta$の各離散値に対する推定値$\mubar^n_\theta$を作成できます。これがルックアップテーブル型の信念モデルになります。
最も単純な信念モデルは、独立な信念を持つルックアップテーブルであり、Chapter 4の糖尿病の応用で最初に見たものです。$\mubar^n_\theta$を、$n$回のサンプル(すべての実験にわたる)の後の、ある$\theta \in \lbrace \theta_1, \ldots, \theta_K\rbrace $に対する$\E F(\theta)$の推定値とします。$\sigmabar^n_{\theta_k}$を推定値$\mubar^n_{\theta_k}$の標準偏差とし、$\beta^n_{\theta_k}$を次で与えられる精度とします。
\[\beta^n_{\theta_k} = \frac{1}{(\sigmabar^n_{\theta_k})^2}.\] -
パラメトリックモデル – 次の形の線形モデルを推定するかもしれません。
\[F(\theta\vert \eta) \approx \eta_0 + \eta_1 \phi_1(\theta) + \eta_2 \phi_2(\theta) + \ldots\]ここで$\phi_f(\theta)$はベクトル$\theta$から計算される特徴量であり、$\theta,$ $\theta^2$、$\ln \theta$のような項からなるかもしれません。「線形モデル」とは係数$\eta$について線形であることを意味することに注意してください。特徴量$\phi_f(\theta)$は$\theta$の非線形関数であってもかまいません。
線形モデルは人気がありますが、局所的な近似に過ぎない可能性が高いです。適切な点の周りで線形モデルをフィットさせるなら、これは問題ではありません。問題は適切な点を見つけることです!
-
ノンパラメトリックモデル – ノンパラメトリックモデルは、ある点の集合(おそらくランダムに選ばれる)の周りでの関数の局所的近似と考えるのが最良です。推定値は定数(これが最も典型的)か、あるいは局所的に線形な近似かもしれません。
ノンパラメトリックモデルを作成する方法は数多くあります。おそらく最も一般的なのは、$\theta$に近い値$\theta_k$に対する$\mubar_{\theta_1}, \ldots, \mubar_{\theta_K}$を平均することによって推定値$\mubar_\theta$を作成することでしょう。本書ではノンパラメトリック手法を活用しませんが、これは主にそれらがデータを多く必要とし、使うのがやや扱いにくいためです。
Reinforcement Learning and Stochastic Optimization、Chapter 3では、関数を再帰的に推定するための多くの手法を説明しており、ルックアップテーブル、線形モデル、非線形モデルに対するいくつかの信念モデルを扱っています。この章はベイズモデルと頻度論モデルの両方も扱っています。糖尿病の例におけるルックアップテーブルの再帰式は既に見ており、更新はChapter 4の遷移方程式で与えられていました(これらの式はベイズ的信念モデルを仮定しています)。後ほど、線形モデルと非線形モデルの再帰的更新を説明します。
微分不要探索を実行するプロセスは、汎用モデリングフレームワークの5つの要素を用いてモデル化できます。
-
状態変数 – これは$\E F(x,W)$についての信念であり、$S^n = B^n$と書けます。信念状態をどのように保存するかは、ルックアップテーブル(およびどの種類のルックアップテーブル)を用いるか、線形または非線形モデルを用いるかに依存します。ルックアップテーブル信念モデルを用いる場合は、次を使います。
\[B^n = (\mubar^n_\theta,\beta^n_\theta),~\theta \in \{\theta_1, \ldots, \theta_K\}.\] - 決定変数 – 決定は、$\Fhat^{n+1} = F(x^n,W^{n+1})$を得るために関数を評価する$\theta$の値の選択$\theta^n$です。設計する必要のある方策$\Theta^\pi(S^n)$を用いて選択$\theta^n = \Theta^\pi(S^n)$を行います。
- 外生情報 – 通常、外生情報はサンプリングされた観測値$\Fhat^{n+1} = F(\theta^n,W^{n+1})$であると考えます。$\beta^W_\theta$を、点$\theta$で関数$F(\theta^n,W^{n+1})$を観測することによるノイズの精度(分散の逆数)とします。
-
遷移関数 – 遷移関数は、信念を更新するための再帰式の形をとります。たとえば、最良の糖尿病治療薬を探索していたChapter 4のルックアップテーブル信念の更新式です。再びルックアップテーブル信念モデルを用いると、遷移関数は次のようになります。
\[\begin{align} \mubar^{n+1}_\theta &= \frac{\beta^n_\theta \mubar^n_\theta + \beta^W_\theta W^{n+1}_\theta}{\beta^n_\theta + \beta^W_\theta},\label{eq:thetatransition1}\\ \beta^{n+1}_\theta &= \beta^n_\theta + \beta^W.\label{eq:thetatransition2} \end{align}\] -
目的関数 – 最も一般的なのは、$\theta$の最良値を探索するためにシミュレータをオフラインで使用することであり、これは最終報酬目的を意味します。$\theta^{\pi,N}$を、$N$回のサンプルの後に信念モデルから導かれるパラメータベクトル$\theta$の最良値とします。たとえば、ルックアップテーブル信念モデルを用いており、$N$回の実験の後に各選択$\theta$に対する推定値$\mubar^N_\theta$を得たなら、次を選ぶことになります。
\[\theta^{\pi,N} = \argmax_{\theta\in\Theta} \mubar^N_\theta,\]ここで$\theta^{\pi,N}$における上付き文字「$\pi$」は、$\mubar^N_x$を推定する際に用いた探索方策$\pi$の種類を反映しています。最良の方策$\pi$を探索する最適化問題は次のように書かれます。
\[\max_{\pi} \E_{S^0}\E_{W^1, \ldots, W^N\vert S^0} \E_{\What\vert S^0} F(\theta^{\pi,N},\What).\]
上で示したように、期待値はシミュレーションによって計算することを思い出してください。累積報酬については式 $\eqref{eq:simulatedcumulativereward}$、最終報酬については $\eqref{eq:simulatedfinalreward}$ で示しました。
ここで次の問いが残ります。探索方策 $\Theta^\pi(S^n)$ をどのように設計すればよいのでしょうか? 4つの方策クラスのいずれからでも選べるということは、もはや驚きではないでしょう。4つのクラスすべては Reinforcement Learning and Stochastic Optimization の第 7 章で詳しく議論されていますが、同書の第 12 章にある方策探索の議論も参照してください。
ここでの目的のために、比較的単純で自然な2つの方策を示します。
-
ルックアップテーブル型信念モデルに対する区間推定方策 – 糖尿病の設定についていくつかの方策を検討しましたが、特に効果的なものの一つは区間推定方策で、次式で与えられます。
\[\begin{align} \Theta^{IE}(S^n\vert \theta^{IE}) = \argmax_{\theta\in\Theta} \left(\mubar^n_\theta + \theta^{IE} \sigmabar^n_\theta \right). \label{eq:thetaIE} \end{align}\]ここで、$\theta^{IE}$ の最良の値を探索しなければなりません。これは、逐次決定問題(方策 $X^\pi(S_t\vert \theta)$ に対する最良の $\theta$ を見つけること)を解くための逐次決定問題(最良の $\theta^{IE}$ を見つけること)と考えてください。なお、探索の研究コミュニティでは、パラメータ $\theta^{IE}$ のチューニングは研究文献では通常見過ごされていますが、実務家はそれが必要であることを認識しています。
-
古典的な応答曲面法 – $x$ が連続である問題では、関数 $\E F(x,W)$ にパラメトリックモデルを当てはめるのが合理的です。今日ではニューラルネットワークを使いたくなるかもしれませんが、これらは高次元モデルであり、あらゆるノイズに過適合しがちであることに留意してください。$F(x,W)$ が高価である問題は多くあります。例えば、1時間以上かかるコンピュータシミュレーションであったり、実地実験が必要であったりします。
こうした理由から、よく用いられる戦略は次の形の線形モデルを使うことです。
\[\Fbar(x) = \sum_f \theta_f \phi_f(x),\]ここで $\phi_f(x)$ は入力ベクトル $x$ から抽出された特徴量です。入力 $x^0, \ldots, x^{n-1}$ を用いて $n$ 回の実験を行い、そこから応答 $\Fhat^1, \ldots, \Fhat^n$ を観測したと仮定します。このデータから、線形回帰の手法を用いて推定値 $\theta \approx \thetabar^n$ で線形モデルを当てはめることができ、次の近似が得られます。
\[\Fbar^n(x) = \sum_f \thetabar^n_f \phi_f(x).\]応答曲面法の文献では長らく、次に観測する点を見つけるために $\Fbar^n(x)$ を最適化する貪欲戦略が用いられてきました。すなわち次のように書けます。
\[\begin{align} x^n = \argmax_x \Fbar^n(x). \label{eq:responsesurfacegreedy} \end{align}\]この考えは直感的には魅力的ですが、近似 $\Fbar^n(x)$ に基づく最適値の最良推定と思われるものを使うことは、実際には $\E F(x)$ の最良近似を学習する方法としては非常にまずいことが分かります。
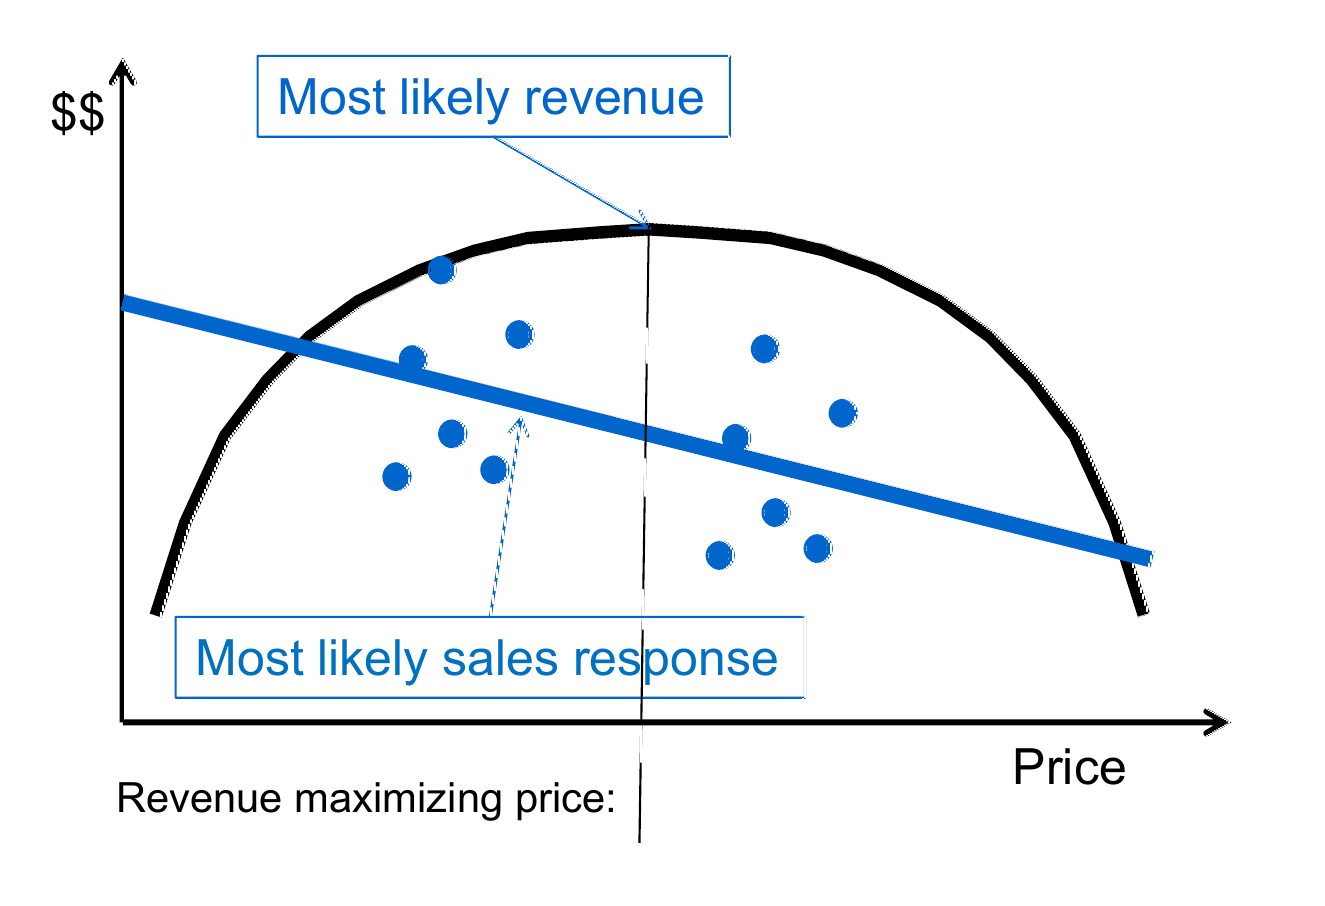
図 7.2 はパラメトリック関数を学習することの難しさを示しています。ここでは、価格の関数として需要を与える3本の線形需要応答曲線を $D(p) = \theta_0 - \theta_1 p$ の形で示しています。目標は収益 $R(p) = pD(p)$ を最大化することです。図 7.2(a) は3つの可能な需要曲線と対応する収益曲線を示しています。
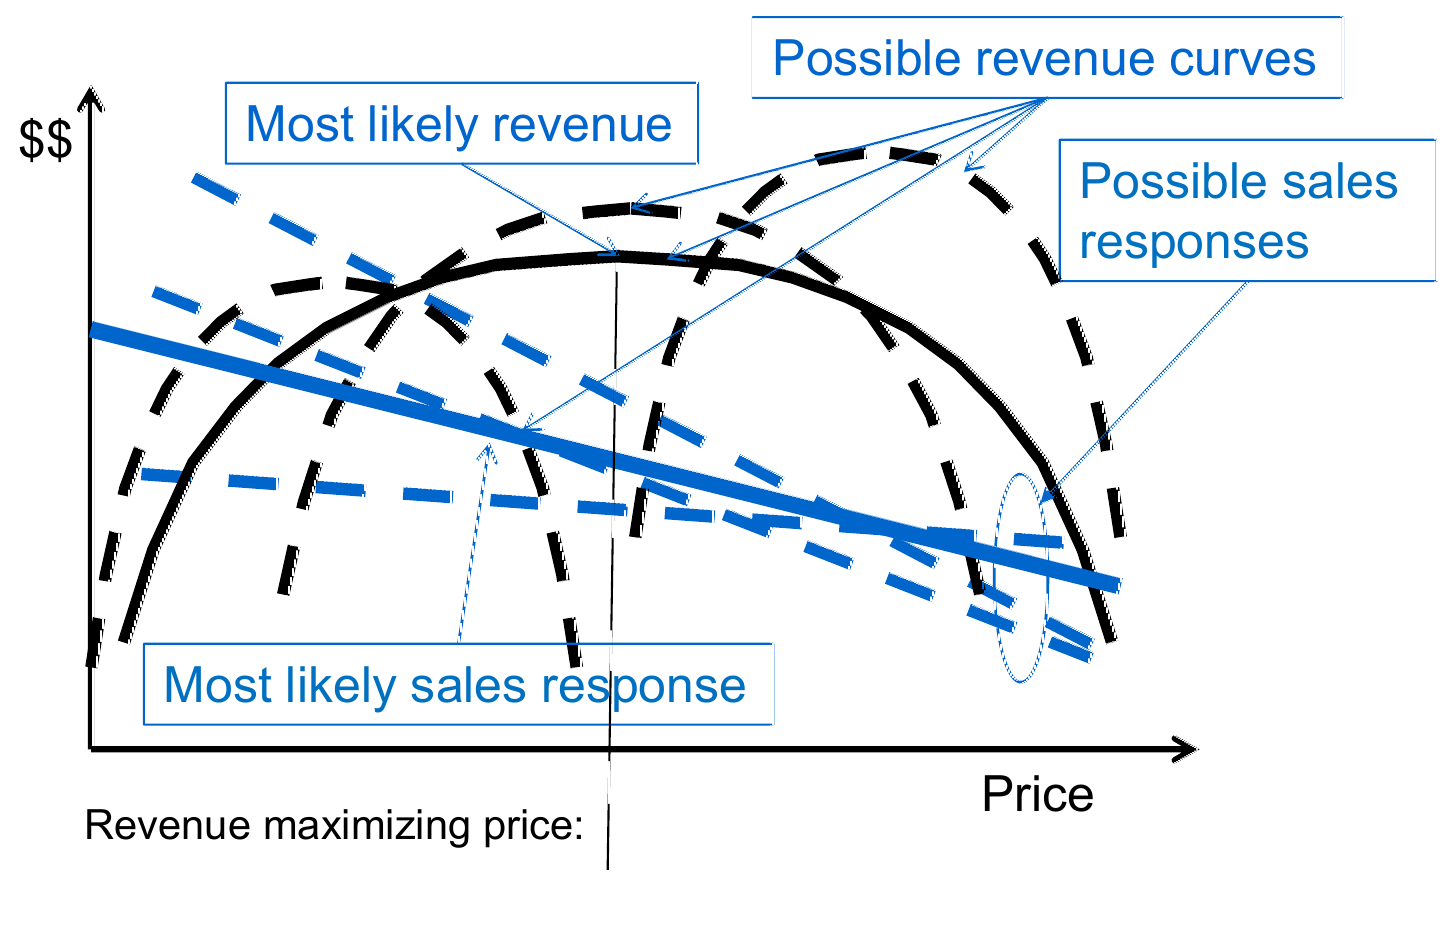
(a)
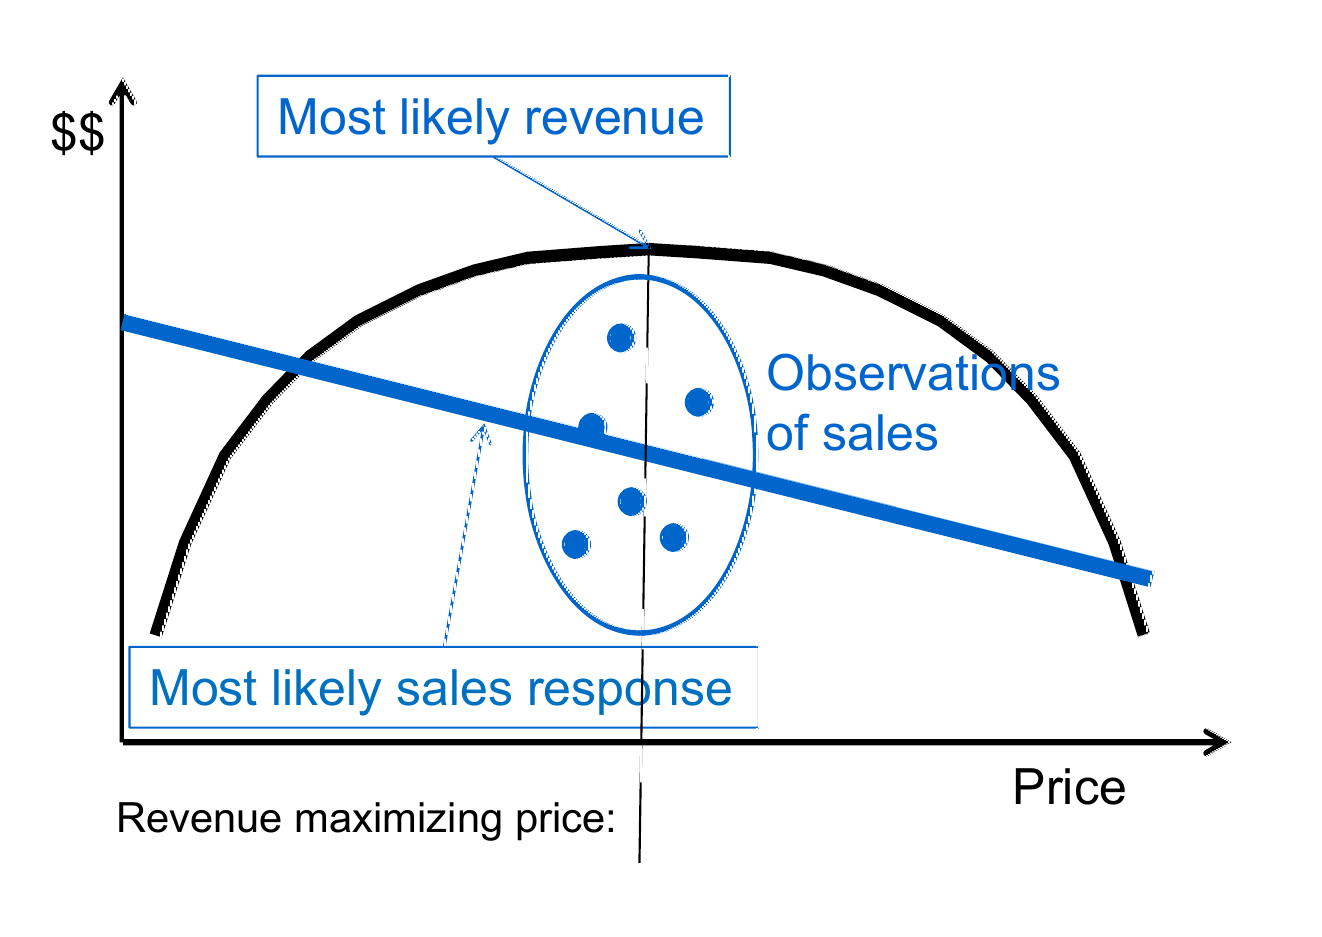
(b)
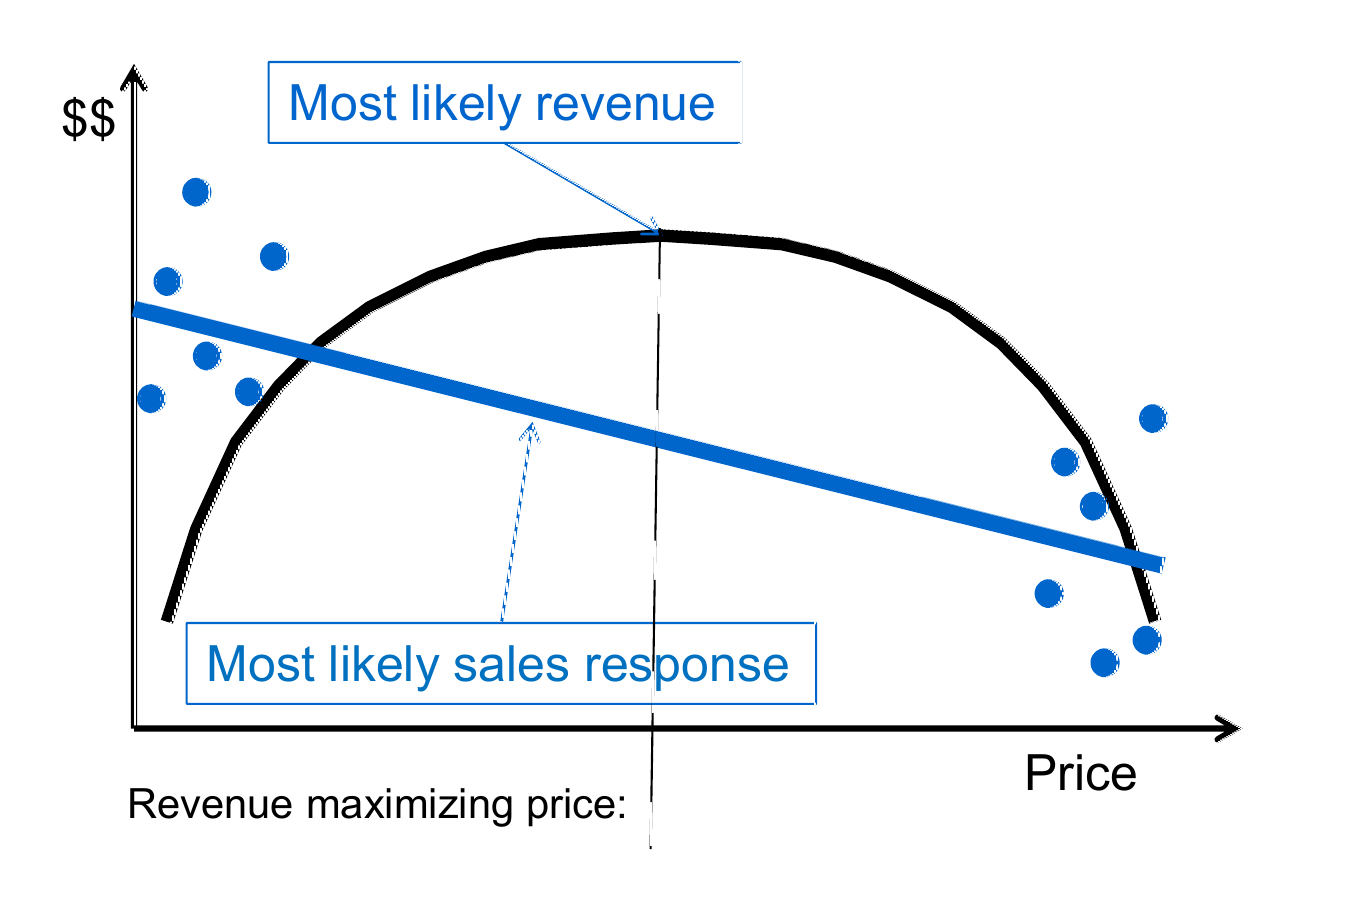
(c)
(d)
図 7.2(b) のように収益を最適化する価格を提示したくなりますが、これは点が一つの球状の塊に集まってしまい、需要曲線を推定することが難しくなります。需要曲線を推定する最良の方法は、図 7.2(c) のように極端に近い価格を提示することですが、これらの点では収益が非常に低いため、学習している間は儲けが出ません。
良いアプローチは「肩」の部分の点を試すこと、つまり最適点ではないが遠すぎない点を試すことで、これは図 7.2(d) に示す通りです。この振る舞いは次に述べる方策によって実現されます。
-
摂動を伴う応答曲面法 – 図 7.2 に示した探索と活用のトレードオフを克服する方策として、ナレッジグラディエントと呼ばれる1ステップ先読み方策があり、これは情報の価値が最大となる値を $x^n$ として選択します。情報の価値を最大化する点は、図 7.2(d) に示したサンプリングパターンを与えることが分かります。
ナレッジグラディエントはここでの説明には複雑すぎますが、同じ振る舞いを得るための非常に簡単な方法があります。$\eqref{eq:responsesurfacegreedy}$ のように見かけの最適点の現在の推定値 $x^n$ をそのまま取る代わりに、それを量 $\rho$ だけ摂動させます。ただし、これには2つの方法があります。
-
最適点乖離方策 – ここでの考え方は、最適点 $\xbar^n = \argmax_x \Fbar^n(x\vert \thetabar^n)$ から距離 $\rho$ にある点 $x^n$ を選ぶことです。$x$ が $k$ 次元ベクトルであれば、この乖離は平均 0、分散 1 の正規分布に従う $k$ 個の確率変数 $Z_1, \ldots, Z_K$ をサンプリングし、次が成り立つように正規化することで作れます。
\[\sqrt{\sum_{k=1}^K Z^2_k} = \rho.\]得られた $k$ 次元ベクトルを $\Zbar^n$ とします。そしてサンプリング点を次式で計算します。
\[x^n_k = \xbar^n_k + \Zbar^n_k.\]1次元の場合は $\Zbar^n = \pm \rho$ となることに注意してください。
-
励振方策 – ここでも再び、各要素が平均 0、分散 1 の $k$ 次元摂動ベクトル $Z^n$ を生成し、次のように設定します。
\[x^n_k = \Xbar^n_k + \rho Z^n_k.\]最適点乖離方策は $x^n$ を最適点 $\xbar^n$ から距離 $\rho$ に強制しますが、励振方策は単に平均 0 のランダムな摂動を導入するだけであり、これはサンプリングされる可能性が最も高い点が $\fbar^n(x\vert \thetabar^n)$ の最適点であることを意味します。
最適点乖離方策はオフラインの最終報酬目的に適しており、励振方策は累積報酬を最適化するオンライン設定にいるときの方が適していると考えられます。
-
何を学んだか?
- 4つの方策クラスを復習します。
- 前の6つの章で導入したすべての応用例を用いて、状態変数の異なるスタイルを対比し、4つの方策クラスのそれぞれを例示します。
- また、最終報酬と累積報酬の目的についても説明します。最終報酬の目的は、実験的な設定(実験室や現場)で観測を行い、最終的な設計の性能のみを気にする場合に生じます。累積報酬の目的は、実行しながら学習する場合に用いられます。
- パラメータ探索を行うための、微分に基づく探索法と微分を使わない探索法の両方を説明します。
- 微分に基づく確率的探索と微分を使わない確率的探索は、どちらも逐次決定問題であることを指摘します。
演習問題
復習問題
- PFA を他の3つの方策クラスと区別するものは何ですか?
- VFA と DLA を PFA と CFA から区別するものは何ですか?
- 第 1 章では、より複雑な在庫問題の状態変数は、物理状態変数 $R_t$、情報状態変数 $I_t$、信念状態変数 $B_t$ から構成されていました。信念状態変数を情報状態変数から区別するものは何ですか?
- オンライン学習とオフライン学習の目的関数の違いは何ですか?
- 微分に基づく確率的探索と微分を使わない確率的探索を逐次決定問題として説明しました。この2つの戦略のうちどちらが信念状態を使いますか。またなぜそれが必要なのですか?
問題解決演習
- 図 7.3 は決定論的なグラフを示しており、異なる目的の下でノード 1 からノード 11 への経路を見つけようとしています。
- 旅行者が単にノード 1 から 11 までの総移動時間を最小化したいだけで、現在 1-2-6-9 の経路をたどってきた場合、彼女の状態は何ですか?
- 次に、旅行者が時刻 45 までにノード 11 に到着しなければならないと仮定します。時刻 45 より後に到着した場合、遅延の2乗に等しいペナルティが課されます。これまでに経路 1-2-6-9 をたどってきた旅行者の状態は何ですか?
- 経路 1-2-6-9 をたどってきた旅行者が、経路上のいずれかのリンクにおける2番目に高いコストを最小化したい場合、状態は何ですか?
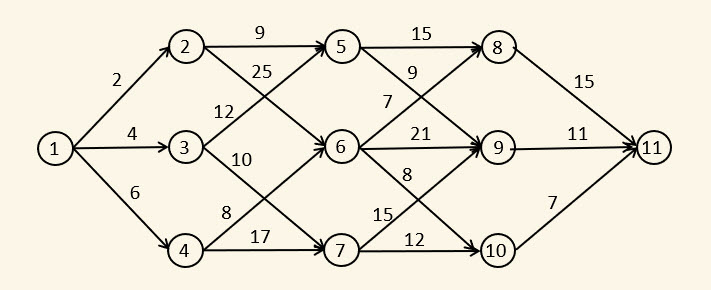
図 7.3. 決定論的なグラフ。 - 実話: ある金融テクノロジー企業(「フィンテック」)は、高頻度取引のためのアルゴリズム取引システムを持っています。時刻 $t$ において、ある資産が価格 $p_t$ で取引されているとき、彼らは1日以内のローリングホライズンにわたって価格がどう変化しうるかの予測の系列を用いて、価格が上がるか下がるかを推定します。ここで、時間は15分刻みで測られます。$t$ 時点の情報の下で行われた、時刻 $t'$ における資産の推定価格を $f_{tt'}$ とします。ここで、次式を用いて推定価格を作ります。
$$
\fbar_t(\theta) = \sum_{t'=t+1}^{t+H} \theta_{t'-t} f_{tt'},
$$
ここで $\theta = (\theta_1, \theta_2, \ldots, \theta_H)$ は、将来6時間分の各15分刻み(24 刻み)に対する重みのベクトルです。$x_t = 1$ は時刻 $t$ に売る決定を表し、$x_t = -1$ は買う決定、$x_t = 0$ は保持を表すものとし、方策は次の通りです。
$$
X^\pi(S_t\vert \theta) = \begin{cases} +1 & \text{if } \fbar_t(\theta) \geq p_t + 1.0, \\ 0 & \text{if } p_t - 1.0 < \fbar_t(\theta) < p_t + 1.0, \\ -1 & \text{if } \fbar_t(\theta) \leq p_t - 1.0. \end{cases}
$$
課題は重みベクトル $\theta$ を最適化することです。
- 時刻 $t$ において、このシステムの状態は何ですか?
- $X^\pi(S_t\vert \theta)$ はどの方策クラスに入りますか? 説明してください。
- シミュレータ内で過去データを用いて方策をシミュレートできると仮定します。パラメータベクトル $\theta$ が与えられたときの方策の期待性能を $F(\theta)$ とします。履歴の単一サンプルを用いて方策をシミュレートすると仮定して、この目的を書き出してください。
- シミュレータを用いて数値微分を計算する方法を説明してください。単一の要素 $\theta_\tau$ に対する数値微分だけを書いてください。