第1章: 逐次決定問題のモデル化
コンピュータ上で物理的な問題(特に逐次決定問題)を解くプロセスは、図 1.1 に示すように、数理モデルを構築することを必要とします。何十年もの間、研究コミュニティは、すべてのデータが事前に既知である決定問題(決定論的最適化として知られる)のための標準的な数理的枠組みを用いてきました。線形計画問題として知られる決定論的最適化問題の簡単な形は、次のように書けるでしょう。
\[\begin{align} \min_x c^T x, \label{eq:linearprogram1} \end{align}\]ここで $x$ は、通常次のように書かれる制約の集合を満たさなければならない要素のベクトルです。
\[\begin{align} A x & = b, \label{eq:linearprogram2}\\ x & \geq 0. \label{eq:linearprogram3} \end{align}\]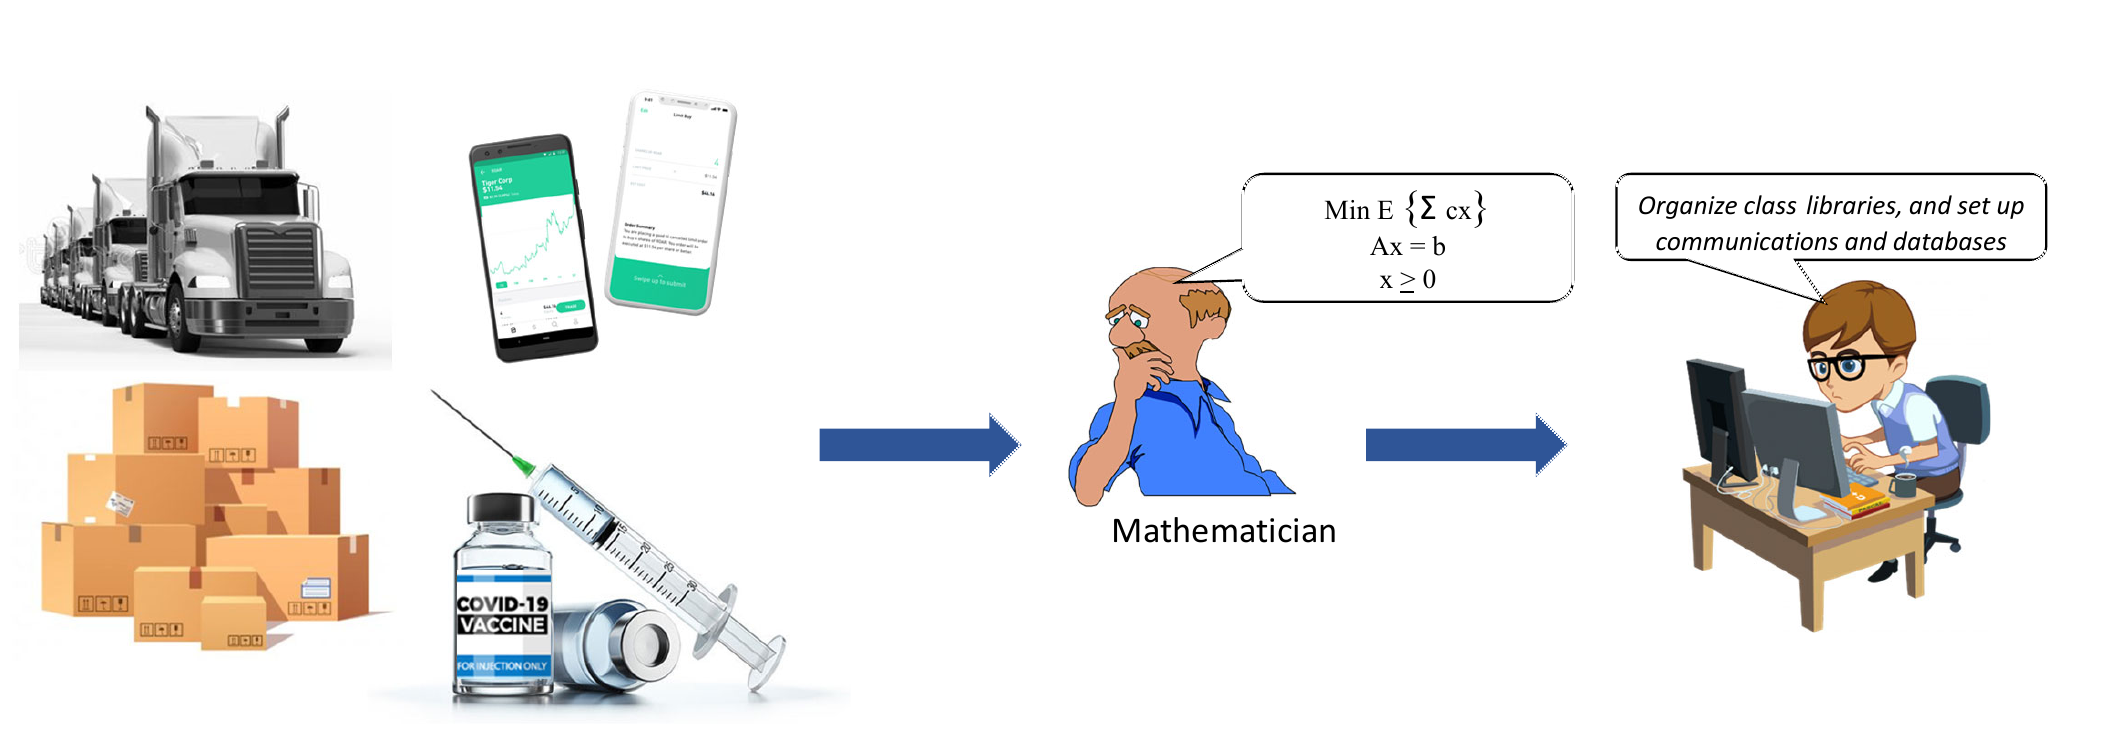
式 $\eqref{eq:linearprogram1}$–$\eqref{eq:linearprogram3}$ を理解する必要はありません(これには線形代数の基礎的な知識が必要です)が、毎年何千人もの学生が、この記法を学び、さらに幅広い物理的問題をこの記法に翻訳する方法を学ぶ講義を修了しています。そして、この形式の問題を解へと変換するソフトウェアパッケージが存在します。最も重要なのは、この記法という言語が世界中で通用するということです。同じことが統計モデリング/機械学習についても言えます。今日では、式 $\eqref{eq:linearprogram1}$–$\eqref{eq:linearprogram3}$ を理解する人々よりもはるかに大きなコミュニティとなっています。
しかし、逐次決定問題については同じことが言えません。これは少なくとも15の異なるコミュニティが、8つの根本的に異なる記法スタイルを用いて研究している問題クラスであり、しばしば高度な訓練を要する数学が使われます。本書では、逐次決定問題と呼ぶ非常に豊かな問題クラスをどのようにモデル化するかを、例を通して教えるスタイルで示します。比較的単純な問題に焦点を当てますが、私たちの枠組みはあらゆる逐次決定問題のモデル化に使えます。加えて、得られたモデルは直接ソフトウェアへと翻訳できます。
本書の分析的基盤は Reinforcement Learning and Stochastic Optimization: A unified framework for sequential decisions(RLSO)に含まれています。これは方法論を中心とした大学院レベルのテキストです。より深く知りたい読者のために、随所でこの本の内容に言及します。技術志向の読者には RLSO を参考文献として使うことをお勧めします。ただし、それは必須ではありません。本書は、たとえ一行もコードを書かない読者であっても、逐次決定問題について明確かつ正確に考えられるようになるための、一連の例という形で文脈的背景を提供することを目的としています。
本書は、確率と統計の講義を履修した学部生または修士課程の学生を対象としています(線形計画法の知識は必要ありませんが、線形計画問題を解く必要のある例が一つあります)。全体のモデリング枠組みの概観を与える第 1 章と、最初の6つの章を用いていくつかの重要な原理を示すために立ち止まる第 7 章を除き、すべての章は具体的な例を中心に構成されています。
本書の説明は、確率と統計の入門講義で期待される以上の数学を必要としないはずです。とはいえ、本書は、コンピュータソフトウェアの基礎となりうるほど正確な記法を用いて逐次決定問題を記述する方法を示すことを中心に据えています。
ほとんどの章には Python モジュールが付属しています。これらのモジュールは、本書全体を貫くモデリング枠組みに沿って書かれています。同時に、逐次決定問題をシミュレートするソフトウェアパッケージであれば、それがどのように解かれているかに関わらず、私たちが用いるモデリング枠組みに直接翻訳できます。この理由から、読者にはあらゆる記法をコンピュータプログラム中の変数として見ることをお勧めします。
はじめに
逐次決定問題は常に次のように書けます。
\[decision,\ information, \ decision, \ information, \ decision, \ldots\]決定を下すたびに、コストが発生したり、貢献または報酬を受け取ったりします(性能の測り方は多数あります)。決定は、私たちが方策と呼ぶ方法によって下されます。本書の中心的な焦点である主要な目標は、まだ到来していない情報の不確実性のもとで、時間を通じてうまく機能する効果的な方策を設計することです。
逐次決定問題は遍在しており、事実上あらゆる人間の営みにおいて生じます。表 1.1 は、生じうる決定の例とともに、分野の一覧のサンプルを示しています。これらの分野の多くには、おそらく多種多様な決定が存在します。資産をいつ売却するか、新しいウェブデザインを採用するかといったものから、設計すべき最良の薬剤・材料・施設を選ぶこと、さらには複雑なサプライチェーンの管理やトラック車両群の配車まで、複雑さはさまざまです。
| 分野 | 問い |
|---|---|
| ビジネス | どのような製品を、どのような特徴で販売すべきか。どの供給品を使うべきか。どの価格を設定すべきか。 |
| 経済学 | 経済の状態を踏まえ、連邦準備制度はどの金利を設定すべきか。市場流動性をどの水準で供給すべきか。 |
| 金融 | ポートフォリオはどの銘柄に投資すべきか。トレーダーは下振れに備えて契約をどうヘッジすべきか。 |
| インターネット | 広告クリックを最大化するにはどの広告を表示すべきか。どの映画が最も注目を集めるか。一斉通知はいつ・どのように送るべきか。 |
| 工学 | エアゾール缶から電気自動車、橋梁から交通システム、トランジスタからコンピュータまで、どのように装置を設計するか。 |
| 公衆衛生 | 疾病の進行を推定するために検査をどう実施すべきか。ワクチンはどう配分すべきか。どの人口集団を対象とすべきか。 |
| 医学研究 | どの分子構成が最も多くのがん細胞を殺す薬を生み出すか。単層ナノチューブを生成するにはどのような手順の組み合わせが必要か。 |
| サプライチェーン管理 | 中国からの在庫発注はいつ行うべきか。どのサプライヤーを使うべきか。 |
| 貨物輸送 | どのドライバーが荷物を運ぶべきか。トラック輸送業者はどの荷物の輸送を引き受けるべきか。ドライバーの拠点はどこに置くべきか。 |
| 情報収集 | 山火事や侵略的外来種の情報を収集するために、ドローンをどこへ送るべきか。疾病に対抗するためにどの薬剤を試験すべきか。 |
| マルチエージェントシステム | 寡占市場の大企業は、競合の反応を予測しながら、契約にどう入札すべきか。 |
| アルゴリズム | 探索アルゴリズムでどのステップサイズ則を用いるべきか。評価コストの高い関数を次にどの点で評価するかをどう決めるか。 |
Table 1.1. さまざまな分野と、各分野で下さなければならない決定のサンプル。
決定の種類をすべて列挙すること以上に難しいのは、多くの応用で生じるさまざまな不確実性の源を特定することです。人間の行動、市場、物理過程、輸送ネットワーク、エネルギーシステム、そして健康の分野で生じる幅広い不確実性は、不確実性の源の多様性の一端を示しています。
本書が執筆されている時点で、人類は COVID-19 の変異株の拡大に苦しんでいます。このパンデミックへの対処は「気が遠くなるほど複雑」[USA Today, 2020年9月8日] と評されてきましたが、これは実のところ、問題を構造的に考えることに失敗した副産物です。本書では、実用的な解へとつながる一連の基本的な構成要素へと問題を分解する方法を読者に示していきます。
私たちのアプローチは、性能指標、決定、不確実性の源といった中核的な要素を特定することから始まり、そこから問題の数理モデルの作成へとつながります。次のステップは通常(ただし常にではありませんが)そのモデルをコンピュータ上で実装することですが、さまざまな理由からコンピュータモデルの構築が現実的でない問題も数多く存在します。この理由から、現場でアイデアを検証・評価しなければならない問題も検討します。性能を改善するには、まず時間を通じて良い決定を下す方法を学ぶ必要があります(これがシステムを制御する方法です)。その後、システムの設計へと進みます。
現時点で、学術コミュニティは逐次決定問題のための標準的なモデリングプロセスを採用していません。これは、1950年代以来厳密な枠組みに従ってきた静的・決定論的最適化問題の領域とは著しい対照をなしています(式 $\eqref{eq:linearprogram1}$–$\eqref{eq:linearprogram3}$ はこの枠組みの一例です)。私たちのモデリングプロセスは RLSO での説明に基づいています。RLSO は、主にコンピュータ上でモデルを開発・実装することに関心のある技術的な読者を対象とした本です。
対照的に、本書は何よりもまず逐次決定問題について考える方法を学ぶことに関心のある、より幅広い読者を対象としています。本書は例を通して教えるスタイルを用い、モデリングプロセスを伝えることに焦点を当てます。これは最終的にコンピュータモデルを作らない場合でも有用だと考えています。私たちのアプローチの中心にあるのは、平易な英語で問題を記述する際の曖昧さを排除する数理モデルの作成です。コンピュータモデルの開発に関心のある読者にとって、記法はソフトウェアを書くための足がかりです。しかし私たちは、読者が一行もコードを書くつもりがない場合でも、問題を記述する際の明確さを生み出すために主として数学的記法を用いていきます。
本書の構成は次のとおりです。
- 第 1 章では、普遍的モデリング枠組みへの軽い導入を、2つの在庫問題(単純なものと、やや複雑なもの)を用いて示し、続いて不確実性のモデル化について簡潔に論じます。その後、決定を下すあらゆる方法を網羅する4つの方策クラスへの導入を行います。
- 第 2–6 章では、それぞれ特定の逐次決定問題を取り上げ、例を通して教えるスタイルでモデリング枠組みを示します。これらの応用は、4つの方策クラスのそれぞれを浮かび上がらせるように選ばれています。
- 第 7 章では、普遍的モデリング枠組みにより詳しく立ち返ります。第 2–6 章の例を文脈として用いながら、4つの方策クラスおよび状態変数のさまざまな種類について、はるかに丁寧な議論を行います。
- 第 8–14 章では、より複雑な設定を用いた追加の例を通じて、より高度なモデリング概念を示します。不確実性のモデル化(特にChapter 8での電力価格のモデル化)と、より豊かな方策の集合の両方を扱います。
応用の章(2–6 章と 8–14 章)はすべて同じ構成に従っています。どの順序で読んでも構いませんが、第 2–6 章の応用はより単純であり、4つの方策クラスのそれぞれを説明するために選ばれていることに留意してください。特定のモデリングの話題(状態変数、不確実性のモデル化、方策のさまざまな例など)に関心のある読者は、章を飛ばし読みして、興味のある話題へ直接進んでも構いません。
各章は、3つのカテゴリに分けられた一連の演習問題で締めくくられます。
- 復習問題 — 章を読んで得られる基本的な理解を定着させるために使える、簡単な質問です。
- 問題解決演習 — 問題解決能力を要するモデリング上の課題を導入します。
- プログラミング演習 — ほとんどの章には、一連の Python モジュールを利用したプログラミング演習があります。もとの Python モジュールは Python 2 で書かれていましたが、ドイツのカールスルーエ大学の Dennis Djanka 教授による大幅なアップグレードの恩恵を受けました。新しいライブラリは tinyurl.com/sdagithub からダウンロードできます。これらの演習のいくつかは、Python コードにプログラミング上の修正を加えることを要求します。
では、決定とは何か?
人々がどのように意思決定を行うかについての研究は、ソクラテス、アリストテレス、プラトンの時代にまで遡る2,000年以上の長い歴史があり、それが記録されています。さらに、最適な意思決定の数学に関する膨大な文献が、主に1950年代以降(ただしそれ以前の重要な研究もあります)に蓄積されており、何千本もの論文や書籍から成っています。この文献が見落としているように見えるのは、次の基本的な問いです。
決定とは何か?
私たちはまず、決定とは、制御しようとしている何らかの「システム」の振る舞いに影響を与える情報の一形態である、という観察から出発します。このシステムには、システムがどれだけうまく機能しているかを定量化する一つ以上の指標が暗黙的に含まれます。次に、システムの何らかの側面を制御するエージェントを特定しなければなりません。
この基礎の上に立つと、3つの情報のクラスを識別することが役立ちます。
- 知識の状態 — これは、システムの性能に関係する、今この時点で私たちが持っている情報です。
- 私たちが制御する、知識の状態を変化させる情報(これには、システムの制御エージェントを特定することが必要です)。
- 私たちの制御を超えたところで、知識の状態を変化させるシステムに到来する情報。
クラス2の情報を決定と呼びます。これは、Bridging Decision Problems, Volume I: Framing the Problem に基づく、決定の形式的な定義を示唆します。
定義(形式的): 決定とは、内生的に制御可能な情報クラスである。
非形式的な定義は次のようになるでしょう。
定義(非形式的): 決定とは、私たちが制御する情報である。
これらの定義は出発点を与えてくれますが、そこから学べることはあまり多くありません。それよりもはるかに興味深いのは、決定の具体例を挙げることであり、次にそれを行います。
決定の種類
私たちは、状況および最良の決定を求めるために用いうるツールに基づいて、10種類の決定を特定しました。それらは次のとおりです。
1) 物理的・金銭的な決定 — これらの決定は、人、設備、施設、製品、水、エネルギーといった物理的資源、および現金や投資といった金銭的資源の管理において生じます。決定には、資源の購入、売却、変更が含まれ、変更とは、ある場所から別の場所への移動、設備の修理、人の訓練、あるいはケーキを作るための材料の配合を意味することもあります。
2) 複雑/戦略的な決定 — これらは、システムに複数の変更(資源、パラメータ、信念の変更)を加える可能性のある決定であり、典型的には重要な不確実性の源を伴います。これらの決定は通常一度だけ評価されますが、待って後で決定するという選択肢が存在する場合もあります。
3) 情報獲得/観測の決定 — これには、実験室での実験、現地試験、コンピュータシミュレーションの実施といった決定が含まれます。市場調査の実施、専門家の雇用、あるいは大規模言語モデルへの質問も含まれるかもしれません。
4) 情報の伝達/共有の決定 — これらは2つの形で現れます。
- a) メッセージング — テキスト、動画、音声で何を語るかを反映します。
- b) チャネルとタイミング — 情報をどのように送るかの選択、すなわちテキスト/電子メール、出版(印刷またはオンライン)、ソーシャルメディア、広告チャネルなどを扱います。また、タイミングと頻度の選択も必要です。
5) 性能指標と目標 — これらは、収益の最大化、コストの最小化、疾病の最小化、獲得票数の最大化など、私たちが達成しようとしていることを定量化するという重要な選択を表します。
6) 関数の選択 — これは、決定を行う方法(方策)、最適化モデルの定式化、性能指標の選択、予測や推定の方法、あるいは(疾病がどのように広がるかといった)遷移関数の設計であり得ます。
7) パラメータの設定 — システムの性能に影響を与えるパラメータは多数存在することがよくあります。これらは価格、統計モデルの係数、製造プロセスで使われる温度などであり得ます。また、ある性能指標に置かれる重みや、性能目標であることもあります。
8) 推定または同定 — 人物を特定したり、需要を予測したり、病名を挙げたりする必要があるかもしれません。
9) 特徴と振る舞い — 製品をどう設計するか、ソフトウェアパッケージがどのような機能を持つべきか、顧客にどのようなサービスを提供すべきか、あるいは学生の専攻(卒業時にどのようなスキルを持つかを決定します)。
10) 何を決めるかを決める — 私たちは一般にこの最後の決定に形式的な分析を用いることはありませんが、自分が決定を行っていることを認識すること、そしてそれをデータ分析とモデリングによって形式的に扱いたいかどうかを認識することは重要です。
決定を特定することには、その決定がシステムの性能にどのように影響するかを理解することが暗黙的に含まれます。物理的資源を移動させること(タイプ1)にはコストが伴い、需要を満たすことは収益をもたらします。決定は(資源管理でしばしば起こるように)一つ以上の性能指標に即時の影響を与えることもありますが、多くの場合、決定は時間をかけて評価されなければならず、決定を行う時点では分かっていない情報に依存します。このため、私たちはしばしば決定そのものではなく、どのように決定を行っているか(すなわち方法)を評価しているのです。
問題のフレーミング
決定問題に取り組む際の第一歩は、次の3つの問いに答えることです。
- 性能指標は何か?
- どのような種類の決定が行われているか(そして誰がそれを行うのか)?
- 性能に影響を与える不確実性は何か?
これらの問いへの答えは、あらゆる決定問題にとって基本的なものであることに注意してください。本書では、これらの問いはかなり単純に見えるでしょう。なぜなら、私たちは問題を解くためにすでに設計したモデルの文脈の中でそれらに答えるからです。実際の応用では、性能指標、決定、不確実性のリストはかなり長くなり得ます。
問題のフレーミングがどれほど豊かなものになり得るかを示すヒントとして、まさにこのテーマに専念したモノグラフ Framing the Problem を読者に見ていただくことをお勧めします。このモノグラフは、これらの問いのそれぞれに丸ごと一章を割いており、十数種類の応用例を用いて説明されています。
フレーミングのプロセスの目標は、何が重要かを特定することであり、性能指標から始まります。単純な在庫問題でさえ、20を超える性能指標、30種類の異なる決定、30を超える種類の不確実性で記述できます。これらを列挙したスプレッドシートは tinyurl.com/PowellInventoryDecisions にあります。これは、実際にこのすべての複雑さを備えたモデルを構築するという意味ではありません。このため、本書では相互作用行列と呼ばれる仕組みを導入します。そこでは、ドメイン専門家が指標に優先順位を付け、次に判断を用いて、最も重要な指標に最大の影響を与える決定と不確実性を特定します。
本書では、問題をすでに少数の指標、決定、不確実性へと縮約したものと仮定し、それらを用いて数理モデルの構築に焦点を絞ります。
モデリングのプロセス
モデリングは技芸ですが、それはコンピュータに載せて解くことができる、明確に定義された問題を得ることを保証する数学的枠組みによって導かれる技芸です。これは、雑然として不明確に定義された実世界の問題から、コンピュータが理解できる明快さを持つものへと橋を架けることと見なせます。たとえ最終目標がコンピュータに載せることではないとしても、です。
歴史的に、モデリングの取り組みが意思決定を伴う場合、人々はよく知られた決定論的最適化の枠組みに頼りました。それはしばしば、式 $\eqref{eq:linearprogram1}$–$\eqref{eq:linearprogram3}$ で与えられるモデルのような形をしており、決定変数 $x$、目的関数 $cx$、および $\eqref{eq:linearprogram2}$–$\eqref{eq:linearprogram3}$ で与えられる制約から成ります。
この古典的なモデリング枠組みの問題は、それが省いているものにあります。
- モデルを特徴づけるすべてのデータ(変数 $A$、$b$、$c$ に含まれる)が完全に既知であると仮定しています。
- ほとんどの決定は時間の経過とともに繰り返し生じますが、それが認識されていません。
- システムへの情報の流れを表現する方法がありません。
- 副産物として、このモデルの最適解は、現場での $x$ の性能に影響を与える事象を予期できません。
- 多くの応用で主要な問題であるリスクを表現する方法がありません。
- 単一の意思決定者を仮定しています。
数理モデルは、何よりもまず、問題についてどう考えるかを教えてくれる道筋を提供すべきです。式 $\eqref{eq:linearprogram1}$–$\eqref{eq:linearprogram3}$ の形式に従う古典的な決定論的最適化モデルは、時間の経過に伴う問題の進展に関わるものを完全に無視しています。
本書は全体として、ユニバーサル・モデリング・フレームワークと呼ばれるモデリング手法を軸に構成されています。ひと言で言えば、それは制御可能なシステムのあらゆる側面を表現することを目指しています。既定のモデルでは、新しい情報が到来するにつれてシステムが時間とともに進展すると仮定します。
この節では、ユニバーサル・モデリング・フレームワークの非常にコンパクトな版を提示します。次に、最初は非常に単純な在庫問題を用い、その後いくつかの控えめな拡張を導入しながら、この枠組みを説明します。これらの例を提示した後、ユニバーサル・モデリング・フレームワークのより詳細な説明に戻ります。
動的モデルのコンパクトな提示
まず、任意の逐次決定問題を次の系列を用いてモデル化できることを観察することから始めます。
\[(S_0,x_0,W_1,S_1,x_1,W_2, \ldots, S_t, x_t, W_{t+1}, \ldots, S_T),\]ここで:
- $S_t$ は状態変数であり、次のために必要なすべてを捉えます:
- a) 時刻 $t$ における決定を行うこと。
- b) 時刻 $t$ における性能指標を計算すること。
- c) 将来の任意の時点で (a) または (b) を計算するために必要なその他の情報。
$S_t$ は、時刻 $t$ における情報の状態、より一般的には知識の状態と考えるのが最善です。
- $x_t$ は決定変数を表し、家を売るかどうか、ネットワーク内の経路、治療のための薬剤の選択、製品を売る価格、貨物を運ぶトラックの選択など、私たちが制御する要素を捉えます。
-
$W_{t+1}$ は、決定 $x_t$ を行った後に到来する情報であり、家の最終的な売却価格、ネットワークの移動時間、患者が薬にどう反応するか、ある価格での製品の売上、そして初期の割当てを行った後に持ち込まれる貨物などであり得ます。$W_{t+1}$ の情報は、私たちのシステムの外部から来るものと見なされ、それは私たちの制御の外にあることを意味します。このため、これを外生情報と呼びます。
$W_{t+1}$ を、現在の状態 $S_t$ および/または決定 $x_t$ に依存する関数 $W_{t+1}(S_t,x_t)$ と考えるのが最善である状況も多くあります。これについては後で詳しく論じます。既定の記法としては $W_{t+1}$ を用いますが、それが状態 $S_t$ や決定 $x_t$ の影響を受け得ることを理解した上で用います。
決定 $x_t$ は、我々が方策と呼ぶ何らかの方法によって決定され、これを $X^\pi(S_t)$ と表記する。記法 $\pi$ は関数の構造に関する情報を担っており、それを潜在的な関数の集合 $\Fcal$ の中の $f$ で表し、また関数の構造によって定義される調整可能なパラメータ $\theta\in\Theta^f$ を含む。例えば、在庫方策として、在庫が $\theta^{min}$ を下回るたびに $\theta^{order}$ 単位を発注する、というものが考えられ、この場合の調整可能なパラメータは $\theta = (\theta^{order}, \theta^{min})$ である。この関数の構造は、関数 $f$ の一例となる。
我々は、状態 $S_t$、決定 $x_t$、外生情報 $W_{t+1}$ を入力として受け取り、更新された状態 $S_{t+1}$ を与える遷移関数を持つと仮定する。遷移関数は、状態変数 $S_t$ の各要素を更新する一連の方程式であり、その要素は1つだけかもしれないし、数万個(あるいはそれ以上)かもしれない。
状態 $S_t$ にある情報の下で決定 $x_t=X^\pi(S_t)$ を行うと、我々は貢献(またはコスト)$C(S_t,x_t)$ を得る。我々の目標は、貢献 $C(S_t,x_t)$(ここで $x_t=X^\pi(S_t)$)に依存する何らかの目的を最大化する方策を見つけることである。より複雑な設定では、$C(S_t,x_t)$ は実際には性能指標の集合であり得るが、どの決定 $x_t$ を選ぶかを特定するためには、それらを何らかの形で統合する必要がある。
これは逐次決定問題の非常に簡潔な記述である。次に、モデリングの過程で従うべき一連のステップを説明する。
モデリング過程のステップ
(我々の目的においては)モデリング過程全体を7つのステップに分けることができる。これらのステップに先立って(以下では「Step 0」と表記)、読者の指針となるよう、応用例の技術的複雑さを簡潔にまとめる。
Step 0. 章の要約 – 各章の冒頭では、その章が扱う内容の要約と、場合によっては他章の内容との関連を述べる。要約では、不確実性のモデル化にどのようなアプローチが用いられるか、またどのような方策が用いられるかを示す。
Step 1. ナラティブ(叙述) – これは問題の平易な英語による記述である。ナラティブは数学モデルを作成するために必要なすべての情報を提供するものではない。むしろ、記法に迷い込むことなくモデル作成者に全体像を与えるべき第一段階である。
Step 2. 問題のフレーミング – これは次の3つの問いに答えることから成る:
- 性能指標は何か?
- どのような種類の決定がなされるのか(場合によっては、どのエージェントがそれを行うのか)?
- 性能に影響する不確実性の源は何か?
Step 3. 問題の中核要素の特定。特に、あらゆる逐次決定問題が持つ3つの次元に重点を置く。これらの要素は数学を用いずに記述される:
- 我々はどの指標に影響を与えようとしているのか? 個々の分野(サプライチェーン管理、医療、エネルギー、金融など)は、コスト、収益、利益、報酬、利得、損失、性能、リスクといった用語で記述されうる多数の指標によって特徴づけられる。
- どのような決定がなされるのか? コンピュータゲームのような多くの問題では、決定を特定するのは非常に容易である。しかし、公衆衛生上のプロセスへの対応、カーボンフットプリントの削減、サプライチェーンの管理といった複雑な問題に取り組む場合、すべての決定を特定するのは非常に困難になり得る。
- 不確実性の源にはどのようなものがあるか? 開始前に我々が不確かなものは何か? 時間とともに外生的に到着する情報(すなわち、我々が決定を行った後に到着する情報)は何か? 表 1.2 は、COVIDワクチンの配分モデルにおける様々な不確実性の源を示している(12種類の不確実性のクラスの解説については RLSO の 章 10 を参照)。
これら3つの問いに答える過程を、我々は問題のフレーミングと呼ぶ。
| 不確実性の種類 | 説明 |
|---|---|
| 1) 観測誤差 | 症状のある人の観測;症状のある人をCOVID罹患者として分類する際の誤り |
| 2) 外生的不確実性 | 新規症例数・死亡者数の報告;ICUの利用可能性;ワクチンの実際の生産量 |
| 3) 予後の不確実性 | 入院者数;ワクチンの将来的な効果;ワクチンに対する集団の反応 |
| 4) 推論上の不確実性 | 感染率の推定値;ワクチン有効性の推定値 |
| 5) 実験上の不確実性 | 臨床試験における薬剤の性能;接種を受ける人数 |
| 6) モデルの不確実性 | 疾病の伝播率;感染の地理的拡散 |
| 7) 遷移の不確実性 | ワクチン在庫への追加/在庫からの引き出し |
| 8) 制御の不確実性 | どの人口集団が接種を受けたか;ワクチンの配分 |
| 9) 実行の不確実性 | 接種の失敗 |
| 10) 伝達誤差 | 現場からの報告の誤り;接種時期の通知漏れ |
| 11) 目標の不確実性 | 誰が接種を受けるべきかに関する意見の不一致 |
| 12) 環境の不確実性 | ワクチンが承認されるか/いつ承認されるか;異なる州・国へのワクチン配分 |
表 1.2. COVIDパンデミックへのワクチン接種対応において生じる様々な種類の不確実性の例示。
Step 4. 数学モデル – ここでは Step 2 の最初の3要素を土台とするが、今度はあらゆる逐次決定問題に適用される5つの次元から成る数学モデルを作成しなければならない:
- 状態変数 $S_t$ – 状態変数は、時刻 $t$ に決定を行い、コストと制約を計算し、必要であれば時刻 $t+1$ までシミュレートするために、時刻 $t$ において知っておく必要のあるすべてを捉える。状態変数には、物理的資源に関する情報(制約を通じて問題に入ってくる在庫や車両の位置)、その他の情報(目的関数に入ってくるコストや価格など)、そして我々が完全には知り得ない量やパラメータについての信念(予測値や、患者が薬にどう反応するかの推定値など)が含まれうる。
-
決定変数 $x_t$ – これらは、我々がシステムをどのように設計あるいは制御するかを記述する。決定は $x_t \in \Xcal$ と書かれる制約を満たさなければならず、ここで $\Xcal$ は離散的な選択肢の集合であったり、線形方程式の集合であったりする。決定は、状態変数にある情報が与えられたときに $x_t$ を決定する関数(あるいは規則)である方策によって定まり、これを $X^\pi(S_t)$ で表す。方策は非常に単純(安く買って高く売る)なこともあれば、かなり複雑なこともある。
添字 $\pi$ は、決定を行うために用いられる関数の種類と、調整可能なパラメータに関する情報を担っている。$f\in\Fcal$ を関数の構造、$\Fcal$ を可能な関数の集合、$\theta\in\Theta^f$ を関数 $f$ に対する調整可能なパラメータとしよう。すると我々の方策は $\pi = (f,\theta)$ と表される。調整可能なパラメータへの依存性を示すために、方策を $X^\pi(S_t\vert \theta)$ と書くことも多い。
これについては本章の後半、および本書全体を通してかなり詳しく立ち返る。本書で挙げる各例は、特定の種類の方策を説明するのに役立つように選ばれている。
- 外生情報 $W_{t+1}$ – これは、我々が決定 $x_t$ を行った後(しかし $x_{t+1}$ を決める前)に到着する新しい情報であり、価格を設定した後にどれだけ売れたか、あるいは選んだ経路を走破するのにかかった時間などである。時刻 $t$ に決定を行うとき、$W_{t+1}$ にある情報は未知であるため、$x_t$ を選ぶ際にはそれを確率変数として扱う。
- 遷移関数 $S^M(S_t,x_t,W_{t+1})$ – これらは、状態変数が時間とともにどのように発展するかを記述する方程式である。多くの現実の問題では、遷移関数が問題のすべての動特性を捉えており、かなり複雑になり得る。場合によっては、我々はその方程式を知ってすらおらず、観測可能な状態変数だけに頼らざるを得ないこともある。状態変数 $S_t$ の発展は、遷移関数を用いて次のように書く。
ここで $S^M(\cdot)$ は状態(またはシステム)遷移モデルとして知られる(そのため上付き添字に $M$ がある)。遷移関数は、決定 $x_t$ と外生情報 $W_{t+1}$ が与えられたときに状態変数の各要素がどのように変化するかを記述する。複雑な問題では、遷移関数の実装に数千行のコードが必要になることもある。
-
目的関数 – これは、我々の性能を評価するために用いる性能指標を捉え、方策の探索の基礎を与える。$C(S_t,x_t)$ を、$S_t$ にある情報に依存しうる決定 $x_t$ の貢献(最大化の場合)またはコスト(最小化の場合)を表すものとする。設定によっては、単一期間の貢献関数を $C(S_t,x_t,W_{t+1})$、すなわち $W_{t+1}$ が観測された後、時間区間 $(t,t+1)$ の終わりで評価される貢献関数として書く方が自然な場合もある。例えば、$W_{t+1}$ に含まれる不確実な需要を満たすために、直ちに到着する $x_t$ の発注を行うかもしれない。
我々の目的は、次のような指標を最適化する最良の方策 $X^\pi(S_t)$ を見つけることである:
- ある期間にわたる貢献の期待合計を最大化する。
- 多数の実験や観測を通じて学習した最終設計の期待性能を最大化する。
- 最終設計に伴うリスクを最小化する。
目的関数の最も一般的な書き方は次の通りである。
ここで「$\E$」は期待値作用素と呼ばれ、ランダムなあらゆるものについて平均を取ることを意味する。これには初期状態 $S_0$ に含まれる不確実な情報や、外生情報過程 $W_1, \ldots, W_T$ が含まれうる。期待値作用素を書くのが標準的であるが、実際にそれを計算できることは決してない。後ほど、一連のシミュレーションを実行して平均を取ることによって、あるいは現場でプロセスを観測することによって、それを近似する方法を示す。
式 $\eqref{eq:baseobjectivefunction}$ における期待値作用素「$\E$」を解釈する際には注意が必要である。この作用素が文字通り意味するのは、「不確実なあらゆるものについて平均を取る」ということである。最も明白な不確実性の要素は外生情報過程 $W_1, W_2, \ldots, W_t, \ldots, W_T$ である。
(ナラティブに導かれた)現実の問題から数学モデルの要素への移行は、おそらく最も難しいステップである。というのも、それはしばしば非技術的な情報源から情報を引き出すことを伴うからである。
ここで注目すべきは、我々が方策 $X^\pi(S_t)$ によって表される「どのように決定を行うか」を指定することなく、モデル全体を提示した点である。我々はこれを「まずモデル化し、それから解く」と呼び、これは逐次決定問題を扱う膨大な文献からの大きな departure(決別)を表している。このやり方で逐次決定問題に取り組むことがどれほど重要かは、言葉で伝えるのが難しいほどである。
Step 5. 不確実性モデル – これは、異なる種類の不確実性をどのようにモデル化するかである。モデルに不確実性を導入する方法は2つある:
- 初期状態 $S_0$ を通して。これは、患者が薬にどう反応するか、あるいは市場が価格にどう反応するかといった不確実なパラメータに対する確率分布を指定しうる。
- 外生情報過程 $W_1, \ldots, W_T$ を通して。
外生情報過程をモデル化する方法は3つある:
- $W_1, W_2, \ldots, W_T$ の数学モデルを作成する。
- 過去の価格、売上、気象事象など、履歴からの観測値を用いる。
- システムを現場で稼働させ、$W_t$ が起こるのをそのまま観測する。
Step 6. 方策の設計 – 方策は関数であるから、我々は最良の関数を探索しなければならない。(そう、方策は最良の決定を選ぶための関数であるが、方策を選ぶこと自体もまた決定である!)これを行うために、方策設計のための2つの中核的戦略を特定する:
- ある関数族の中を探索し、時間を通じて平均的に最も良く機能するものを見つける。
- 決定 $x_t$ の即時のコストまたは貢献に、将来のコストまたは貢献の近似を加えたものを推定し、現在と将来のコストまたは貢献の合計を最適化する選択 $x_t$ を見つけることで方策を作る。Google Maps は、ネットワークの次のリンクを通過するのに要する時間と、目的地に到達するまでの残り時間の合計を最適化することで、左折すべきか右折すべきかを決める。在庫の決定は、発注コストと、一定量の在庫を保持して先に進むことの推定価値との和を最適化することになるだろう。
これらの方策をどのように特定するかについては、これからずっと明示的に述べていく。後の節では、意思決定のあらゆる方法を包含する4つの方策クラスを説明する(これらはメタクラスである)。
ステップ 7. 方策の評価 – 最良の方策を見つけるとは、どれが最良かを判定するために方策を評価することを意味する。方策を評価するには2つの方法がある:
- コンピュータシミュレータで方策をテストする。これには、状態変数 $S_t$ を更新するために必要な状態遷移モデル $S^M(S_t,x_t,W_{t+1})$ のすべての式をプログラムすることが必要である。また、$W_{t+1}$ のサンプルを生成できることも必要であり、これはしばしばシミュレータの最も微妙な側面である。
- 方策が現場でどのように機能するかを観察する。
シミュレータは複雑で構築が難しいことがあり、それでもなおモデル化の近似の影響を受ける。このため、実務で遭遇する実際的な問題の大多数は現場でのテストを伴う傾向があり、それは遅く(1日をシミュレートするのに1日かかる)、実験の結果と共に生きていくことが求められる。
数学モデルに慣れる唯一の方法は、身近な例を用いて説明されるのを見ることである。私たちは、日常生活で誰もが遭遇する普遍的な問題、すなわち在庫管理から始める。
いくつかの在庫問題
私たちは、古典的な在庫問題の2つの変種を用いてモデル化のフレームワークを説明する。この問題は、逐次決定問題を解くある種の手法を説明するための応用例として広く使われている。まず、モデル化フレームワークの中核的な要素を伝えつつ、本書の残りの部分で探究していく多くの複雑さを無視できる、単純な在庫の例から始める。
その後、いくつかのモデル化の原則を説明できるよう、少しだけ複雑な在庫問題へと移行する。本書全体を通じて、問題の基本的なバージョンから始め、次に実際の応用で生じ得る複雑さの種類を示唆する拡張を導入するという考え方も用いていく。
単純な在庫問題
店に行くたびに誰もが経験する、最も身近な逐次決定問題の一つが在庫問題である。上で導入したモデル化プロセスの6つのステップを説明するために、この問題の単純なバージョンを使う:
ステップ 1: ナラティブ – あるピザレストランは、食品卸業者からソーセージを何ポンド発注するかを決めなければならない。レストランは日 $t$ の終わりに決定を行い、発注を伝え、それが翌朝に届いて翌日の注文に応える。ソーセージが残った場合は翌日まで保持できる。ソーセージのコストと、翌日それが売られる価格は事前に分かっているが、需要は分かっていない。
ステップ 2: 問題の中核的要素は以下の通り:
- 指標 – ソーセージの売上から購入コストを差し引いた利益を最大化したい。
- 決定 – ある日の終わりにどれだけ発注するかを決めなければならず、それは翌日の初めに届く。
- 不確実性の源 – この単純なモデルにおける唯一の不確実性の源は、翌日のソーセージの需要である。
ステップ 3: 数学モデル – これは5つの要素から成る。
1) 状態変数 $S_t$ – 初期状態変数 $S_0$ と、$t > 0$ に対する動的状態変数 $S_t$ を区別する。初期状態変数 $S_0$ は、固定パラメータと、時間を通じて変化する変数の初期値から成り、次のようになる
\[S_0 = (R^{inv}_0, (p, c), (\Dbar, \sigmabar^D)).\]初期状態を3種類の変数に分けた:
- 資源状態 $R^{inv}_0$ の初期値。
- 定数パラメータ $c$ と $p$ の値。
- 需要についての私たちの信念。平均 $\Dbar$、標準偏差 $\sigmabar^D$ の正規分布で与えられる。
動的状態変数 $S_t$ は在庫であり、これを $R^{inv}_t$ と呼ぶことにする。今のところ、これが動的状態変数の唯一の要素であり、したがって
\[S_t = R^{inv}_t.\]後に、状態変数へ追加の要素を導入する。
2) 決定変数 $x_t$ は、時刻 $t$ にどれだけ発注するかであり、(今のところ)それは直ちに届くと仮定する。決定は方策 $X^\pi(S_t)$ によって行い、これは後で設計する。
3) 外生情報 は製品に対するランダムな需要であり、これを $\Dhat_{t+1}$ と表すので、$W_{t+1} = \Dhat_{t+1}$ となる。
4) 遷移関数 は在庫 $R_t$ が時間を通じてどのように変化するかを捉え、次で与えられる
\[\begin{align} R^{inv}_{t+1} = \max\{0, R^{inv}_t+x_t-\Dhat_{t+1}\}. \label{eq:inventoryexampleequation} \end{align}\]5) 目的関数。 在庫問題では、製品の購入コスト $x_t$ と需要 $\Dhat_{t+1}$ を満たすことによる収益を含めて貢献を計算するのが最も自然であり、これは単期間の貢献関数が次のように書かれることを意味する
\[C(S_t,x_t,\Dhat_{t+1}) = -cx_t + p \min\{R^{inv}_t+x_t, \Dhat_{t+1}\},\]ここで $x_t = X^\pi(S_t)$ である。需要の列 $\Dhat_1, \ldots, \Dhat_T$ が与えられたとき、方策 $\Fhat^\pi$ の価値は
\[\Fhat^\pi(S_0) = \sum_{t=0}^T C(S_t,X^\pi(S_t),\Dhat_{t+1}).\]利益 $\Fhat^\pi(S_0)$ は、特定のランダムな需要の列 $\Dhat_1, \ldots, \Dhat_T$ に依存するためランダムである。最後に、期待値を取ることでこれらのランダムな需要について平均する:
\[\begin{align} F^\pi(S_0) = \E \left\{\sum_{t=0}^T C(S_t,X^\pi(S_t),\Dhat_{t+1})\vert S_0\right\}. \label{eq:inventoryobjective} \end{align}\]ここで、初期状態 $S_0$ による条件付けは、「最初に分かっていることを所与として期待値を取る」と読むことができる。$S_0$ による条件付けは期待値を取る際には常に暗黙的に含まれており、その結果、多くの著者はこれを省略する。しかし私たちは $S_0$ による条件付けを含めることにする。それは、初期入力(信念を含む)が変わると、方策の性能に影響を与え得ることを明確にするためである。
ステップ 4. 不確実性モデル – 不確実性をモデル化する最も単純なアプローチは、単に過去のデータを使うことである。遭遇し得る問題は、ソーセージが品切れになった場合、その日のソーセージの需要の全体を観測できないかもしれないという点である。この失われた需要を捉えることができるなら、これは妥当なアプローチである。
代替案は数学モデルを構築することである。需要が平均 $\Dbar$、標準偏差 $\sigmabar^D$ の正規分布に従うと仮定してもよい。これら両方が既知であると仮定すれば、需要を次のように書くことができ
\[\Dhat_{t+1} \sim N(\Dbar,(\sigmabar^D)^2),\]正規分布からサンプリングできるパッケージ(例えば Excel ではこれは Norm.inv と呼ばれる$(Rand(),\Dbar,\sigmabar)$を利用して、平均 $\Dbar$、標準偏差 $\sigmabar$ のランダムな観測を生成できる。
このモデルを用いると、需要の集合 $(\Dhat_1, \Dhat_2, \ldots, \Dhat_T)$ を作ることができる。次に、これを $N$ 回繰り返して $T$ 個の需要から成る $N$ 本の列を作り、方策の価値を推定するために必要な $n=1, \ldots, N$ に対する列 $(\Dhat^n_1, \Dhat^n_2, \ldots, \Dhat^n_T)$ を得る(これは以下のステップ 6 で使う)。
ステップ 5. 方策の設計 – 次に、発注量を決める方法を設計しなければならない。在庫問題で一般に使われる戦略は「order-up-to(補充点)」方策として知られており、次のような形をしている
\[\begin{align} X^\pi(S_t\vert \theta) = \begin{cases} \theta^{max} - R_t & \text{if } R_t < \theta^{min}, \\ 0 & \text{otherwise,}\end{cases} \label{eq:introorderupto} \end{align}\]ここで $\theta = (\theta^{min},\theta^{max})$ は調整が必要なパラメータの集合である。在庫を上限 $\theta^{max}$ まで「引き上げる(up to)」ように発注するので、「order-up-to」と呼ばれる。
ステップ 6. 方策の評価 – 使い得る戦略は多様である。実務上、式 $\eqref{eq:inventoryobjective}$ の目的関数における期待値を計算することはできないので、需要のサンプルを一連取る。$t=1, \ldots, T$ にわたる需要の1つのサンプルを $\Dhat^n_1, \ldots, \Dhat^n_T$ とし、これを $N$ 個生成できると仮定する。ここで、$n=1, \ldots, N$ に対するサンプルについて平均を取ることで、方策 $X^\pi(S_t)$ からの期待利益を推定でき、それは次で計算される
\[\Fbar^\pi(\theta\vert S_0) = \frac{1}{N} \sum_{n=1}^N \sum_{t=0}^T C(S_t,X^\pi(S_t\vert \theta),\Dhat^n_{t+1}).\]平たく言えば、シミュレートされた(あるいは履歴から観測された)需要のサンプル $\Dhat^n_1, \ldots, \Dhat^n_T$ を用いて方策 $X^\pi(S_t\vert \theta)$ を $N$ 回シミュレートし、その性能を平均して $\Fbar^\pi(\theta\vert S_0)$ を得ているのである。次に、$\theta$ の最良の値を見つけるという問題に直面する。単純な戦略は、$K$ 個の候補値 $\theta_1, \ldots, \theta_K$ を生成し、それぞれをシミュレートして各 $k$ について $\Fbar^\pi(\theta_k\vert S_0)$ を求め、最も良く機能する $\theta_k$ の値を選ぶことである。これは最適な戦略ではないが、単純で実用的な出発点となる。
少しだけ複雑な問題
上記の単純な在庫問題は、動的計画法として知られる逐次決定問題を解く特定の手法を示すための古典的な設定であり、これは a) 離散であり、かつ b) 取り得る値が多すぎない単純な状態変数を持つことに依存している。少しだけ複雑な在庫問題では、3つの異なる種類の状態変数を説明する。これらは、逐次決定問題を解くある人気の手法にとっては重大な複雑さをもたらすが、私たちが選んだ方策には何の影響も与えない。
ステップ 1: ナラティブ – 再びソーセージを発注しなければならないピザレストランを考えるが、ソーセージに支払う価格が日々変動することを許し、ある日の価格は前日の価格と独立であると仮定する。さらに、翌日のソーセージの需要はランダムであるが、完全ではないものの予測がないよりは良い、翌日の需要の予測が与えられると仮定する。それ以外については、この複雑な問題のすべては以前と同じである。
ステップ 2: 中核的要素 – 以下の通り:
- 指標 – ソーセージの売上から購入コストを差し引いた利益を最大化したい。ここでコストは日々変動する。
- 決定 – より単純な在庫問題と同様に、ある日の終わりにどれだけ発注するかを決めなければならず、それは翌日の初めに届く。
- 不確実性の源 – いまや3つの不確実性の源がある:実際の需要と予測の差、予測の日々の変化、そしてソーセージに支払う価格である。
ステップ 3: 数学モデル – 依然として同じ5つの要素を持つが、いまや問題は少し豊かになっている:
1) 状態変数を構成するには、モデルの3つの異なる部分で必要となる情報(具体的には、時間を通じて変化する情報)を列挙する必要がある:(1) 目的関数、(2) 意思決定のための方策(制約条件を含む)、(3) 遷移関数。もちろん、これらの関数はまだどれも導入していないので、先を読み進めて、状態変数がこれらの各関数を計算するために必要なすべての情報を含んでいることを確認する必要がある。これを、必要となる情報の辞書と考えてほしい。
まず、定数パラメータと、時間を通じて変化する量やパラメータの初期値から成る初期状態 $S_0$ から始める。これらは:
- 初期在庫 – 初期在庫 $R_0$ から始める。
- 初期購入コスト – $c_0$。
- 価格 – ソーセージを固定価格 $p$ で販売すると仮定する。
- 初期予測 – 最初の予測 $f^D_{0,1}$ が与えられていると仮定する。ここで $f^D_{0,1}$ は、時刻 1 の需要について時刻 0 で分かっている予測である。
- 需要の標準偏差の初期推定値 – $\sigmabar^D_0$。
- 予測の標準偏差の初期推定値 – $\sigmabar^f_0$。
これは、初期状態変数が次のようになることを意味する
\[S_0 = (R_0,c_0, p, f^D_{0,1}, \sigmabar^D_0, \sigmabar^f_0).\]次に、動的状態変数 $S_t$ を構成する、時間を通じて変化する情報がある:
- 現在の在庫 $R^{inv}_t$ – 時間区間 $(t,t+1)$ の初めにおける在庫。
- 購入コスト $c_t$ – これは時刻 $t$ に購入されるソーセージのコストであり、時刻 $t$ に与えられる。
- 需要予測 $f^D_{t,t+1}$ – これは時刻 $t$ に分かっていることを所与とした $\Dhat_{t+1}$ の予測である。
- 需要の標準偏差の現在の推定値 – $\sigmabar^D_t$。
- 予測の標準偏差の現在の推定値 – $\sigmabar^f_t$。
動的な状態変数は次のように与えられます。
\[S_t = (R^{inv}_t, c_t, f^D_{t,t+1}, \sigmabar^D_t, \sigmabar^f_t).\]2) 決定変数 $x_t$ は時刻 $t$ にどれだけ発注するかであり、(今のところ)すぐに届くと仮定します。決定は方策 $X^\pi(S_t)$ によって行い、その設計は後ほど行います。
3) 外生情報は次のもので構成されます。
- 購入コスト $\chat_{t+1}$ – これは $t+1$ 日目のソーセージの購入コストであり、外生的に指定されます。
- 予測 – 各時間期間ごとに新しい予測が与えられます。$\varepsilon^f_{t+1}$ を時刻 $t$ と $t+1$ の間の予測の変化とします。
- 需要 – 最後に、実際の需要は予測からのランダムな偏差であると仮定し、次のように書けます。
外生情報変数の完全な集合は次のように書けます。
\[W_{t+1} = \big(\chat_{t+1}, \varepsilon^f_{t+1}, \varepsilon^D_{t+1}\big).\]4) 遷移関数 – これは(動的な)状態変数 $S_t$ のそれぞれが時間とともにどのように変化するかを指定します。在庫は次のように更新します。
\[\begin{align} R^{inv}_{t+1} &= \max\{0, R^{inv}_t + x_t - \Dhat_{t+1}\}. \label{eq:introcomplexinventorytransition1} \end{align}\]需要は予測された需要に予測からの偏差 $\varepsilon^D_{t+1}$ を加えたものであり、次の式が得られます。
\[\begin{align} \Dhat_{t+1} &= f^D_{t,t+1} + \varepsilon^D_{t+1}. \label{eq:introcomplexinventorytransition2} \end{align}\]予測は次のように更新されると仮定します。
\[\begin{align} f^D_{t+1,t+2} &= f^D_{t,t+1} + \varepsilon^f_{t+1}. \label{eq:introcomplexinventorytransition3} \end{align}\]次に、需要と需要予測の分散を適応的に推定します。
\[\begin{align} (\sigmabar^D_{t+1})^2 &= (1-\alpha)(\sigmabar^D_t)^2 + \alpha (f^D_{t,t+1} - \Dhat_{t+1})^2, \label{eq:introcomplexinventorytransition4}\\ (\sigmabar^f_{t+1})^2 &= (1-\alpha)(\sigmabar^f_t)^2 + \alpha (f^D_{t,t+1} - f^D_{t+1,t+2})^2, \label{eq:introcomplexinventorytransition5} \end{align}\]ここで $0 < \alpha < 1$ は平滑化係数です。
最後に、コスト $c_{t+1}$ を「観測されたコスト」$\chat_{t+1}$ で更新します。これは単純に次のように書けます。
\[\begin{align} c_{t+1} = \chat_{t+1}.\label{eq:introcomplexinventorytransition6} \end{align}\]式 $\eqref{eq:introcomplexinventorytransition6}$ は、$\eqref{eq:introcomplexinventorytransition1}$ における在庫 $R^{inv}_t$ のように計算するのではなく、観測する状態変数の例です。式 $\eqref{eq:introcomplexinventorytransition1}$ は在庫がどのように更新されるかという物理法則を反映しているため、「モデルベース」と呼ばれることがあります。一方、式 $\eqref{eq:introcomplexinventorytransition6}$ は「モデルフリー」と呼ばれます。これは、コストの変化を生み出す背後のプロセスをモデル化しようとしていないためです。
遷移関数 $S_{t+1} = S^M(S_t,x_t,W_{t+1})$ は式 $\eqref{eq:introcomplexinventorytransition1}$–$\eqref{eq:introcomplexinventorytransition6}$ から構成されます。
5) 最後に、単一期間の貢献関数は次のように書けます。
\[C(S_t,x_t,\Dhat_{t+1}) = -c_tx_t + p \min\{R_t+x_t, \Dhat_{t+1}\},\]より単純な在庫問題との唯一の違いは、コスト $c$ が今や時間依存 $c_t$ であることです。貢献関数を $C(S_t,x_t)$ と書く慣例からは外れて、需要 $\Dhat_{t+1}$ からの収益を含めることを許します。
ここで目的関数を正式に次のように述べます。
\[\begin{align} \max_{\pi=(f,\theta)} \E \left\{\sum_{t=0}^T C(S_t,X^\pi(S_t\vert \theta),\Dhat_{t+1})\vert S_0\right\}. \label{eq:introcomplexinventoryobjective} \end{align}\]最適化 $\max_\pi$ は、$(f,\theta)$ で表されるすべての可能な方策の中を探索することを意味し、文字通り、決定を行うために使い得るあらゆる異なる関数の中を探索することを意味します。本書の例は、関数の中をどのように探索するかを示していきます。
上で述べたように、添字 $\pi$ は関数のタイプ $f\in\Fcal$ に関する情報と、任意の調整可能なパラメータ $\theta\in\Theta^f$ を担っていることを思い出してください。実際には、関数のタイプ $f\in\Fcal$ の探索はアドホックになる傾向があり(知識のあるアナリストが問題に適した関数を選ぶ)、一方で $\theta\in\Theta^f$ の最良の値の探索はコンピュータのアルゴリズムが実行します。
ステップ 4. 不確実性モデル – 外生的な変化 $\varepsilon^D_{t+1}$ と $\varepsilon^f_{t+1}$ は、平均 0、分散 $(\sigmabar^D_t)^2$ および $(\sigmabar^f_t)^2$ の正規分布で記述されると仮定します。これを次のように表します。
\[\varepsilon^D_t \sim N(0, (\sigmabar^D_t)^2), \quad \varepsilon^f_t \sim N(0, (\sigmabar^f_t)^2).\]不確実性モデルはかなり複雑になり得ますが、これは一例として役立ちます。
ステップ 5. 方策の設計 – 次に、発注量を決定する方法を設計しなければなりません。より単純なモデルの発注点方策の代わりに、明日の期待需要を満たすのに十分な量を、調整を加えて発注するというアイデアを提案します。これは次のように書けます。
\[\begin{align} X^\pi(S_t\vert \theta) = \max\{0,f^D_{t,t+1}-R_t\} + \theta. \label{eq:adjustedforecastpolicy} \end{align}\]完全な予測があれば、発注すべき量は $f^D_{t,t+1}$($\Dhat_{t+1}$ の予測)から手持ち在庫を引いたものだけで済みます。しかし、不確実性があるため、品切れを避けるバッファを持てるように調整項 $\theta$ を加えます。
ステップ 6. 方策の評価 – 今回は、系列 $W_1, W_2, \ldots, W_T$ 内のすべての確率変数のサンプルを生成しなければなりません。ここでも系列全体の $N$ 個のサンプルを生成して、次を用いて方策の性能を推定できます。
\[\Fbar^\pi(\theta) = \frac{1}{N} \sum_{n=1}^N \sum_{t=0}^T C(S_t,X^\pi(S_t\vert \theta),\Dhat^n_{t+1}).\]再び $\theta$ の最良の値を見つけるという問題に直面しますが、この課題には後ほど戻ります。
汎用モデリングフレームワーク
これで、汎用モデリングフレームワーク(UMF)の要素をより詳細に説明する準備が整いました。UMF はあらゆる逐次決定問題をモデル化できることに注意してください。このかなり広範な主張は、要素が展開されるにつれて明らかになるでしょう。というのも、我々は逐次決定問題の一般的な記述に記法を適用しているだけだからです。
UMF の 5 つの要素
UMF は次の要素から構成されます。
- 状態変数 $S_t$。
- 決定変数 $x_t$。
- 外生情報過程 $W_t$。
- 状態遷移モデル $S^M(S_t,x_t,W_{t+1})$。
- 目的関数。
これらをより詳細に説明すると次のようになります。
状態変数 – 時刻 $t$ におけるシステムの状態 $S_t$ は、時刻 $t$ 以降のシステムをモデル化するために必要十分なすべての情報を持ちます。より具体的には、この情報は次のものから構成されます。
- a) 時刻 $t$ に決定を行うために必要な情報。
- b) 時刻 $t$ に性能指標を計算するために必要な情報。
- c) 将来において (a) と (b) を計算するために今必要な情報。
$S_t$ には 3 種類の情報があります。
- 物理状態 $R_t$ は、在庫、人員、利用可能な機械、施設、水、薬品、エネルギー、そして(さまざまな形態の)お金といった物理的な量を捉えます。$R_t$ には製品やサービスに対する顧客の要求も含まれます。多くの応用において $R_t$ は管理されている資源を記述し、「状態」を「物理状態」と同一視することはかなり一般的な誤りです。
- 情報状態 $I_t$ は、(選択がある場合に)使用されている関数と任意の調整可能なパラメータを含みます。$I_t$ は、需要をどのように予測しているか、予測を当てはめるために使うパラメータ、さらにシステムの発展を制御するその他のパラメータを指定するかもしれません。
- 信念状態 $B_t$ は、完全にはわかっていない量やパラメータについての推定値や信念を含みます。したがって $B_t$ は(上記の需要予測のように)正規分布の推定平均と分散を捉えることができます。あるいは、時間とともに変化する確率のベクトルであることもあります。
物理状態 $R_t$ は現金口座の金額であるかもしれず、一方 $I_t$ は株式市場や債券市場の現在の状態であるかもしれません。動的なネットワーク上を移動している場合、$R_t$ はネットワーク上での我々の位置であり、$I_t$ は各リンクの移動時間について我々が知っていることであり得ます。経路を計画し、その後で計画からの逸脱にペナルティを課したい場合、その計画は $I_t$ を通じて状態変数に含まれます。
状態変数は通常、自明ではありません。すぐに書き出せるものというより、モデリングの過程で浮かび上がってくるものです。最初に書くからといって、状態変数のすべての要素をいつもすぐに列挙できるとは限りません。しかし最終的には、これは時刻 $t$ 以降のシステムをモデル化するために必要なすべての情報を格納する場所です。
決定変数 – コミュニティによって決定の記法は異なり、(典型的には離散的な)行動に $a_t$、工学における(典型的には連続的な)制御に $u_t$ を用います。我々は数理計画コミュニティで広く使われている $x_t$ をデフォルトとして使います。
決定変数にはさまざまな種類があります。
- 二値(例えば、資産を売却するかどうかのモデル化や、異なるウェブデザインの A/B テスト)。
- 離散(例えば、薬の選択、どの製品を広告するか)。
- 連続スカラー(価格、温度、濃度)。
- ベクトル(病院間の血液供給の配分のような、離散または連続)。
- カテゴリカル(例えば、製品広告でどの特徴を強調するか)。
決定変数の性質によって決まるアルゴリズムのクラスが存在することに注意してください。
決定は方策によって行われると仮定し、決定として $x_t$ を用いる場合には方策を $X^\pi(S_t)$ と表記します。決定 $x_t = X^\pi(S_t)$ は時刻 $t$ において実行可能であると仮定します。これは、$S_t$ に依存し得る何らかの集合(または領域)$\Xcal_t$ に対して $x_t \in \Xcal_t$ であることを意味します。
「$\pi$」は関数のタイプ $f\in\Fcal$(例えば、特定の説明変数を持つ線形モデル)に関する情報と、任意の調整可能なパラメータ $\theta \in \Theta^f$ を担うものとします。
外生情報 – $W_{t+1}$ を、時刻 $t+1$ に(すなわち $t$ と $t+1$ の間に)初めて既知となる任意の新しい情報とします。ここで情報源は我々のシステムの外部にあります(だからこそ「外生的」なのです)。特定の変数をモデル化するときには、外生情報を示すために「ハット」を使います。したがって、$\Dhat_{t+1}$ は $t$ と $t+1$ の間に発生する需要であり得ますし、$\phat_{t+1}$ を $t$ と $t+1$ の間の価格変化とすることもできます。
外生情報過程は定常でも非定常でもよく、純粋に外生的でも、状態(そして場合によっては行動)に依存するものでもかまいません(大量の株を売却すると決めれば、価格を押し下げる可能性があります)。
$\omega$ をサンプルパス $W_1, \ldots, W_T$ を表すものとします。これは各 $W_t$ の結果の系列を表します。しばしば、離散サンプルの集合 $\Omega$ を作成します。ここで各サンプルは $W_t$ 過程の結果の特定の系列を表し、$W_1(\omega), \ldots, W_T(\omega)$ と書けます。20 本のサンプルパスがあるなら、$\omega$ は 1 から 20 までの数からなると考えることができ、これによりサンプルパスを引くことができます。
遷移関数 – 遷移関数を次のように表記します。
\[\begin{align} S_{t+1} = S^M(S_t,x_t,W_{t+1}), \label{eq:transition} \end{align}\]ここで $S^M(\cdot)$ は、状態遷移モデル、システムモデル、プラントモデル、プラント方程式、状態方程式、伝達関数などの名前でも知られています。
式 $\eqref{eq:transition}$ は遷移関数の古典的な形であり、状態 $S_t$ から状態 $S_{t+1}$ への式を与えます。式 $\eqref{eq:inventoryexampleequation}$ は単純な在庫の例における唯一の遷移方程式であり、一方、式 $\eqref{eq:introcomplexinventorytransition1}$–$\eqref{eq:introcomplexinventorytransition6}$ はより複雑な例における遷移関数を構成していました。
遷移関数は次のような種類の更新のいずれをも捉え得ます。
- 在庫の追加、人の移動、設備の変更といった物理的資源の変化。
- 価格や天候の変化といった情報の更新。
- 不確実な量やパラメータについての信念の更新。
遷移関数は既知の方程式の集合である場合もあれば、人間の行動や大気中の CO2 の変化を記述する場合のように未知である場合もあります。方程式が未知の場合、その問題はしばしば「モデルフリー」または「データ駆動」と呼ばれます。これは、物理モデルを使うのではなく、変数の変化を観測することしかできないことを意味します。式 $\eqref{eq:introcomplexinventorytransition6}$ は、$c_t$ からどのように変化したかがわからないままコスト $c_{t+1} = \chat_{t+1}$ を「観測」するもので、モデルフリーな遷移の例です。
遷移関数は線形、連続非線形、あるいはステップ関数であり得ます。状態 $S_t$ が信念状態 $B_t$ を含む場合、遷移関数は更新方程式を含まなければなりません(これは本書の後半で説明します)。
方策 $X^\pi(S_t)$、外生過程 $W_{t+1}$、および遷移関数が与えられれば、状態、決定、情報の系列を次のように書けます。
\[(S_0, x_0, W_1, S_1, x_1, W_2, \ldots, x_{T-1}, W_T, S_T).\]目的関数 – 目的関数の書き方はいくつかあります。最も一般的なものの 1 つで、我々がデフォルトとして用いるのは、ある期間 $t=0, \ldots, T$ にわたる総期待貢献を最大化するものです。
\[\begin{align} \max_{\pi=(f,\theta)} F^\pi(S_0) = \E \left\{\sum_{t=0}^T C_t(S_t,X^\pi_t(S_t\vert \theta))\vert S_0\right\}, \label{eq:objectivecumulativereward} \end{align}\]ここで
\[\begin{align} S_{t+1} = S^M(S_t,X^\pi_t(S_t),W_{t+1}). \label{eq:basetransition} \end{align}\]初期状態のモデル $S_0$ と外生過程のモデル $W_1, W_2, \ldots$ も併せ持つとき、モデルは完全に指定されます。すべての外生情報を次のように書きます。
\[\begin{align} (S_0, W_1, W_2, \ldots, W_T). \label{eq:basestochasticmodel} \end{align}\]式 $\eqref{eq:objectivecumulativereward}$、$\eqref{eq:basetransition}$、$\eqref{eq:basestochasticmodel}$ が逐次決定問題のモデルを構成します。
以降、簡潔さのために、関数のタイプ $f\in\Fcal$ と調整可能なパラメータ $\theta\in\Theta^f$ にわたる探索を表すために $\max_\pi$ を用います。
式 $\eqref{eq:objectivecumulativereward}$ は期待値 $\E$ を用いており、これは $W_1, \ldots, W_T$ のすべての可能な結果にわたって平均を取ることを意味します。これは計算上、事実上ほとんど不可能です。代わりに、$\omega$ を系列 $W_1, \ldots, W_T$ の 1 つの結果を表すものとし、$W_1(\omega), \ldots, W_T(\omega)$ と書くことにします。この系列の $N$ 個の可能な結果を生成できると仮定し、$\omega^n$ を $n^{th}$ 番目の系列を添字付けする方法を表すものとします。
もしサンプルパス $\omega$ をたどっているなら、$\eqref{eq:basetransition}$ の遷移関数を次のように書き直すことになる。
\[\begin{align} S_{t+1}(\omega) = S^M(S_t(\omega),X^\pi_t(S_t(\omega)),W_{t+1}(\omega)). \label{eq:basetransition2} \end{align}\]式 $\eqref{eq:basetransition2}$ のすべての変数に $\omega$ の添字を付けているのは、$W_t$ の値の単一のサンプルパスをたどっていることを示すためである。
これで、期待値に基づく目的関数を平均に置き換えることができ、次のように書ける。
\[\begin{align} \max_\pi \Fbar^\pi(S_0) = \frac{1}{N}\sum_{n=1}^N \sum_{t=0}^T C_t(S_t(\omega^n),X^\pi_t(S_t(\omega^n))). \label{eq:objectivecumulativerewardaverage} \end{align}\]しばしば、我々は単一のサンプルパス(場合によっては履歴データから得られたもの)だけを扱っている。この場合、この単一のサンプルパスを用いて方策の性能を近似していることになり、次のように書ける。
\[\begin{align} \max_\pi \Fhat^\pi(\omega\vert S_0) = \sum_{t=0}^T C_t(S_t(\omega),X^\pi_t(S_t(\omega))). \label{eq:objectivecumulativerewardsample} \end{align}\]$\eqref{eq:objectivecumulativereward}$ のように期待値を用いて目的関数を書くときはいつでも、実際に行うのは $\eqref{eq:objectivecumulativerewardaverage}$ のように平均を使うか、$\eqref{eq:objectivecumulativerewardsample}$ のようにサンプルを使うことだということを忘れないでほしい。
期待値は初期状態 $S_0$ における不確実性も反映する必要があるかもしれない。これは不確かな予測についての信念や、患者の疾病状態についての不確かな推定を捉えるものである。この場合、サンプルパス $\omega$ にはこれらの初期分布からのサンプルを含める必要がある。
時間ではなくカウンタ $n$ を使う方が意味をなす設定もある。この場合、$S^n$ を $n$ 回の観測後の状態とする(これらは実験、顧客の到着、アルゴリズムの反復などであり得る)。我々は既定の添字として時間 $t$ を使う。
初期状態変数 $S_0$
初期状態 $S_0$ と、$t > 0$ に対する後続の状態 $S_t$ を区別する必要がある。
- $S_0$ – 初期状態 $S_0$ は、i) 決して変化しない決定論的パラメータ、ii) 変化する(場合によっては決定の結果として変化する)量やパラメータの初期値、iii) 完全には分かっていない量やパラメータについての信念(これは確率分布のパラメータかもしれない)、例えばワクチンに対する我々の反応や市場が価格にどう反応するかなどを捉える。信念は静的なままかもしれないし、観測から学習するにつれて更新するかもしれない。
- $S_t$ – これは、時刻 $t$ 以降のシステムをモデル化するために、履歴から時刻 $t$ に必要となるすべての情報である。$t > 0$ に対する $S_t$ は時間とともに変化する変数のみを含む。つまり、時刻 $t$ においては $S_0$ に含まれる静的情報も使っているかもしれないということである。
$F^\pi(S_0)$、$\Fbar^\pi(S_0)$、$\Fhat^\pi(\omega\vert S_0)$ のいずれを使う場合でも、方策の性能が初期状態 $S_0$ に明示的に依存することを書き表す。これは自明であるべきだが、しばしば見落とされる。初期状態には次のような要素が含まれる。
- 物理的または財務的資源の量の初期値 $R_0$ – これは初期在庫、車両の初期位置、利用可能な機械、施設の初期集合などであり得る。また、輸送ネットワーク、(変化しない)倉庫の規模、車両群のトラック台数といった静的な値も含む。
- パラメータの初期値、および問題のモデル化に用いる任意の関数 $I_0$ – これは初期価格、患者における薬剤の投与量水準、さらには予測を行うための関数や集団における疾病の進展をモデル化する関数の選択などであり得る。
- 任意の量やパラメータの初期の信念または推定値 $B_0$ – これは需要予測、市場が価格にどう反応するかの推定、大統領候補の世論調査の状況、あるいは製造プロセスの性能についての信念などであり得る。
決して変化しない初期値と、決定の直接の結果として、あるいは外生情報によって時間とともに進展する初期値とを分けておくと役立つことに注意しておく。決して変化しない値は $S_0$ に格納されるが、$t > 0$ に対する $S_t$ には表現されない。この理由は、$S_t$ を可能な限りコンパクトに保ちたいという願いからである。
我々の方策 $X^\pi(S_t\vert \theta)$ が調整可能なパラメータを持つとしよう。例えば、在庫システムを管理していて、よく知られた「発注点補充(order-up-to)」方策(在庫の文献では $(s,S)$ 方策として知られる)を使っているかもしれない。それは次で与えられる。
\[X^\pi(S_t\vert \theta) = \begin{cases} \theta^{max} - R_t & R_t < \theta^{min},\\ 0 & \text{otherwise.}\end{cases}\]ここで $\theta = (\theta^{min},\theta^{max})$ である。簡単のため、発注するとその品はすぐに到着すると仮定しよう(実務では決して成り立たない標準的な教科書的仮定である)。これにより、物理状態 $R_t$(瞬時の発注を行う直前の在庫量)の進展を次のように書ける。
\[R_{t+1} = \max\{0,R_t + x_t - \Dhat_{t+1}\}\]ここで $x_t = X^\pi(S_t\vert \theta)$ であり、$\Dhat_{t+1}$ は区間 $(t,t+1)$ における製品への需要である(これが我々の外生情報 $W_{t+1}$ である)。最後に、$C(S_t,x_t,W_{t+1})$ を区間 $(t,t+1)$ における純利益とする(今は重要ではない)。
さて、システムのシミュレーションを実行できるような履歴的な需要過程 $W_1, W_2, \ldots, W_t, \ldots, W_T$ があると想像しよう。$\omega$ をこの需要(あるいは任意の外生情報)の履歴列を表すものとする。最良の発注パラメータ集合 $\theta$ を見つける問題は次のように書ける。
\[\begin{align} \max_\theta \Fhat^\pi(\omega,\theta\vert S_0) = \sum_{t=0}^T C_t(S_t(\omega),X^\pi_t(S_t(\omega))), \label{eq:optimizingtheta} \end{align}\]ここで状態変数は次に従って進展する。
\[S_{t+1}(\omega) = S^M(S_t(\omega), X^\pi_t(S_t(\omega)), W_{t+1}(\omega)).\]$\eqref{eq:optimizingtheta}$ を最適化して見つけた $\theta$ の値を $\theta^\ast $ としよう。この最適値を書く適切な方法は、$S_0$ に含まれる情報に依存する関数 $\theta^\ast (S_0)$ として書くことである(それはサンプルパス $\omega$ にも依存する)。これは、$S_0$ で表される問題への入力データを変更すれば、方策パラメータ $\theta$ の最良の値に影響が及ぶかもしれないという現実を伝えるのに役立つ。実際、方策の選択そのものを変えなければならないことすらあるかもしれない!
バリエーション
基本的な数学モデルには2つの重要なバリエーションがある。
-
時間 $t$ から反復 $n$ へ – 時間 $t$ よりもカウンタ $n$ を使う方が自然な問題設定がある。単に $t$ を $n$ に変えるだけではない。というのも、反復とともに変化する変数は、時間を通じた進展とは異なるものとして見ているからである。具体的には、$S^n$、$x^n$、$W^{n+1}$ のように、添字 $n$ を上付きに置く。
この理由の一つは、時間を通じた変数の集合 $x_1, x_2, \ldots, x_t, \ldots, x_T$ をベクトル $x=(x_1, x_2, \ldots, x_t, \ldots, x_T)$ として見ているからであり、これは決定論的問題をモデル化する際に有用である(ベクトル $x$ 全体を一度に最適化するかもしれない)。対照的に、$x^n$ は時間とともに進展する関数として見る。
より実務的には、$n$ を上付きに置くことで反復的なシミュレーションを書けるようになる。したがって、反復 $n$ における時間を通じた情報過程は次のように書ける。
最良の方策を反復的に探索しているなら、反復 $n$ における方策を $X^{\pi,n}(S_t)$ を使って書くかもしれない。すると次が得られる。
\[S^n_0, x^n_0, W^n_1, \ldots, S^n_t, x^n_t, W^N_{t+1}, \ldots, S^N_T,\]ここで $x^n_t = X^{\pi,n}(S^n_t\vert \theta)$ である。
-
最終報酬の最適化 – よくある設定は、最良の方策を探すときに起こるような確率的探索を行っている場合である。アルゴリズムを評価する各反復は、時間を通じたシミュレーションを必要とするかもしれないが、常にそうであるとは限らない。
さて、決定変数がパラメータ $\theta$ であり、方策 $X^\pi(S_t\vert \theta)$ とまったく同じように働くアルゴリズム $\Theta^\pi(S^{\theta,n})$ を持っていると仮定しよう。ただし $S^{\theta,n}$ は $n$ 回目の反復におけるアルゴリズムの「状態」を捉える。
探索アルゴリズムはすべて逐次決定問題であるが、時間を通じた多くの逐次決定問題とは異なり、$N$ 回の反復を実行したいのであり、気にするのは最後の解だけである。$\theta^{\pi,N}$ を、「アルゴリズム」(方策)$\pi$ に従って $N$ 回反復した後の $\theta^n$ の値とする。
値 $\theta^{\pi,N}$ は情報過程 $W^1, \ldots, W^t, \ldots, W^N$ の特定の列に依存するが、それを $\What$ と呼ぶことにする新しいサンプル集合を使って評価しなければならない。
アルゴリズムの性能は最終報酬の目的関数を用いて評価し、次のように書く。
簡単に言えば、$W^n$ の観測(これは時間 $t$ を通じたシミュレーション全体であり得る)を使って $N$ 回の反復をシミュレートすることで、$\Theta^\pi(S^{\theta,N})$ と表記した $\theta$ に対する学習方策を評価する。パラメータ $\theta$ の最終推定値(これを $\theta^{\pi,N}$ と呼ぶ)を得たら、$\theta = \theta^{\pi,N}$ を固定し、$m=1, \ldots, M$ に対して $\What^m$ と呼ぶ新しい確率的観測の集合を生成する別個のシミュレーションを用いて、この値の性能を評価する。
不確実性のモデル化
多くの複雑な問題(サプライチェーン、エネルギーシステム、公衆衛生などはその一部にすぎない)では、さまざまな形態の不確実性を特定しモデル化することは、豊かで複雑な作業となり得る。ここでは生じる論点を示唆するにとどめ、この側面についての徹底的な議論は試みない。
不確実性は2つの機構を通じてモデルに伝えられる。すなわち、完全には分かっていない量やパラメータを記述する確率分布のパラメータをモデル化する場所である初期状態 $S_0$ と、外生情報過程 $W_1, \ldots, W_T$ である。
初期状態における不確実性
初期状態変数は、決定論的パラメータや、動的に変動する量やパラメータの初期値を含み得る。初期状態にあるのがそれだけなら、いかなる形態の不確実性も捉えていないことになる。
いくつかの量やパラメータが分かっていないが、分かっていることを確率分布のパラメータを通じて表現できる問題は多い。例をいくつか挙げる。
- 新しい薬剤に対する患者の反応。
- 価格変更に対する市場の反応。
- 在庫にある販売可能なレタスの個数(不確かな数が萎れて販売できなくなっているかもしれない)。
- 以前に中国から発注した在庫の箱が到着する時刻。
- 投資信託への預入額が平均 $\lambda$ の周りでランダムに変動するが、$\lambda$ が何であるか分かっていない。
これらは、入力の一部に不確実性を含めてモデルを初期化する方法のいくつかである。
初期の確率的信念は、主観的判断から得られることもあり、あるいは以前の観測や実験から得られることもある。
外生情報過程
不確実性がモデルに入る второй の方法は外生情報過程を通じてである。変数 $W_t$ は時間期間 $t$ まで分からない情報を含む。これは、$W_{t+1}$ の結果を知る前に、時刻 $t$ において決定 $x_t$ を行わなければならないことを意味する。
以下は、決定 $x_t$ がなされた後に明らかになる $W_{t+1}$ の例のリストである。
- 経路を選び、その後その経路の移動時間を観測する。
- 薬剤を選び、その後患者の反応を観測する。
- 触媒を選び、その後それが生み出す材料の強度を観測する。
- オンライン市場で広告する製品を選び、その後売上を観測する。
- ウェブインターフェースのデザインを選び、その後それが生成するクリック数を観測する。
- ある投資に資金を配分し、その後その投資の価格変動を観測する。
いずれの場合も、決定を行った後に観測する情報が、その決定の性能に影響する(そしてどの決定が最良だったかに影響する)。
読者はおそらくもう、$W_{t+1}$ が通常は異なる種類の情報の集まりであることに気づいているだろう。例えば、血糖値が上昇している患者を治療していると想像してほしい。医師は、食事と運動、あるいは減量のための薬剤から、血糖値を特に標的とする薬剤まで、さまざまな戦略を試したいと考えている。医師が処理しなければならない情報源には次のようなものが含まれるかもしれない。
- 患者が食事療法に取り組む意思。
- 食事指示に対する患者の遵守度。
- 減量のための毎日の注射を受け入れる患者の意思。
- 実際の減量(いずれのプログラムによるものであれ)。
- 血糖値の実際の変化。
これらはそれぞれ別個の情報の流れである。これらをモデル化するには、集合 $\Ical_t$、すなわち時刻 $t$ における情報過程の集合を導入すればよい(戦略を変えて新しい情報の流れが開かれると、この集合は変わり得る)。これで、情報源 $i\in\Ical_t$ からの情報の実現値 $W_{t+1,i}$ を用いてさまざまな種類の情報を表現でき、$W_{t+1} = (W_{t+1,i})_{i\in\Ical_t}$ となる。
我々は引き続き $W_{t+1}$ を到着する新しい情報を表すものとして使うが、読者は、実際の応用では通常、それぞれ独自の振る舞いを持つ情報源の集合全体が含まれることを覚えておく必要がある。
状態/決定依存の過程
情報 $W_{t+1}$ が現在の状態 $S_t$ および/または決定 $x_t$ に依存する応用は多い。例をいくつか挙げる。
- 在庫が不足すると顧客が離れ、需要が減少することがある。
- 大量の株式を購入すると、その価格が上昇することがある。
- ワクチンを推奨するという決定が、疾病の進行に影響を与えることがある。
- 稼働中の発電機の数が電力系統の価格を変化させることがある。
このため、外生情報を関数 $W_{t+1}(S_t,x_t)$ として表現することが有用である。これは外生情報関数であり、区間 $(t,t+1)$ に到着する情報を与える。
例えば、将来の価格に影響を与えうる規模で株式を大量に売買している場合を想像しよう。そのダイナミクスは次のように書けるだろう。
\[\begin{align} p_{t+1} = \theta^p_0 p_t + \theta^p_1 p_{t-1} + \theta^p_2 p_{t-2} + W_{t+1}(S_t,x_t). \label{eq:statedependentprice} \end{align}\]この価格プロセスの状態は次のように書かれる。
\[S_t = (p_t, p_{t-1}, p_{t-2}).\]$W_{t+1}(S_t,x_t)$ で与えられる価格のランダムな変化は、価格の変化が現在の価格(価格が高ければ、将来の変化は負になりやすい)と、購入量($x_t > 0$)あるいは売却量($x_t < 0$)に依存しうるという我々の考えを反映している。
もちろん、我々は履歴データを用いて、将来価格に対する $S_t$ と $x_t$ の構造的な影響を、真に外生的なノイズから分離しようとするだろう。そこで、次のようなモデルを提案するかもしれない。
\[W_{t+1}(S_t,x_t) = \theta^x x_t + \varepsilon_{t+1},\]ここで、次のように仮定するかもしれない。
\[\varepsilon_{t+1} \sim N(0, \vert x_t\vert \sigma^2_t),\]このモデルは、$\varepsilon_{t+1}$ の平均が 0 であり、分散が $x_t$ の絶対値とともに増加すると仮定している。すると情報 $W_{t+1}(S_t,x_t)$ の平均は $\theta^x x_t$ となり、株式を購入している場合($x_t > 0$)には正、市場に売却している場合($x_t < 0$)には負となる。
本書では引き続き $W_{t+1}$ を既定の記法として用いるが、読者はそれが現在の状態および/またはその状態の下で行われた決定に依存しうることに注意してほしい。
不確実性のスタイル
情報の種類を特定することは、不確実性を理解するための第一歩である。次のステップは、不確実性の異なるスタイルを特徴づけることである。情報プロセスが振る舞う最も重要な様式のいくつかをまとめると次のようになる。
- 細粒度の変動 — これは秒(さらには秒の端数)、分、時間、あるいは日単位の時間スケールで生じうる。
- シフト — プロセスの細粒度の変動は通常、平均のまわりの変動を表すが、平均が周期的に新しい水準へ移行することもある。これは新技術、競合他社の調整、あるいは経済の変化を反映するかもしれない。
- バースト・断続的需要 — 疾病の広がりは、局所的なアウトブレイクの拡大によって感染の急増を生み出しうる。ある顧客が商品を手に取り、それを友人に勧め、その友人がさらに友人に伝えるということもある。
- スパイク — 到来する雪嵐は牛乳、卵、トイレットペーパーの需要の跳ね上がりを生み出しうる。発電機の故障は電力価格のスパイクを生み出しうる。
- 空間的事象 — 天候、疾病、規制の変更は、本質的に地域的なランダムな変化を生み出しうる。
- システミックな事象 — これは企業全体(国境を越えることもある)、国全体、あるいは世界規模での影響を及ぼしうる事象である。通信へのサイバー攻撃、世間の認識の変化、ネガティブな広告などによって生じうる。
- 稀な事象 — 稀な事象は、地震、疾病のアウトブレイク、テロ攻撃など、多くの原因から生じうる。これらは極めてまれにしか発生しないが、発生したときには組織に重大な影響を与えうる事象である傾向がある。
- コンティンジェンシー — このカテゴリは、起こりうるが履歴が存在しない事象を指す。例えば、系統運用者は原子力発電所の故障に備えた計画を立てる。ある国においてそれが一度も起きたことがなかったとしても、系統運用者はその事象が実際に起きた場合に備えたいと考えるかもしれない。
これらの振る舞いは、意思決定を行うための方策の選択に影響を与えうる。それが次に扱う話題である。
不確実性は、企業、組織、さらには政府までもが備えなければならない問題として広く認識されている。しばしば見落とされるのは、不確実性をモデル化する理由が、それが決定にどのように影響するかを理解することにあるという点である。不確実性は常に、将来到着する情報プロセスと結びついている。したがって我々は、いま行う決定が将来のこの情報によってどのように影響を受けるかを考えなければならない。
方策の設計
方策とは決定を行うための方法である……どのような方法であっても。
方策とは、状態変数に含まれる情報を用いて決定を行う関数である。これは明確に定義された問題のように聞こえる。結局のところ、機械学習コミュニティは、訓練データセットに適合する関数を見つけるという課題を中心に築かれている。しかし、方策の設計はそれよりはるかに豊かであり、この分野で研究する多様なコミュニティの存在がそれを示している。
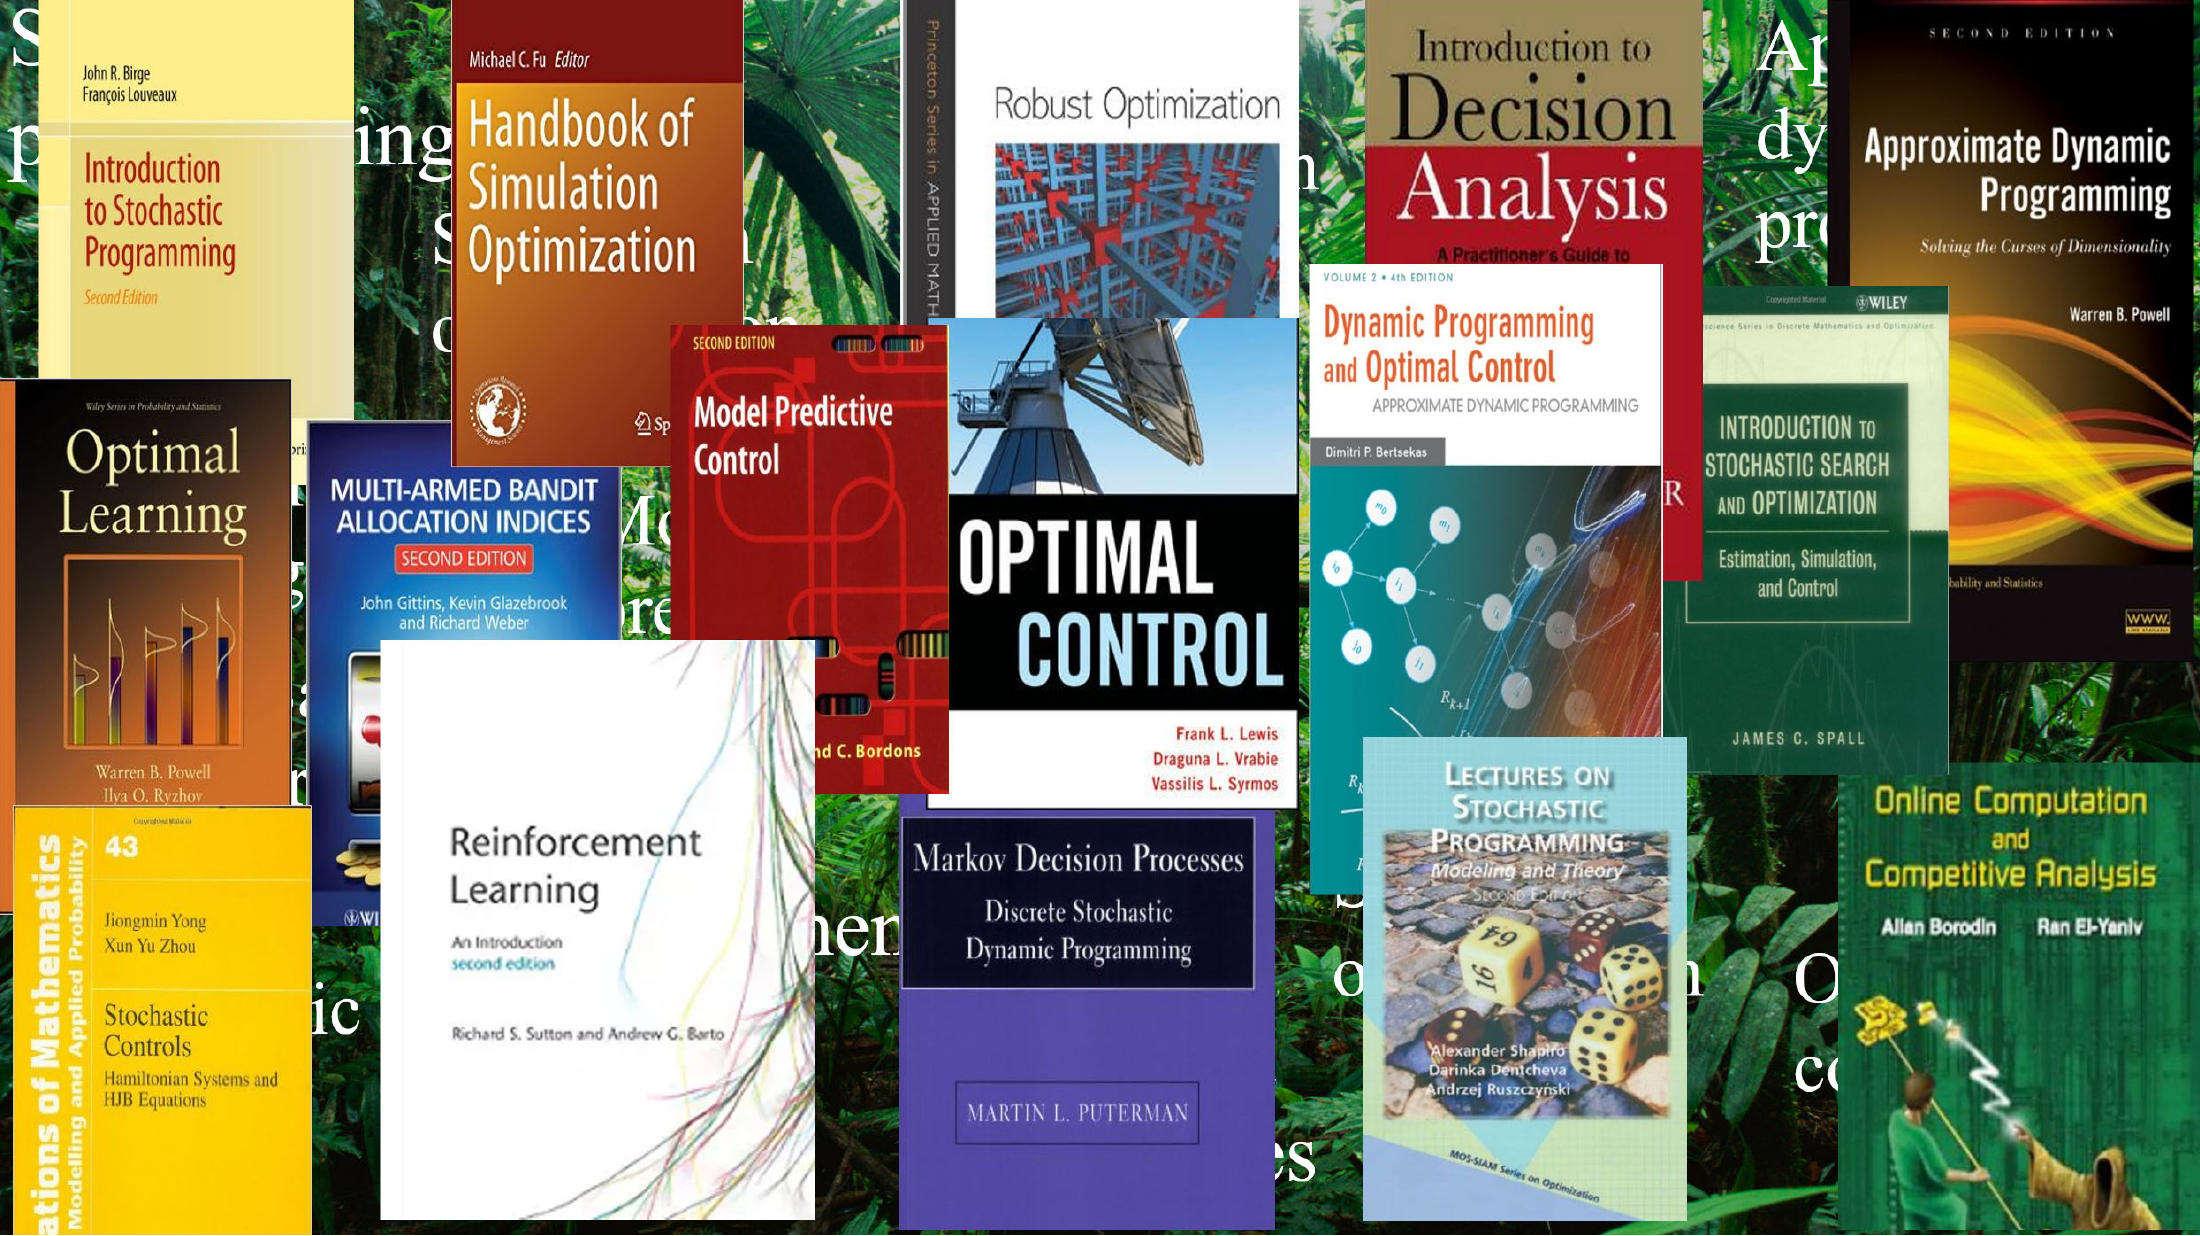
図 1.2 は、不確実性下の逐次決定を扱うおよそ 15 の異なる分野を代表する書籍の表紙を示している。それらは 8 種類の異なる記法体系を用い、モデリングへのアプローチも根本的に異なる。中には、方策(埋め込まれた最適化問題を含む)と目的関数を混同しているものもある。
方策の性能指標
決定論的最適化は、ある決定が別の決定より優れているかどうかを判定する目的関数によって特徴づけられる。逐次決定問題では、式 $\eqref{eq:objectivecumulativereward}$、$\eqref{eq:objectivecumulativerewardaverage}$、$\eqref{eq:objectivecumulativerewardsample}$ で行ったように、通常は方策の性能を評価する目的関数を持つことになる。
しかし実務では、方策は互いに競合する多数の基準に基づいて選択される。
- 解の品質 — 通常は、式 $\eqref{eq:objectivecumulativerewardsample}$ の目的関数のサンプル版で表されるように、ある期間にわたる性能(例:コスト、利益、健康アウトカム)を見る。これはランダムなので、平均的な性能と最悪ケースの性能を考慮しなければならない。
- 計算要件 — 運用環境では実行時間が重要である。目的関数と同様に、方策を計算するのに要する時間もランダムなので、平均実行時間と最悪ケースの実行時間を考慮する必要がある。
- 透明性 — 決定を、誤りを含みうる入力データまで遡って追跡することがどれだけ容易か。
- 柔軟性・適応性 — 実世界の問題は複雑になりうるし、複雑な状況に適応しなければならないことが多い。
- 方法論的な複雑さ — (例えば)社内の分析グループが方策を実装する場合、その手法を実際に機能させられる可能性を考慮しなければならない。
- データ要件 — 方策が異なれば、必要となるデータも異なる。
図 1.2 に示した数理最適化のコミュニティは、最適な方策について論じるかもしれない。それは式 $\eqref{eq:objectivecumulativereward}$ の期待値を最適化することを意味する。しかし、これらの特性すべてに注意を払うことが重要である。
方策の 4 つのクラス
図 1.2 の書籍は、時間を通じて決定を行うさまざまな方法を扱っている。実は、それらはすべて明確に定義された方策のクラスに分類できる。方策を作るための基本戦略は 2 つあり、それぞれがさらに 2 つのクラスに分けられ、合計 4 つの方策クラスが得られる。
方策探索 — これは、決定を行うための方法(関数)の空間を探索し、(式 $\eqref{eq:objectivecumulativereward}$ で行うように)その性能をシミュレートして、時間平均で最もうまく機能する方法を見つけるものである。これには、異なる手法クラスの探索と、与えられた手法の調整可能なパラメータの探索が含まれうる。この考え方から次の 2 つの方策クラスが生まれる。
- 1) 方策関数近似(PFAs) — これは状態の解析的な関数であり、行動を直接指定する。式 $\eqref{eq:introorderupto}$ の発注点方策(order-up-to 方策)はよい例であり、式 $\eqref{eq:adjustedforecastpolicy}$ で調整済み予測を用いた方策も同様である。
- 2) コスト関数近似(CFAs) — これは、元の問題を簡略化した最適化問題を解くことを含む方策であり、時間を通じて方策がよりうまく機能するようにパラメータが導入される。これは特に強力な考え方で、産業界で広く用いられている。本書の後半では CFA の例をいくつも示す(まずは第 4 章で、糖尿病に最適な薬剤を学習する問題から始める)。
先読み方策 — 決定の貢献(またはコスト)に加えて、いま行った決定から生じる下流の貢献(またはコスト)の近似を合わせて最適化することで、効果的な方策を構築できる。これも、さらに 2 つの方策クラスに分けられる。
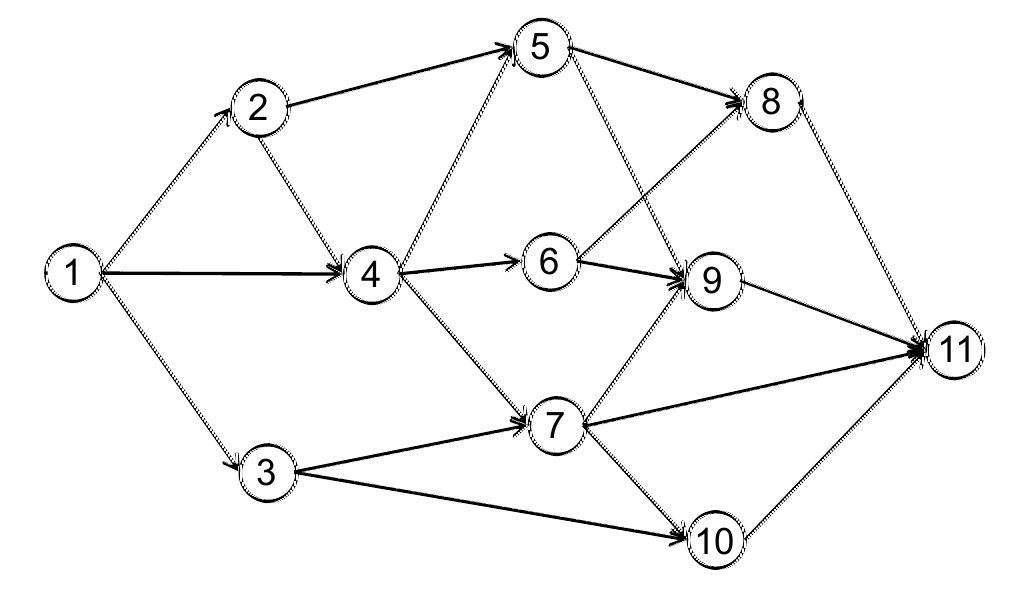
- 3) 価値関数近似(VFAs) — 図 1.3 に描かれたネットワークをたどっていて、ノード 1 からノード 11 への経路を見つけたいとしよう。いま、ノード $S_t = i = 2$ にいるとする。ここで $t$ はこれまでに通過したリンクの本数を数えている。$V_{t+1}(S_{t+1})$ を、ノード $S_{t+1}$(例えばノード 4 や 5)からノード 11 までの経路の価値(最大化を想定)とする($V_{t+1}(S_{t+1})$ をどのように得たかは気にしないでほしい)。決定 $x_t$ を、ノード $S_t = i$ から出て通過するリンクとする。ノード $S_t$ にいることの価値は次のように与えられる。
式 $\eqref{eq:bellmangraph}$ は ベルマン方程式 として知られている。図 1.3 に描いたような決定論的ネットワークで最良の経路を見つけるために用いるとき、それはかなり容易に視覚化できる。
状態 $S_t$ から $S_{t+1}$ への遷移が、時刻 $t$ では未知のランダムな情報を含むという問題は数多く存在する。最初の在庫問題ではランダム性の単純な例を見たし、2 番目の在庫問題ではより複雑な例を見た。
こうしたより一般的な問題では、状態 $S_t$ にいて決定 $x_t$ を行い、その後(時刻 $t$ では未知の)新しい情報 $W_{t+1}$ を観測すると、遷移関数に従って新しい状態 $S_{t+1}$ へ移ることになる。
\[S_{t+1} = S^M(S_t,x_t,W_{t+1}).\]これは、$x_t$ を選ばなければならない時刻 $t$ において $W_{t+1}$ が確率変数であり、したがって $S_{t+1}$ も確率変数であることを意味する。この場合、ベルマン方程式に期待値を挿入し、式 $\eqref{eq:bellmangraph}$ を次のように書かなければならない。
\[\begin{align} V_t(S_t) = \max_{x_t} \big(C(S_t,x_t) + \E_{W_{t+1}} \left\{V_{t+1}(S_{t+1})\vert S_t,x_t\right\}\big). \label{eq:bellmanstochastic} \end{align}\]ここでは期待値 $\E_{W_{t+1}}\lbrace \cdot\rbrace $ を挿入した。これは文字どおり $W_{t+1}$ のすべてのランダムな結果にわたって平均をとることを意味する。
$\eqref{eq:bellmanstochastic}$ のベルマン方程式の確率版は、極めて一般的である。状態 $S_t$ はグラフ上のノードを意味するだけではなく、その問題に関連するあらゆる情報(そのすべて)を捉える。困難なのは、もはや価値関数 $V_t(S_t)$ を計算できないことであり、その結果、式 $\eqref{eq:bellmangraph}$ と $\eqref{eq:bellmanstochastic}$ で既知だと仮定していた $V_{t+1}(S_{t+1})$ を利用できなくなる。
ベルマン方程式を適用しようとする際に研究コミュニティが用いてきた戦略は、機械学習の分野を活用して、$\Vbar_t(S_t)$ と呼ぶことにする統計的近似を推定することである。妥当な近似 $\Vbar_{t+1}(S_{t+1})$ を得られると仮定すれば、我々の方策(決定を行うための方法)は次のように書けるだろう。
\[\begin{align} X^\pi(S_t) = \argmax_{x_t\in\Xcal_t} \big(C(S_t,x_t) + \E_{W_{t+1}} \{\Vbar_{t+1}(S_{t+1})\vert S_t,x_t\}\big). \label{eq:introvbarpolicy} \end{align}\]記法「$\argmax_x f(x)$」は、関数 $f(x)$ を最大化する $x$ の値を意味する。添字 $\pi$ は、関数 $f$ の構造を指定する情報と、近似 $\Vbar_{t+1}(S_{t+1})$ において必要となる調整可能パラメータ $\theta$ を担っている。
この方策クラスは、近似動的計画法や、最も多くの場合は強化学習といった名称の下に属する。強力な考え方ではあるが、適用は容易ではなく、正確な近似 $\Vbar_{t+1}(S_{t+1})$ を作れるかどうかに依存する。
価値関数を近似する手法については非常に豊富な文献があるが、それは万能薬ではない。本書ではこの考え方をいくつかの箇所で示すが、読者はこのクラスの方策が使いこなすのがかなり難しいことに注意されたい。
-
4) 直接先読み近似 (DLAs) – 最初の3つのクラスのいずれを用いても効果的な方策を作れない問題は数多く存在し、そうした場合には直接先読み近似に頼らざるを得ない。完全な数学的形式は後ほど書き下すが、ここではDLAを、ある計画期間にわたる(通常は近似的な)モデル上で最適化を行いながら、今この時点の決定を下すものとして説明しておく。
よくあるDLAは、決定論的な近似モデルを作ることである。これは、ネットワークの各リンクの移動時間が分かっていると仮定して目的地までの最短経路を求めるナビゲーションシステムを使うときに、我々が行っていることである。一般則として、将来の厳密な確率モデルを解くことはほとんど常に不可能であるため、問題を近似するさまざまな戦略を検討していくことになる。
我々は2つの在庫問題を用いてモデリングの枠組みを示し、式 $\eqref{eq:introorderupto}$ と $\eqref{eq:adjustedforecastpolicy}$ による2つの単純な方策(PFAの一形態)を提示したが、これは方策の具体例を示すためだけに行ったものである。PFAは日々の意思決定で広く使われているが、これらは特殊な例である。
これに対して、今概説した4つの方策クラス(PFA、CFA、VFA、DLA)は普遍的であり、どんな逐次決定問題を解くために使いうるあらゆる手法を網羅している、と主張しよう。明確にしておくと、これらはメタクラスである。つまり、ある問題が特定のクラスに適していると考えたとしても、それで終わりではなく、そのクラスの中で具体的な方策を設計しなければならない。それでもなお、これら4つのクラスは方策設計のプロセスを導くロードマップを提供してくれると我々は考えている。
方策のテスト
方策の価値をテストするために、情報過程 $W_t$ の単一のサンプルパス上で方策をシミュレートする式 $\eqref{eq:objectivecumulativerewardsample}$ を用いる。方策をシミュレートする際に最も難しいのは、通常、外生情報過程を作り出すことである。
$\omega$ をサンプルパスとし、$W_1(\omega), \ldots, W_T(\omega)$ は特定のサンプルパスを表すものとする。表 1.3 は $\omega^1$ から $\omega^{10}$ まで添字付けされた価格の10本のサンプルパスを示している。$\omega^6$ を選べば、$W_7(\omega^6) = 44.16$ となる。
| $t=1$ | $t=2$ | $t=3$ | $t=4$ | $t=5$ | $t=6$ | $t=7$ | $t=8$ | |
|---|---|---|---|---|---|---|---|---|
| $\omega^n$ | $p_1$ | $p_2$ | $p_3$ | $p_4$ | $p_5$ | $p_6$ | $p_7$ | $p_8$ |
| $\omega^1$ | 45.00 | 45.53 | 47.07 | 47.56 | 47.80 | 48.43 | 46.93 | 46.57 |
| $\omega^2$ | 45.00 | 43.15 | 42.51 | 40.51 | 41.50 | 41.00 | 39.16 | 41.11 |
| $\omega^3$ | 45.00 | 45.16 | 45.37 | 44.30 | 45.35 | 47.23 | 47.35 | 46.30 |
| $\omega^4$ | 45.00 | 45.67 | 46.18 | 46.22 | 45.69 | 44.24 | 43.77 | 43.57 |
| $\omega^5$ | 45.00 | 46.32 | 46.14 | 46.53 | 44.84 | 45.17 | 44.92 | 46.09 |
| $\omega^6$ | 45.00 | 44.70 | 43.05 | 43.77 | 42.61 | 44.32 | 44.16 | 45.29 |
| $\omega^7$ | 45.00 | 43.67 | 43.14 | 44.78 | 43.12 | 42.36 | 41.60 | 40.83 |
| $\omega^8$ | 45.00 | 44.98 | 44.53 | 45.42 | 46.43 | 47.67 | 47.68 | 49.03 |
| $\omega^9$ | 45.00 | 44.57 | 45.99 | 47.38 | 45.51 | 46.27 | 46.02 | 45.09 |
| $\omega^{10}$ | 45.00 | 45.01 | 46.73 | 46.08 | 47.40 | 49.14 | 49.03 | 48.74 |
Table 1.3. すべて $45.00 から始まる価格のサンプルパス集合の例。
問題は、表 1.3 に示されているような観測サンプルをどのように作るか、である。典型的な戦略は3つある。
- 履歴データからサンプルを作る。任意の時点では結果は1つしかないので、異なる期間の観測を組み合わせることで複数のサンプルパスを作ることができる。異なる年の価格、異なる月の需要、異なる日に観測された移動時間などを選ぶかもしれない。このアプローチは、外生情報が状態 $S_t$ や決定 $x_t$ に依存する場合には使えない。
- 数理モデルからのシミュレーション。このアプローチには、方策の性能について統計的に信頼できる推定値を得るために大きなサンプルを生成できるという利点がある。これらのモデルは非常に精緻なものになりうるが、実データの挙動を再現しないモデル(たとえ精緻なものであっても)を作ってしまうことも極めて容易である。最大の課題は、時間的な相関、あるいはサンプル間の相関(たとえば異なる製品の需要、異なる銘柄の価格、異なる地点の風速など)を捉えることである。
- 実際に生じる観測を用いて、現場でアイデアを検証することもできる。この利点は実データを扱えることである(過去が未来と同じとは限らない)。欠点は、1日分の新しいデータを観測するのに1日かかることである(そして1日分の観測よりはるかに多くが必要になるかもしれない)。
$W_{t+1}$ が状態 $S_t$ および/または決定 $x_t$ に依存する場合には、この依存性を反映する方法を工夫しなければならない。数理モデルを作れば計算機上で多数のシミュレーションを実行できるが、情報過程のサンプルを作るには、時間を通じた相関、さらには空間的な相関も再現する必要がある。不確実性のモデリングについてのより詳細な議論は RLSO の Chapter 10 を参照されたい。
次のステップ
本書の次の5つの章では、我々のモデリングの枠組みを5つの異なる問題に適用していく。
- Chapter 2 – 資産売却問題
- Chapter 3 – 適応的マーケットプランニング
- Chapter 4 – 最適な糖尿病薬の学習
- Chapter 5 – 確率的最短経路問題 - 静的
- Chapter 6 – 確率的最短経路問題 - 動的
これらの章はいずれも、2つの在庫問題を説明するために上で用いたのと同じ構成に従う。その構成は以下の通りである。
- ナラティブ – 問題の平易な言葉による説明。
- ユニバーサルモデル – このモデルは、逐次決定問題の5つの要素、すなわち状態変数、決定変数、外生情報変数、遷移関数、目的関数を記述するという我々の形式に従う。
- 不確実性モデル – ここでは問題に含まれる不確実性の考えうるモデルを提示する。
- 方策の設計 – 意思決定を行うための方策の候補を提案する。5つの応用設定が4つの方策クラスすべてを一巡できるように問題を選んである。当面は、我々が4つのクラスのどれを選んでいるかを読者自身に見分けてもらうことにする。
- 拡張 – 最後に、方策の変更を必要とするかもしれない基本問題の拡張を1つ以上提案することがある。
その後 Chapter 7 で4つの方策クラスに立ち戻り、Chapters 2–6 の問題を使ってさまざまなモデリングのアイデアを示しながら、一般的なモデリングの枠組みを議論する。
この議論の後、例による学習という章立てのパターンに戻るが、より複雑な問題を扱う。残りの章では次の問題を取り上げる。
- Chapter 8 – エネルギー貯蔵 I
- Chapter 9 – エネルギー貯蔵 II
- Chapter 10 – サプライチェーン管理 I: 二主体ニュースベンダー
- Chapter 11 – サプライチェーン管理 II: ビールゲーム
- Chapter 12 – 広告クリック最適化
- Chapter 13 – 血液管理問題
- Chapter 14 – 臨床試験の最適化
何を学んだか
- はじめに、決定とは何かを学んだ!
- あらゆる逐次決定問題に対する一般モデル、すなわちユニバーサルモデリングフレームワークを提示した。
- まず、システムの状態が在庫量である古典的な在庫問題を用いてモデルを説明した。
- 次に、状態変数が在庫の資源状態 $R_t$、価格 $p_t$ という形の情報的な状態変数、そして推定平均と分散という形での今後の需要 $\Dhat_{t+1}$ に関する信念状態を含む、やや複雑な在庫問題へと移った。
- さまざまな情報源から到来しうる外生情報の流れをモデル化する方法を学んだ。外生情報は、状態および/または決定に依存しうる関数として表現される。
- 方策関数近似(PFA)と呼ばれる単純な方策クラスの2つの形態を示した。
- 方策は、文脈や決定の使われ方に応じて、さまざまな方法で評価できることを学んだ。
- 最後に、4つの方策クラスの簡単な概観で締めくくった。4つのクラスすべての例は Chapters 2–6 で提示され、そこで Chapter 7 にていったん立ち止まって方策をより深く議論し、Chapters 8–14 のより複雑な問題への布石とする。
演習問題
復習問題
- 逐次決定問題の数理モデルの5つの要素とは何か。
- 初期状態 $S_0$ の変数と、$t > 0$ における動的状態 $S_t$ の変数との違いは何か。
- 決定と外生情報の違いは何か。
- 方策の2つの主要なカテゴリーは何か、またそれらはどう異なるか。
- 単純な在庫問題の状態変数と、より複雑な在庫問題の状態変数を比較せよ。
問題解決演習
- 2つの在庫問題の方策を、時間依存的な挙動をどのように扱うかという観点から比較せよ。例えば、我々のピザ店は平日よりも週末の需要がはるかに大きいかもしれない。調整可能パラメータ $\theta$ を時間依存(あるいは曜日依存)にすることが、解をどのように改善しうるかという観点からその価値を論じよ。
- 在庫問題においてパラメータ $\theta$ を調整する方法を、次の場合で対比せよ。
- シミュレータ上で。
- 現場で。