Chapitre 5 : Problèmes de plus court chemin stochastique - Statique
Vue d’ensemble du chapitre
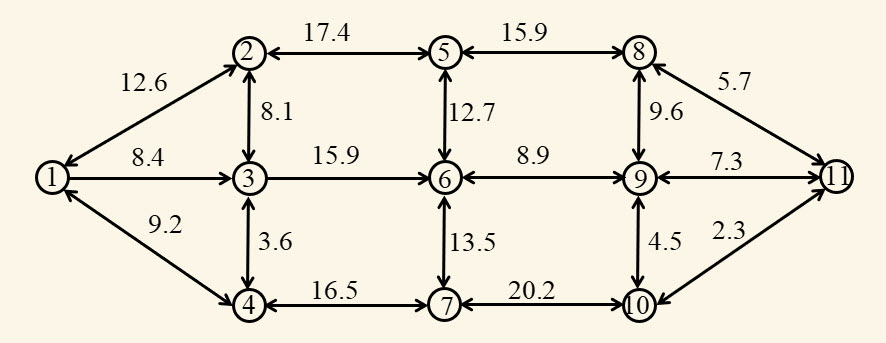
Les problèmes de plus court chemin sur les graphes constituent à la fois un domaine d’application important (que l’on retrouve dans le transport, la logistique et les communications), mais aussi une classe de problèmes fondamentale qui apparaît dans de nombreux autres contextes. Le problème de plus court chemin le plus familier est le problème déterministe classique illustré dans la Figure 5.1, où nous devons trouver le meilleur chemin du nœud 1 au nœud 11, sachant que le coût de traversée de chaque arc est connu à l’avance.
Figure 5.1. Réseau pour un problème de plus court chemin déterministe.
Dans ce chapitre, nous allons commencer par un problème de plus court chemin où les temps de trajet sont connus et fixes. La version déterministe nous permettra de démontrer une façon particulière de prendre des décisions en utilisant l’équation de Bellman. Nous introduisons ensuite l’incertitude d’une manière très spécifique qui nous permettra de démontrer une stratégie de résolution connue sous le nom de programmation dynamique approchée.
Narratif
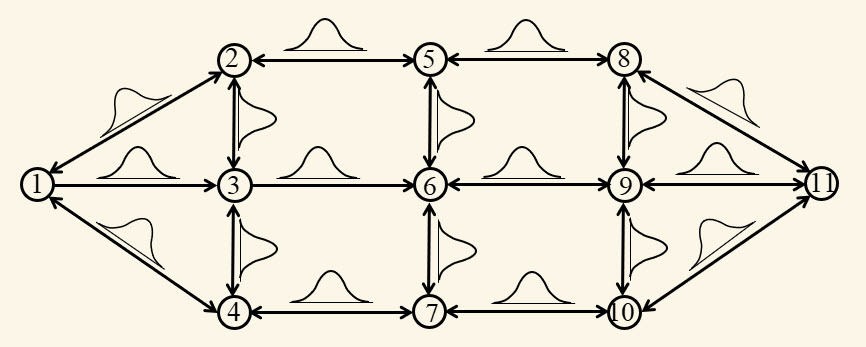
Vous essayez de créer un système de navigation qui guidera un véhicule autonome vers une destination sur un réseau congestionné. Nous supposons que notre système a accès à la fois aux coûts historiques et en temps réel des liens, à partir desquels nous pouvons créer des estimations de la moyenne et de la variance du coût de traversée d’un lien. Nous pouvons considérer cela comme un problème de plus court chemin où nous observons des distributions plutôt que des coûts réels, comme le montre la Figure 5.2.
Figure 5.2. Réseau pour un problème de plus court chemin stochastique où les distributions sont connues, mais les coûts ne sont observés qu'après que les décisions ont été prises.
Nous allons commencer par supposer que nous devons prendre des décisions quant au lien à traverser en fonction de ces distributions. Après avoir traversé un lien de $i$ à $j$, nous observons alors une réalisation échantillonnée de la distribution. Nous voulons choisir un chemin qui minimise les coûts espérés.
Cadrage du problème
Les réponses à nos trois questions de cadrage sont :
Métriques : Nous souhaitons minimiser le temps de trajet espéré jusqu’à la destination depuis l’origine du voyageur jusqu’à une destination spécifiée.
Décisions : Lorsqu’un voyageur se trouve à un nœud particulier $i$, il doit prendre une décision quant au nœud aval $j$ vers lequel se diriger, menant finalement à la destination finale.
Incertitudes : Nous considérons à la fois un problème déterministe, où il n’y a pas d’incertitude, et une version où les temps de trajet sont incertains mais sont révélés juste avant qu’un voyageur ne s’engage à traverser un lien particulier.
Modèle de base
Nous allons supposer que nous essayons de traverser le réseau de la Figure 5.2 en partant d’un nœud $q$ et en terminant à une destination $r$.
Notation
Les problèmes de plus court chemin s’appuient sur une récursion fondamentale de programmation dynamique. Soit $\Ncal$ l’ensemble de tous les nœuds du réseau (les nœuds $1, 2, \ldots, 11$), $\Ncal^+_i$ l’ensemble de tous les nœuds pouvant être atteints directement depuis le nœud $i$, $\Ncal^-_j$ l’ensemble de tous les nœuds connectés au nœud $j$, $\Lcal$ l’ensemble de tous les liens $(i,j)$ du réseau, et $c_{ij}$ le coût de traversée du lien $(i,j)$, où $j$ est supposé appartenir à l’ensemble $\Ncal^+_i$.
Soit $v_i$ le coût minimum du nœud $i$ jusqu’au nœud de destination 11. Les valeurs $v_i$ pour tous les nœuds $i\in\Ncal$ doivent satisfaire
Nous pouvons exécuter l’équation $\eqref{eq:shortestpathbellman1}$ en initialisant $v_{11}$ à zéro, et en fixant toutes les autres valeurs à un grand nombre. Si nous parcourons chaque nœud $i$ et calculons $v_i$ en utilisant l’équation $\eqref{eq:shortestpathbellman1}$ de manière répétée, les valeurs $v_i$ convergeront vers la valeur optimale. Il s’agit d’une version très inefficace d’un algorithme de plus court chemin.
Une autre façon de voir notre réseau consiste à supposer que chaque nœud $i$ est un état $S$, et à définir $V_t(S_t)$ comme étant la valeur d’être dans l’état $S_t$ au “temps” $t$. Dans notre problème de plus court chemin, nous allons utiliser $t$ pour indexer le nombre de liens que nous avons traversés sur notre chemin allant du nœud 1 au nœud représenté par $S_t$.
À partir d’un état (nœud) $S_t$, supposons que nous prenons une décision que nous appelons “$x$” qui correspondrait à une décision de traverser un lien émanant du nœud correspondant à l’état $S_t$. Nous pouvons écrire cet ensemble de décisions comme $\Xcal_s$ représentant les décisions $x$ qui sont disponibles lorsque nous sommes dans l’état $S_t = s$.
Ensuite, soit $C(s,x)$ le coût d’être dans l’état $s$ et de choisir la décision $x$, ce qui correspondrait à notre coût de lien $c_{ij}$ dans notre réseau ci-dessus. Enfin, nous allons utiliser une “fonction de transition d’état” que nous notons $S^M(s,x)$ qui nous indique vers quel état nous transitons si nous sommes dans l’état $s$ et prenons l’action $x\in\Xcal_s$.
En utilisant cette notation, nous pouvons réécrire l’équation $\eqref{eq:shortestpathbellman1}$ sous la forme
où $S_{t+1} = S^M(s,x)$. Nous pouvons exécuter l’équation $\eqref{eq:shortestpathbellman2}$ en fixant $V_T(s) = 0$ pour une valeur suffisamment grande de $T$ (c’est-à-dire le plus grand nombre de liens que nous pourrions traverser sur un chemin). Comme nous pourrions fixer $T$ trop grand, nous devons ajouter à l’ensemble des choix dans $\Xcal_s$ la possibilité de rester au nœud de destination au temps $T$. Nous fixons ensuite $t=T-1$ et exécutons $\eqref{eq:shortestpathbellman2}$ pour tous les états $s$. Nous répétons cette opération jusqu’à atteindre $t=0$. Lorsque nous exécutons le système de cette manière, l’indice temporel $t$ est en réalité un compteur du nombre de liens que nous avons traversés.
L’équation $\eqref{eq:shortestpathbellman2}$ est une version déterministe de ce que l’on appelle l’équation de Bellman. Dans le reste de ce chapitre, nous allons montrer comment utiliser l’équation de Bellman pour gérer l’incertitude dans notre problème de plus court chemin.
Variables d’état
Dans ce problème de base, l’état $S_t=N_t$ est le nœud où nous nous trouvons après $t$ traversées de liens. Il est tentant de dire simplement que le voyageur se trouve au nœud $N_t$, mais comme nous le verrons dans les extensions, des changements mineurs produisent une variable d’état plus riche, et il est important de reconnaître le véritable état de notre voyageur.
Variables de décision
Nous modélisons la décision comme étant le nœud $j$ vers lequel nous nous dirigeons étant donné que nous sommes au nœud $i$. Il existe une large communauté qui travaille sur des problèmes appartenant à cette classe où la décision est représentée comme une action $a$, où $a$ prend l’une des valeurs discrètes de l’ensemble $\Acal_s$ lorsque nous sommes dans l’état $s$.
Une façon pratique de représenter les décisions consiste à définir
\[x_{tij} = \begin{cases} 1 & \text{if we traverse link } i \text{ to } j \text{ when we are at } i, \\ 0 & \text{otherwise.} \end{cases}\]
Cette notation s’avérera utile lorsque nous écrirons notre fonction objectif.
Information exogène
Après avoir traversé le lien $(i,j)$, nous observons $\chat_{tij}$, le coût que nous subissons en traversant de $i$ à $j$ lors de la $t$ème traversée (que nous n’observons qu’après avoir traversé le lien). Pour le moment, nous allons supposer que la nouvelle observation $\chat_{tij}$ est stockée dans une très grande base de données. Nous pouvons alors les utiliser pour estimer le coût moyen $\cbar_{ij}$ de traversée du lien $(i,j)$ (nous excluons l’indice $t$ pour $\cbar_{ij}$ puisqu’il s’agit du coût moyen quel que soit le moment où nous traversons le lien $(i,j)$).
Fonction de transition
Pour notre problème de graphe de base, si nous prenons la décision $x_{tij}=1$, l’état $N_t = i$ évolue vers l’état $N_{t+1} = j$.
Fonction objectif
Nous pouvons modéliser nos coûts en utilisant la notation suivante : $\chat_{tij}$ est une variable aléatoire donnant le coût de traversée du nœud $i$ au nœud $j$ ; $\cbar_{ij}$ est une estimation de la valeur espérée de $\chat_{tij}$ calculée en faisant la moyenne sur notre base de données de coûts de trajet passés ; et $\sigmabar_{ij}$ est notre estimation de l’écart-type de $\cbar_{ij}$ calculée à partir des données historiques.
Nous supposons que nous devons prendre la décision du lien à traverser à partir d’un nœud $i$ avant de voir la valeur réelle du coût aléatoire $\chat_{tij}$. Cela signifie que nous devons prendre notre décision en utilisant notre meilleure estimation de $\chat_{tij}$, qui serait $\cbar_{ij}$.
Nous pourrions écrire notre fonction objectif en utilisant
La solution optimale de ce problème consisterait à fixer tous les $x_{tij} = 0$, ce qui signifie que nous n’obtenons pas de chemin. C’est pourquoi nous devons introduire des contraintes de la forme
Les équations $\eqref{shortestpathobjective1}$–$\eqref{shortestpathobjective5}$ représentent un programme linéaire, et il existe des logiciels puissants qui peuvent être utilisés pour résoudre ce problème lorsqu’il est écrit de cette manière. Cependant, il existe des algorithmes spécialisés (appelés simplement “algorithmes de plus court chemin”) qui tirent parti de la structure du problème pour produire des solutions exceptionnellement rapides.
Cependant, cette approche ne fournit pas de méthode pour gérer l’incertitude. Ci-dessous, nous décrivons comment résoudre le problème de plus court chemin stochastique en utilisant notre langage de conception de politiques, ce qui fournira un fondement pour traiter l’incertitude.
Modélisation de l’incertitude
Pour notre modèle de base, nous utilisons uniquement les estimations ponctuelles $\cbar_{ij}$ que nous supposons être simplement une moyenne d’observations antérieures collectées en utilisant, par exemple, des estimations de coûts de trajet tirées de smartphones équipés de GPS. Lorsque les estimations sont basées sur des observations de terrain, la méthode est dite pilotée par les données, ce qui signifie que nous n’avons pas besoin d’un modèle d’incertitude — nous avons simplement besoin de l’observer.
Par exemple, soit $\cbar_{ij}$ notre estimation actuelle du coût de trajet moyen pour le lien $(i,j)$ et supposons que nous venons d’observer un coût de $\chat_{tij}$. Nous pourrions mettre à jour notre estimation en utilisant
où $\alpha$ est un paramètre de lissage (parfois appelé taux d’apprentissage ou pas) qui est inférieur à 1.
Si nous mettons à jour nos estimations de cette manière, cela signifie que le vecteur des temps de trajet estimés $\cbar$ varie de manière dynamique, bien que nous ne fassions peut-être des mises à jour qu’une fois par jour, plutôt qu’au cours d’un trajet. Dans notre cadre de modélisation, le vecteur des estimations de coûts $\cbar$ est capturé par l’état initial $S_0$. Si nous laissons $n$ indexer le jour du trajet, nous laisserions $\cbar^n$ être les estimations de coûts utilisant les $n$ premiers jours de données, qui sont ensuite conservées dans l’état initial $S^n_0$ lors de la planification pour le jour $n+1$.
Conception des politiques
Notre “politique” pour ce problème déterministe est une fonction qui associe l’“état” (c’est-à-dire le nœud où nous nous trouvons) à une action (le lien sur lequel nous nous déplaçons). Nous pouvons résoudre ce problème en optimisant le programme linéaire représenté par les équations $\eqref{shortestpathobjective1}$–$\eqref{shortestpathobjective5}$, ce qui nous donne le vecteur $x^\ast _{ij}$ pour tous les liens $(i,j)$. Nous pouvons considérer cela comme une fonction où, étant donné l’état (nœud $i$), nous choisissons une action, qui est le lien $(i,j)$ pour lequel $x_{ij} = 1$. Nous pouvons écrire cette politique comme une fonction $X^\pi(S_t)$ en utilisant
Alternativement, nous pouvons résoudre l’équation de Bellman comme nous l’avons fait initialement pour notre problème de plus court chemin déterministe en utilisant l’équation $\eqref{eq:shortestpathbellman1}$. Cela nous donne une valeur $v_i$ qui est le coût de trajet minimum de chaque nœud $i$ jusqu’au nœud de destination $r$. Une fois ces valeurs calculées, nous pouvons prendre des décisions en utilisant la politique suivante
Cela signifie que notre problème de plus court chemin “stochastique” peut être résolu exactement comme nous avons résolu notre problème déterministe. Ci-dessous, dans nos extensions, nous montrons qu’avec une légère variante, la situation change radicalement.
Évaluation de la politique
L’évaluation de la politique n’est pas nécessaire pour ce problème, car la politique est optimale. Bien que nos coûts de liens soient stochastiques, tant que nous n’apprenons rien sur le coût réel avant d’avoir pris notre décision, les décisions optimales consistent à résoudre un problème de plus court chemin déterministe. Ce sera la dernière fois dans ce livre que nous verrons un problème de ce type.
Dans les extensions, nous allons introduire l’incertitude d’une manière qui nous permettra de présenter une stratégie algorithmique puissante appelée programmation dynamique approchée (également connue sous le nom d’apprentissage par renforcement).
Extension - Plus courts chemins stochastiques adaptatifs
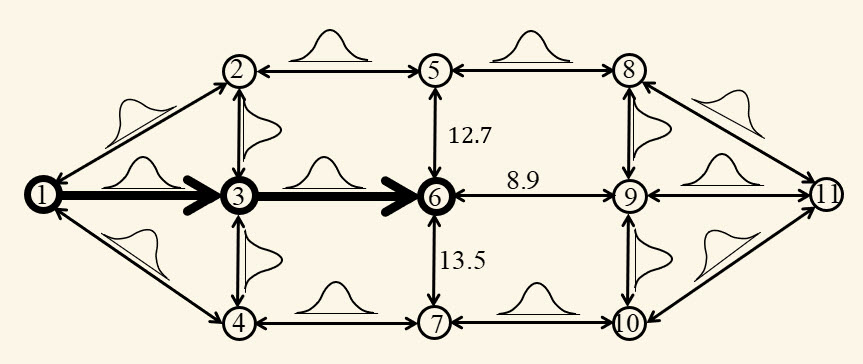
Nous allons maintenant modifier l’information dont nous disposons pour prendre nos décisions. Dans notre premier problème de plus court chemin stochastique, nous avions supposé que nous devions choisir le prochain lien à traverser avant de voir le coût de trajet réel sur ce lien. Supposons maintenant que nous prenons notre décision après avoir observé les coûts des liens, ce qui signifie que nous prenons notre décision en utilisant le coût réel $\chat_{ij}$ plutôt que son espérance (ou sa moyenne) $\cbar_{ij}$. Ceci est illustré à la Figure 5.3, où un voyageur situé au nœud 6 peut voir les coûts réels sur les liens sortant du nœud 6 (plutôt que de simplement connaître les distributions).
Figure 5.3. Réseau pour un problème de plus court chemin stochastique où les voyageurs peuvent voir les coûts des liens avant de prendre une décision. Ce graphe représente un voyageur qui a parcouru le chemin 1-3-6, et qui voit maintenant les coûts sur les liens sortant du nœud 6.
Si nous imaginons pour l’instant que quelqu’un peut nous donner les valeurs $v_j$, qui représentent le coût de trajet minimal du nœud $j$ à notre nœud de destination $r$, une politique optimale pour choisir le prochain nœud en aval s’écrirait
Le problème ici est que nous ne pouvons pas calculer $v_j$ comme nous l’avons fait précédemment à l’aide de l’équation $\eqref{eq:shortestpathbellman1}$. En fait, le passage à une observation des coûts avant la prise de décision nécessite un changement fondamental de notre modèle de base.
Dans notre modèle déterministe, ou modèle stochastique statique, la variable d’état $S_t$ après « $t$ » transitions était le nœud $i$ où se trouvait le voyageur. C’était la seule information dont nous avions besoin à cet instant.
Dans notre nouveau modèle stochastique, se contenter de capturer le nœud où se trouve notre voyageur n’est plus suffisant. Rappelons que, plus haut, nous avons introduit une variable d’état comme « toute l’information dont nous avons besoin à l’instant $t$, issue de l’historique, pour modéliser le système à partir de l’instant $t$ ». Plus loin, au Chapitre 7, nous donnerons une définition plus précise, mais pour l’instant celle-ci suffira à nos besoins.
Notre nouveau problème de plus court chemin stochastique introduit une information nouvelle, nécessaire pour prendre une décision : les coûts sortant du nœud où nous nous trouvons. Nous allons trouver commode d’introduire deux types de variables d’état : $N_t$, l’état physique du système, qui est généralement contrôlé directement par les décisions, et $I_t$, une autre information dont nous avons besoin pour prendre une décision. Dans notre problème de réseau, notre état physique serait le nœud où nous nous trouvons, tandis que la variable « autre information » $I_t$ capturerait les coûts sur les liens sortant du nœud où nous nous trouvons, que nous écrivons
\[I_t = (\chat_{tij}), i=N_t, j\in\Ncal^+_i.\]
Supposons qu’à l’instant $t$, on ait $N_t = i$. Nous allons ajouter le temps $t$ à notre indexation des coûts de lien, ce qui signifie que nous remplacerons $\chat_{ij}$ par $\chat_{tij}$ pour désigner le coût lorsque nous allons de $i$ à $j$ à l’instant $t$. Nous pourrions alors écrire
Pour voir ce que cela implique pour notre méthode précédente de résolution du problème de plus court chemin, revenons à l’équation de Bellman telle que nous l’avons introduite pour la première fois dans l’équation $\eqref{eq:shortestpathbellman2}$, qui devient
où $S_{t+1}$ serait donné par $S_{t+1} = (N_{t+1}, I_{t+1})$, où $N_{t+1}$ est le nœud produit par notre décision $x$, de sorte que si $x_{ij} =1$, alors $N_{t+1} = j$ ; et $I_{t+1}$ représente les coûts observés en sortant du nœud $N_{t+1}$, qui dépendent de la décision $x_t$. Si $x_t$ nous envoie vers le nœud $j$, de telle sorte que $N_{t+1} = j$, alors $I_{t+1} = (\chat_{t+1,jk_1}, \chat_{t+1,jk_2}, \chat_{t+1,jk_3})$ (en supposant qu’il y a trois liens sortant du nœud $j$).
Supposons que $N_t = i$. La fonction de coût $C(S_t,x)$ est donnée par
Rappelons que $S_t$ (où $N_t = i$) contient les coûts $\chat_{tij}$ pour les liens $(i,j)$ sortant de $i$, qui sont donc connus (et contenus dans $S_t$).
L’équation $\eqref{eq:shortestpathbellman5}$ est facile à écrire mais difficile à résoudre maintenant que notre variable d’état est un vecteur (ce qui fait exploser le nombre d’états). Nous allons d’abord décrire deux défis computationnels. Ensuite, nous allons introduire l’idée de l’état post-décision pour résoudre l’un des deux défis. Enfin, nous allons présenter brièvement une classe de méthodes connue sous le nom de programmation dynamique approximée (mais souvent appelée apprentissage par renforcement) pour traiter le second défi.
Défis computationnels
Commençons par identifier deux défis computationnels :
Les coûts de lien $I_{t+1}$ sortant du nœud en aval $N_{t+1}$ (déterminé par la décision $x$) ne sont pas connus. Autrement dit, $I_{t+1}$ est une variable aléatoire à l’instant $t$, ce qui signifie que nous ne pouvons même pas calculer $V_{t+1}(S_{t+1})$. Nous résolvons ce problème en prenant l’espérance, que nous écrivons comme
L’opérateur d’espérance $\E$ doit être vu comme une moyenne sur les coûts de lien possibles qu’un voyageur pourrait rencontrer une fois arrivé au nœud $N_{t+1}$ en prenant la décision $x$ (qui déterminée $N_{t+1}$).
Pour l’exprimer plus explicitement, supposons que $x_t$ nous envoie vers le nœud $j$ (ce qui signifie que $x_{tij} = 1$), et qu’à notre arrivée nous observons $I_{t+1} = (\chat_{t+1,jk_1}, \chat_{t+1,jk_2}, \chat_{t+1,jk_3})$. Nous apprenons ces coûts en arrivant au nœud $j$ à l’instant $t+1$, mais ils sont aléatoires lorsque nous sommes au nœud $i$ à l’instant $t$, en train de réfléchir à ce qu’il faut faire.
L’espace d’états – Même en supposant que les coûts $\chat_{t+1,j}$ soient discrets, l’espace d’états vient de croître considérablement. Imaginons que nous ayons discrétisé les coûts en compartiments de 20 valeurs. S’il y a trois liens sortant de chaque nœud, notre espace d’états est passé du nombre de nœuds à un espace $20 \times 20 \times 20 = 8,000$ fois plus grand.
Pour illustrer le défi que représente le calcul de l’espérance, supposons que chaque coût $\chat_{t+1,jk}$ puisse prendre les valeurs $c_1, c_2, \ldots, c_L$ avec les probabilités $p_{jk}(c_{\ell})$. Par exemple, $c_1$ pourrait être 1 minute, $c_2$ pourrait être 2 minutes, et ainsi de suite. La probabilité $p_{jk}(c_{\ell})$ est la probabilité que $\chat_{t+1,jk} = c_\ell$.
Supposons maintenant que la décision $x$ nous mène au nœud $j$, après quoi nous devons choisir entre parcourir les liens $(j,k_1), (j,k_2)$ ou $(j,k_3)$. Nous calculerions notre espérance en utilisant
Pour le dire crûment, l’équation $\eqref{eq:shortestpathexpectation}$ n’est vraiment pas élégante. Ces triples sommations vont être difficiles à calculer.
À cette difficulté s’ajoute la taille de l’espace d’états. Pour utiliser l’équation de Bellman $\eqref{eq:shortestpathbellman6}$ (ou $\eqref{eq:shortestpathbellman2}$), il nous faut calculer $V_t(S_t)$ pour chaque état possible $S_t$. Lorsque l’état était simplement un nœud, ce n’était pas trop grave, même s’il y a des milliers (voire des dizaines de milliers) de nœuds. Cependant, ajouter la variable d’information $I_t$ à l’état rend le problème considérablement plus difficile.
Pour voir à quelle vitesse cela fait croître l’espace d’états, imaginons qu’il existe 20 valeurs possibles pour chaque variable de coût $\chat_{tij}$. Cela signifie qu’il existe 8 000 valeurs possibles de $I_t$. Si notre réseau compte 10 000 nœuds (c’est-à-dire que $N_t$ peut prendre 10 000 valeurs), alors $S_t$ peut désormais prendre $10,000 \times 8,000 = 80,000,000$ valeurs.
C’est notre premier aperçu de ce qui se produit lorsqu’une variable d’état devient un vecteur. Le nombre de valeurs possibles de la variable d’état croît exponentiellement, un phénomène largement connu sous le nom de fléau de la dimensionnalité.
Utilisation de l’état post-décision
Tout n’est pas perdu pour ce problème. Il existe une astuce que nous pouvons utiliser pour surmonter le fléau de la dimensionnalité dans ce cas particulier. Le principal défi computationnel de l’équation de Bellman $\eqref{eq:shortestpathbellman6}$ est l’opérateur d’espérance, qui constitue sans doute l’élément de notation le plus dangereux dans la résolution des problèmes de décision séquentielle.
Nous allons utiliser deux stratégies puissantes pour surmonter ce problème dans ce contexte (et nous réutiliserons ces stratégies dans d’autres contextes). Premièrement, nous introduisons l’idée de l’état post-décision, que nous désignons par $S^x_t$. L’état post-décision est l’état du système immédiatement après la prise de décision, et avant l’arrivée de toute nouvelle information, ce qui explique pourquoi nous l’indexons par $t$.
Pour voir les états pré- et post-décision, revenons à la Figure 5.3. Comme nous l’avons vu précédemment, notre état pré-décision (que nous appelons « l’état ») $S_t$ est
\[S_t = (6, (12.7, 8.9, 13.5)).\]
Une fois la décision prise, nous sommes toujours au nœud 6, mais imaginons que la décision prise était d’aller vers le nœud 9. Nous pourrions décrire notre état physique post-décision $R^x_t = 9$, que nous pourrions également formuler comme « aller vers le nœud 9 ». Cependant, nous n’avons plus besoin de ces observations gênantes des coûts sur les liens sortant du nœud 6, données par $(\chat_{t+1,6,5}, \chat_{t+1,6,9}, \chat_{t+1,5,7}) = (12.7, 8.9, 13.5)$. Cela signifie que notre état post-décision est
\[S^x_t = (9).\]
En utilisant l’état post-décision, nous allons décomposer l’équation de Bellman en deux étapes. Au lieu de passer de $S_t$ à $S_{t+1}$ puis à $S_{t+2}$ comme nous le faisons dans l’équation de Bellman $\eqref{eq:shortestpathbellman6}$, nous allons d’abord passer de l’état pré-décision $S_t$ à l’état post-décision $S^x_t$, ce que nous faisons en réécrivant l’équation $\eqref{eq:shortestpathbellman6}$ comme
où $V^x_t$ est la valeur d’être dans l’état post-décision $S^x_t$. Notez que nous n’avons plus l’espérance, car par construction l’état post-décision implique une décision donnée $x_t$ (par exemple « aller vers le nœud 9 ») mais aucune information nouvelle (qui constitue la partie aléatoire). Notez que, dans ce cas, l’état post-décision $S^x_t$ ne consiste qu’en le nœud, ce qui le rend beaucoup plus simple que $S_t$.
Nous ne sommes cependant pas sortis d’affaire. Il nous reste à calculer $V^x_t(S^x_t)$, ce qui se fait en utilisant
Nous devons donc toujours calculer cette espérance, et cela n’est pas devenu plus simple. Supposons que notre décision $x$ soit d’aller vers le nœud $j$ (ce qui signifie que $x_{ij}=1$), et soit $\chat_{t+1,j} = (\chat_{t+1,jk},~k\in\Ncal^+_j)$ l’ensemble des coûts de lien sortant du nœud $j$. Notre prochain état pré-décision $S_{t+1}$ serait alors
\[S_{t+1} = (j, \chat_{t+1,j}).\]
Supposons maintenant que nous disposions d’un moyen d’échantillonner les valeurs possibles de $\chat_{t+1,j}$. Nous pourrions le faire à partir d’une base de données d’observations historiques des coûts de lien, ou construire une distribution de probabilité à partir de données passées et en tirer un échantillon. Supposons que nous procédions de manière itérative, et soit $\chat^n_{t+1,ij}$ le $n$-ième échantillon du coût de lien de $i$ à $j$. Nous pouvons utiliser cette stratégie basée sur l’échantillonnage pour créer une estimation de l’espérance, plutôt que sa valeur exacte. C’est ce qui est fait dans la section suivante.
Programmation dynamique approximée
L’utilisation de variables d’état post-décision résout le problème du calcul de l’espérance lors de la recherche de la meilleure décision $x_t$, mais il nous reste à traiter la question de la taille importante de l’espace d’états. Pour cela, nous allons nous tourner vers les méthodes largement connues sous le nom de programmation dynamique approximée, où nous remplaçons la fonction de valeur post-décision $V^x_t(S^x_t)$ par une approximation.
Nous allons construire des approximations $\Vbar^x_t(j)$ de la valeur d’être au nœud $j$, où
Soit $\Vbar^{x,n}_t(j)$ notre approximation de $\E \lbrace V_{t+1}(S_{t+1})\vert S^x_t\rbrace $ après avoir observé $n$ échantillons. Une façon de construire cette approximation consiste à utiliser des échantillons de la valeur d’être au nœud $j$. Imaginons que nous parcourions le réseau vers l’avant, en prenant des décisions à l’aide des approximations $\Vbar^{x,n-1}_t(S^x_t)$ obtenues lors des itérations précédentes, ainsi que des coûts échantillonnés $\chat^n_{tij}$. Nous pouvons obtenir une estimation échantillonnée de la valeur d’être dans l’état $S_t$ en utilisant
Nous allons ensuite utiliser $\vhat^{x,n}_t(i)$, qui est la valeur d’être dans l’état $S_t$ (lequel inclut à la fois le nœud $i$ et les coûts $\chat^n_{tij}$ pour tous les $j$ sortant du nœud $i$), pour mettre à jour l’état post-décision précédent $S^x_{t-1}$, ce que nous faisons en utilisant
Ici, $\alpha_n$ est appelé facteur de lissage ou taux d’apprentissage, mais pour des raisons techniques on l’appelle aussi « pas ». Nous pourrions utiliser une constante telle que $\alpha_n = .1$ ou $.05$, mais une stratégie courante consiste à utiliser une formule décroissante telle que
\[\alpha_n = \frac{\theta^\alpha}{\theta^\alpha + n - 1},\]
où $\theta^\alpha$ est un paramètre ajustable. Par exemple, si nous fixons $\theta^\alpha = 1$, nous obtenons $\alpha_n = 1/n$. Dans ce cas, il est possible de vérifier que l’équation $\eqref{eq:vhatsmoothing}$ réalise une moyenne sur les valeurs $\vhat^n_t(i)$. En pratique, cette formule risque de ne pas bien fonctionner pour ce problème, car le pas tend vers zéro trop rapidement.
Nous nous arrêtons un instant pour souligner deux avantages de l’utilisation de l’état post-décision $S^x_t$ :
Nous n’avons plus à traiter l’espérance lors de l’optimisation sur le choix des liens sortants d’un nœud (voir l’équation $\eqref{eq:vhatsinglepass}$).
L’approximation de la fonction de valeur $\Vbar^{x,n}_t(S^x_t = i)$ est beaucoup plus simple, puisque l’état post-décision $S^x_t$ est désormais simplement un scalaire, qui est bien plus facile à estimer qu’une fonction de dimension plus élevée.
Un défi avec l’équation $\eqref{eq:vhatsinglepass}$ est que nous allons avoir besoin de valeurs initiales pour $\Vbar^{x,0}_t(i)$. Un choix naturel serait de résoudre la version déterministe de ce problème où les coûts $\chat_{tij}$ sont fixés égaux à des estimations de leurs moyennes, puis d’obtenir des estimations initiales du coût encouru pour aller de chaque nœud à la destination.
Une méthode alternative consiste à utiliser les estimations $\Vbar^{x,n-1}(i)$ pour prendre des décisions en utilisant
La décision $i^n_t = x^n_t(i)$ nous donne le nœud suivant après le nœud $i$ sur la base des coûts échantillonnés $\chat^n_{tij}$ et des estimations du coût $\Vbar^{x,n-1}_t(j)$ pour aller du nœud $j$ au nœud de destination $r$. Lorsque nous arrivons à $r$, nous disposons d’un chemin complet constitué des nœuds
\[(q, i^n_1, i^n_2, \ldots, r).\]
Nous disposons également des coûts échantillonnés $\chat^n_{t,i^n_t,i^n_{t+1}}$ sur l’ensemble du chemin. Supposons qu’il y ait $T$ liens dans le chemin. Nous parcourons alors le chemin en arrière en commençant par $\vhat^n_T(r) = 0$, et en calculant
Nous utilisons ensuite ces estimations dans notre processus de lissage dans l’équation $\eqref{eq:vhatsmoothing}$.
Cette procédure est une forme de programmation dynamique approximative (également appelée apprentissage par renforcement). Plus précisément, il s’agit d’une forme de programmation dynamique approximative en avant car elle progresse en avançant pas à pas dans le temps. Nous avons illustré une procédure de passage avant pur en utilisant l’équation $\eqref{eq:vhatsinglepass}$, qui nécessite des passages uniques à travers le réseau, ainsi qu’une procédure à double passage utilisant l’équation $\eqref{eq:vhatdoublepass}$, qui consiste d’abord à avancer dans le graphe en simulant des décisions, puis à revenir en arrière pour mettre à jour la valeur d’être dans chaque état.
Cette méthode est très robuste vis-à-vis d’états pré-décisionnels complexes. Par exemple, peu importe le nombre de liens sortant de chaque nœud, car nous exploitons le fait que notre variable d’état post-décision est assez simple (dans ce cas, il s’agit simplement du nœud où nous nous trouvons).
Qu’avons-nous appris ?
C’est la première (et seule) fois que nous avons un problème pour lequel nous pouvons trouver la politique optimale pour un problème de décision séquentielle. Bien que nous optimisions sur un réseau stochastique, le voyageur ne reçoit aucune information anticipée sur un lien avant de le parcourir, ce qui signifie qu’il doit faire son choix sur la base des coûts espérés.
Puisque le modèle de base se réduit à un problème de plus court chemin déterministe, nous pouvons le résoudre de manière optimale, ce qui constitue un exemple rare où l’on peut résoudre le problème de base de façon optimale (en fait, c’est la seule fois que cela se produira dans ce livre).
Nous introduisons ensuite la dimension selon laquelle les coûts sont révélés avant que le voyageur ne traverse le lien. Nous reformulons le problème, montrant que la variable d’état devient désormais beaucoup plus complexe, comprenant le nœud où se trouve le voyageur et les coûts des liens sortant du nœud. Ce problème ne peut plus être résolu exactement par programmation dynamique.
Nous introduisons et décrivons un algorithme de programmation dynamique approximative utilisant le concept de variable d’état post-décision, qui élimine l’espérance intégrée dans l’équation de Bellman, et réduit l’espace d’état à nouveau au simple ensemble des nœuds.
Il s’agit d’un exemple de politique VFA. Puisque nous ne pouvons pas calculer les fonctions de valeur exactement, nous ne pouvons pas garantir qu’il s’agit d’une politique optimale.
Exercices
Questions de révision
Dans le problème original de plus court chemin stochastique où nous n'observons le coût réel qu'après avoir traversé le lien, expliquez pourquoi ce problème peut être résolu exactement comme un simple problème de plus court chemin déterministe.
Pour la version où nous observons le coût réel sur un lien avant de choisir dans quelle direction se déplacer, donnez les variables d'état pré-décision et post-décision.
Dans l'équation $\eqref{eq:vhatsmoothing}$, nous utilisons la valeur échantillonnée $\vhat^{x,n}_t(i)$ d'être dans l'état $S_t$ pour mettre à jour la valeur estimée d'être à l'état post-décision précédent donné par $\Vbar^{x,n}_{t-1}(i)$. Créez un petit exemple numérique pour illustrer cette équation.
Questions de résolution de problèmes
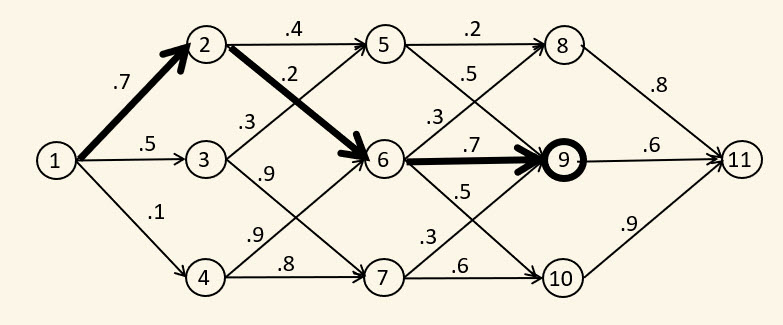
Un voyageur doit traverser le graphe présenté dans la Figure 5.4 du nœud 1 au nœud 11. Il existe une probabilité que chaque lien puisse être traversé, indiquée sur le graphe (ces probabilités sont connues à l'avance). Lorsque le voyageur arrive au nœud $i$, il découvre quels liens (le cas échéant) peuvent être traversés à partir du nœud $i$. Si aucun lien ne peut être traversé, alors le trajet s'arrête en échec. L'objectif est de choisir un chemin qui maximise le produit de ces probabilités, mais il est limité à voyager sur les liens disponibles.
Décrivez une variable d'état appropriée pour ce problème (avec sa notation).
Imaginez que le voyageur soit au nœud 6 en ayant suivi le chemin 1-2-6, puis constate que les liens 6-9 et 6-10 sont disponibles (mais pas 6-8) ; quel est son état (pré-décision) ? Je cherche les valeurs numériques des variables d'état que vous avez fournies à la partie (a).
Supposez que le voyageur soit en mesure de se déplacer vers le nœud 9, et décide de le faire. Quel est l'état post-décision après avoir pris cette décision ?
Écrivez l'équation de Bellman qui caractérise la valeur d'être dans l'état pré-décision après avoir parcouru le chemin 1-2-6 en fonction des états pré-décision en aval. Calculez numériquement la valeur d'être dans l'état après avoir parcouru 1-2-6 et observé que 6-9 et 6-10 sont disponibles (mais pas 6-8).
Figure 5.4. Un problème de plus court chemin pour maximiser la probabilité de compléter un chemin.
(Cette question s'applique à l'extension du plus court chemin stochastique adaptatif présentée ci-dessus.) Écrivez les étapes impliquées dans l'ajustement d'une approximation de fonction de valeur pour les états post-décision en répondant aux questions suivantes :
Écrivez les états pré-décision et post-décision. Si le réseau comporte $N$ nœuds, et si les coûts sur chaque lien sont discrétisés en 20 valeurs (supposez au plus $L$ liens sortant de n'importe quel nœud), quelle est la taille des espaces d'état pré-décision et post-décision ?
Donnez l'équation permettant de calculer $\vhat^n_t(i)$. S'agit-il de l'estimation d'être à un état pré-décision ou à un état post-décision ? Expliquez.
À quoi correspond l'indice « temps » $t$ ?
Donnez l'équation de mise à jour pour la valeur d'être à un état post-décision.
Pourquoi avons-nous besoin de la valeur d'être à un état post-décision plutôt qu'à un état pré-décision ?
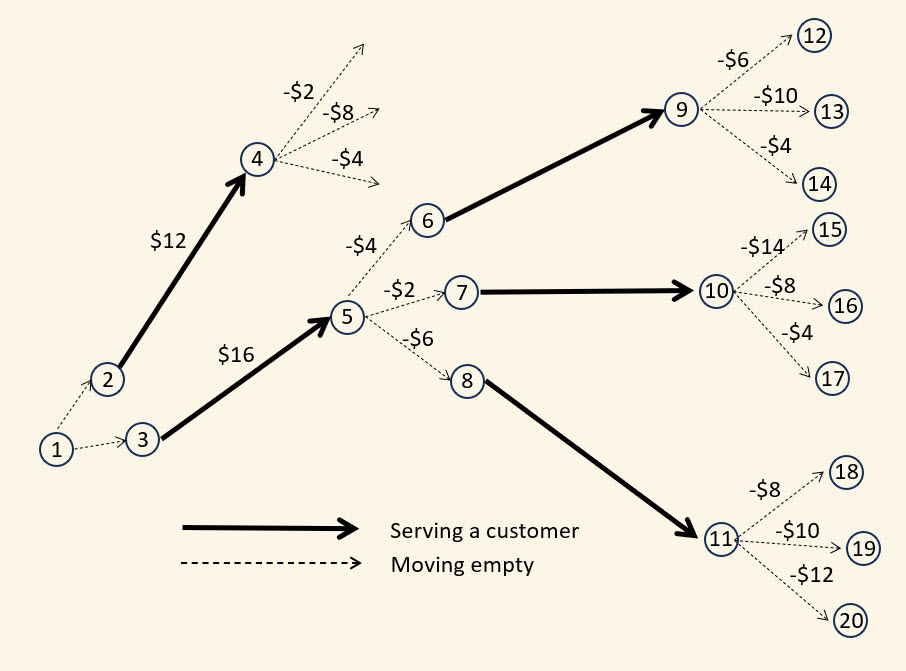
La Figure 5.5 illustre les choix auxquels un chauffeur Uber pourrait être confronté. Au nœud 1, elle a le choix entre les trajets (2-4) et (3-5). Supposons que les trajets durent au moins 15 minutes, et que les trajets doivent être servis dans les 10 minutes sinon ils sont perdus. Cela signifie que les trajets sortant des nœuds 6, 7 et 8 ne deviennent connus qu'après que les trajets (2-4) et (3-5) auraient été complétés.
Figure 5.5. Un arbre de décision illustrant les choix auxquels est confronté un chauffeur Uber.
Supposons que notre conductrice choisisse d'abord (3-5) puis (7-10). Après avoir complété (7-10), elle doit se rendre à une station de recharge pour recharger sa batterie avant de rentrer chez elle (supposez qu'elle choisit la station de recharge au coût le plus faible).
À côté de chaque déplacement figure ce qu'elle gagne (notons cela par $c_{ij}$), qui est positif lorsqu'elle sert un client et négatif lorsqu'elle se déplace à vide. Bien entendu, elle cherche à maximiser ses profits sur l'ensemble de son service.
L'état de notre conductrice est sa localisation (numéro de nœud) ou le numéro de nœud vers lequel elle se dirige, ainsi que toute autre information disponible connue à ce moment-là et pertinente pour sa décision.
Étant donné qu'elle se trouve initialement au nœud 1, quel est son état (pré-décision) ? Quel est son état post-décision après avoir décidé d'accepter le trajet (3-5) ?
Soit $s_1$ l'état (pré-décision) après avoir servi le trajet (3-5). Soit $\vhat_1(s_1)$ la valeur d'être dans l'état $s_1$. Que vaut $\vhat_1(s_1)$ ?
Soit $s^x_0$ l'état post-décision précédent avant $s_1$, et soit $\vhat^x_0(s^x_0)$ la valeur d'être dans $s^x_0$. Que vaut $\vhat^x_0(s^x_0)$ ?
Quel est l'avantage computationnel d'utiliser les états post-décision plutôt que les états pré-décision en termes de calcul d'une politique ? Cette réponse doit tenir en une phrase.
Questions de programmation
Ces exercices utilisent le module Python StochasticShortestPath_Static disponible sur tinyurl.com/sdagithub.
(Cette question s'applique à l'extension du plus court chemin stochastique adaptatif présentée ci-dessus.) Actuellement, l'algorithme utilise un facteur de lissage fixe pour estimer les approximations de fonction de valeur lors de la résolution du problème modifié dans l'extension. Implémentez un pas décroissant, comme suit :
$$
\alpha_n = \frac{\theta^{step}}{\theta^{step} + n-1}.
$$
Exécutez le module Python pour $\theta^{step} = (1, 5, 10, 20, 50)$ pendant 100 itérations, et comparez les performances en termes de vitesse de convergence et de solution finale. Lequel choisiriez-vous ?