Chapitre 4 : Apprendre le meilleur médicament pour le diabète
Aperçu du chapitre
Apprendre le meilleur choix de médicament pour le diabète reprend là où notre problème du vendeur de journaux s’était arrêté, où des périodes de temps successives sont liées par ce que nous croyons savoir sur des paramètres inconnus. Ici, nous essayons d’apprendre quel est le meilleur d’un ensemble de médicaments contre le diabète pour un patient particulier. Nous essayons un médicament, observons ce que nous supposons être une réponse bruitée, puis mettons à jour nos croyances pour décider quoi essayer ensuite, en cherchant à maximiser la réduction du taux de sucre dans le sang. Cette classe de problèmes a été étudiée sous divers noms, notamment problème de bandit multibras, recherche stochastique sans dérivée, ou essai-erreur intelligent.
Au cœur de ce problème se trouvent nos croyances sur la manière dont différents médicaments vont se comporter. Pour garder la présentation aussi simple que possible, nous supposons que ce que nous observons d’un médicament ne nous apprend rien sur la performance des autres médicaments, une propriété connue sous le nom de croyances indépendantes. Un cas plus intéressant et pertinent capturerait des croyances corrélées, mais cela aurait compliqué la présentation.
Nous ne considérons que les types de politiques les plus simples, qui sont tous des formes d’approximations de fonctions de politique. Celles-ci sont assez simples à utiliser, mais elles impliquent toutes des paramètres réglables, ce qui n’est pas abordé dans ce chapitre.
Nous considérons comme extension le cas où nous souhaitons utiliser ce que nous apprenons d’un patient pour d’autres patients ayant des attributs similaires. Ceci introduit les attributs d’un patient dans la variable d’état, produisant ce qui est connu sous le nom de problème de bandit contextuel, ce qui signifie apprendre la performance du médicament dans le « contexte » des attributs du patient. Nous revenons sur ces questions dans un contexte de problème beaucoup plus riche au Chapitre 12 pour le problème d’optimisation du choix des URL à afficher afin de maximiser les clics publicitaires.
Cadrage du problème
Les réponses à nos trois questions de cadrage sont :
- Métriques : Nous souhaitons réduire le taux de sucre dans le sang du patient (mesuré par l’A1c) jusqu’à un niveau cible.
- Décisions : Pour ce chapitre, nous choisissons simplement le type de médicament à administrer (normalement, il faudrait aussi trouver le meilleur dosage, mais nous supposons que le dosage est déterminé par le type de médicament et le poids du patient).
- Incertitudes : Dans quelle mesure un médicament réduit l’A1c du patient. Il se peut que le patient ne tolère pas un médicament, auquel cas nous fixerions la réduction de l’A1c à zéro.
Récit
Lorsque des personnes découvrent qu’elles ont un taux de sucre dans le sang élevé, généralement évalué à l’aide d’une métrique appelée « A1c », il existe plusieurs dizaines de médicaments répartis en quatre grands groupes :
- Sensibilisateurs – Ils ciblent les cellules du foie, des muscles et de la graisse pour augmenter directement la sensibilité à l’insuline, mais peuvent provoquer une rétention d’eau et ne devraient donc pas être utilisés chez les patients ayant des antécédents d’insuffisance rénale.
- Sécrétagogues – Ces médicaments augmentent la sensibilité à l’insuline en ciblant le pancréas mais provoquent souvent une hypoglycémie et une prise de poids.
- Inhibiteurs de l’alpha-glucosidase – Ils ralentissent le taux de métabolisme de l’amidon dans l’intestin, mais peuvent provoquer des troubles digestifs.
- Analogues peptidiques – Ils imitent les hormones naturelles du corps qui stimulent la production d’insuline.
Le médicament le plus populaire est un type de sensibilisateur appelé metformine, qui est presque toujours le premier médicament prescrit à un nouveau diabétique, mais cela ne fonctionne pas toujours. Avant de travailler avec un patient particulier, un médecin peut avoir une croyance sur le potentiel de la metformine, et des médicaments de chacun des quatre groupes, pour réduire le taux de sucre dans le sang, comme illustré dans la Figure 4.1.
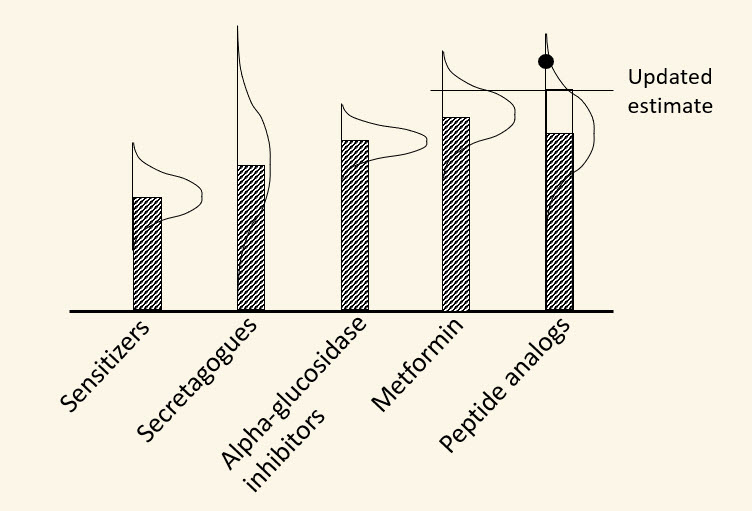
Un médecin commencera généralement par la metformine, mais cela ne fonctionne que pour environ 70 pour cent des patients. Souvent, les patients ne tolèrent tout simplement pas un médicament (il peut provoquer de graves troubles digestifs). Lorsque c’est le cas, les médecins doivent commencer à expérimenter différents médicaments. C’est un processus lent, car il faut plusieurs semaines avant de pouvoir évaluer l’effet qu’un médicament a sur un patient. Après avoir testé un médicament sur un patient pendant une période donnée, nous observons la réduction du niveau d’A1c, puis utilisons cette observation pour mettre à jour notre estimation de l’efficacité du médicament sur le patient.
Notre défi consiste à trouver une politique permettant d’identifier le médicament qui obtient la plus grande réduction possible du niveau d’A1c d’un patient.
Modèle de base
Pour notre modèle de base, nous allons supposer que nous disposons de cinq choix de médicaments : la metformine, ou un médicament (autre que la metformine) tiré de l’un des quatre grands groupes de médicaments. Soit $\Xcal = \lbrace x_1, x_2, x_3, x_4, x_5\rbrace $ les cinq choix. En observant la performance de chaque médicament sur des centaines ou des milliers de patients, il est possible de construire une distribution de probabilité de la réduction des niveaux d’A1c sur l’ensemble des patients. Les résultats de cette analyse sont présentés dans le Tableau 4.1, qui indique la réduction moyenne et l’écart-type sur l’ensemble des patients. Nous supposons que la distribution des réductions d’A1c dans la population suit une loi normale, avec des moyennes et des écarts-types donnés dans le tableau.
| Médicament | Réduction de l'A1c | Écart-type |
|---|---|---|
| Metformine | 0.32 | 0.12 |
| Sensibilisateurs | 0.28 | 0.09 |
| Sécrétagogues | 0.30 | 0.17 |
| Inhibiteurs de l'alpha-glucosidase | 0.26 | 0.15 |
| Analogues peptidiques | 0.21 | 0.11 |
Tableau 4.1. La metformine et les quatre classes de médicaments et la réduction moyenne sur l'ensemble de la population.
Pour créer un modèle, soit $\mubar^0_x$ la réduction moyenne de l’A1c pour le choix de médicament $x$ sur l’ensemble de la population, et soit $\sigmabar^0_x$ l’écart-type de la réduction de l’A1c pour le médicament $x$. Notre intérêt est d’apprendre le meilleur médicament pour un individu particulier. Bien que nous puissions décrire le patient à l’aide d’un ensemble d’attributs, pour l’instant nous allons seulement supposer que les caractéristiques du patient ne modifient pas notre croyance sur la performance de chaque médicament pour un patient individuel.
Nous ne connaissons pas la réduction que nous pouvons attendre de chaque médicament, nous la représentons donc par une variable aléatoire $\mu_x$, où nous supposons que $\mu_x$ suit une loi normale, que nous écrivons
\[\mu_x \sim N(\mubar^0_x, (\sigmabar^0_x)^2).\]Nous appelons la distribution normale $N(\mubar^0_x, (\sigmabar^0_x)^2)$ la distribution de croyance a priori sur $\mu_x$.
Nous indexons chaque itération de prescription d’un médicament par $n$ qui commence à 0, ce qui fait référence au moment précédant toute expérimentation. Supposons que nous observions toujours un patient pendant une période fixe (disons, un mois). Si nous essayons un médicament $x$ sur un patient, nous faisons une observation bruitée de la valeur vraie $\mu_x$ de la réponse du patient à un médicament. Supposons que nous fassions un choix de médicament $x^n$ en utilisant ce que nous savons après $n$ essais, après quoi nous observons le résultat du $n+1$e essai, que nous notons $W^{n+1}$ (il s’agit de la réduction du niveau d’A1c). Cela peut s’écrire
\[W^{n+1} = \mu_{x^n} + \varepsilon^{n+1}.\]Rappelons que nous ne connaissons pas $\mu_x$ ; il s’agit d’une variable aléatoire, où $\mubar^n_x$ est notre estimation actuelle de la moyenne de $\mu_x$.
Variables d’état
Notre variable d’état est notre croyance sur la variable aléatoire $\mu_x$ qui représente l’effet réel de chaque médicament sur un patient particulier après $n$ essais. $S^0$ est l’état initial, que nous écrivons
\[S^0 = (\mubar^0_x, \sigmabar^0_x)_{x\in\Xcal},\]où nous incluons également dans $S^0$ l’hypothèse de normalité, qui reste valable tout au long des expérimentations. Après $n$ expériences, l’état est
\[S^n = (\mubar^n_x, \sigmabar^n_x)_{x\in\Xcal},\]où nous n’incluons plus l’hypothèse de normalité car elle est capturée dans notre état initial (la distribution est statique, donc par convention nous ne l’incluons pas dans la variable d’état dynamique).
Plus loin, nous trouverons utile de travailler avec la précision de notre croyance, donnée par
\[\beta^n_x = \frac{1}{(\sigmabar^n_x)^2}.\]Nous pouvons alors écrire notre variable d’état comme
\[S^n = (\mubar^n_x, \beta^n_x)_{x\in\Xcal}.\]Nous utilisons ce que l’on appelle un modèle de croyance bayésien. Dans ce modèle, nous traitons la valeur inconnue d’un médicament, $\mu_x$, comme une variable aléatoire avec une distribution a priori initiale donnée par $S^0$. Après $n$ expériences avec différents médicaments, nous obtenons la distribution de croyance a posteriori $S^n$.
Variables de décision
La décision est le choix du médicament à essayer pendant un mois, que nous notons $x^n$, le choix du médicament, où $x^n \in \Xcal = \lbrace x_1, \ldots, x_5\rbrace $. Nous allons déterminer $x^n$ à l’aide d’une politique $X^\pi(S^n)$ qui dépend uniquement de la variable d’état $S^n$ (ainsi que de l’hypothèse de la distribution normale dans $S^0$).
Information exogène
Après avoir pris la décision $x^n$, nous observons $W^{n+1}_x$, la réduction du niveau d’A1c résultant du médicament $x=x^n$ que nous avons prescrit pour le $n+1$e essai. Un lecteur pourrait se demander pourquoi nous écrivons l’information apprise à partir de la décision $x^n$ sous la forme $W^{n+1}_x$ plutôt que $W^n_x$. Nous faisons cela pour capturer l’information disponible dans chaque variable. Ainsi, la décision $x^0$ dépend uniquement de l’état initial $S^0$. L’état $S^n$ pour $n\geq 1$ dépend de $S^0$ ainsi que des observations $W^1_{x^0}, \ldots, W^n_{x^{n-1}}$, mais pas de $W^{n+1}_{x^n}$, puisque nous n’avons pas encore terminé le $n+1$e essai qui révélerait $W^{n+1}_{x^n}$. En laissant $W^{n+1}_{x^n}$ être le résultat de la prescription $x^n$, nous savons que $x^n$ ne peut pas dépendre de $W^{n+1}$, ce qui reviendrait à voir dans le futur.
Fonction de transition
La fonction de transition capture comment la réduction observée de l’A1c, $W^{n+1}_x$, affecte notre état de croyance $S^n$. Bien que cela nécessite un peu d’algèbre, il est possible de montrer que si nous essayons le médicament $x=x^n$ et observons $W^{n+1}_x$, nous pouvons mettre à jour notre estimation de la moyenne et de la précision en utilisant
\[\begin{align} \mubar^{n+1}_x &= \frac{\beta^n_x\mubar^n_x + \beta^W W^{n+1}_x}{\beta^n_x + \beta^W},\label{eq:diabetestransition1}\\ \beta^{n+1}_x &= \beta^n_x + \beta^W.\label{eq:diabetestransition2} \end{align}\]où $\beta^W$ est la précision d’une observation (nous pouvons la rendre dépendante de $x$ si nécessaire). Pour tout $x\ne x^n$, $\mubar^n_x$ et $\beta^n_x$ restent inchangés.
La fonction de transition, que nous avons précédemment écrite comme une fonction générique $S^{n+1} = S^M(S^n,x^n,W^{n+1})$, est donnée par les équations $\eqref{eq:diabetestransition1}$–$\eqref{eq:diabetestransition2}$.
Fonction objectif
Chaque fois que nous prescrivons un médicament $x=x^n$, nous observons la réduction de l’A1c représentée par $W^{n+1}_{x^n}$. Nous voulons trouver une politique qui choisit un médicament $x^n = X^\pi(S^n)$ maximisant la réduction totale attendue de l’A1c. Notre modèle canonique utilisait $C(S^n,x^n,W^{n+1})$ comme métrique de performance. Pour ce problème, cela donnerait
\[C(S^n,x^n,W^{n+1}) = W^{n+1}_{x^n}.\]Nous écrivons le problème de recherche de la meilleure politique comme
\[\begin{align} \max_\pi \E \left\{\sum_{n=0}^{N-1} W^{n+1}_{x^n}\vert S_0\right\}, \label{eq:diabetesobjective1} \end{align}\]où $x^n = X^\pi(S^n)$, et $S^{n+1} = S^M(S^n,x^n,W^{n+1})$. Ici, le conditionnement sur $S_0$ est particulièrement important car il porte la distribution a priori de croyance.
Modélisation de l’incertitude
L’échantillonnage de résultats aléatoires pour notre problème de vente d’actifs était relativement simple. Pour notre contexte médical, générer des résultats des variables aléatoires $W^1, \ldots, W^n, \ldots$ est un peu plus complexe.
Avec le problème de vente d’actifs, nous générions des variables aléatoires de moyenne 0 et de variance donnée, que nous supposions connue. Dans cette application médicale, la réduction de l’A1c due à un médicament particulier est une observation bruitée de la moyenne vraie $\mu_x$ (pour un patient particulier) que nous pouvons écrire comme
\[W^{n+1} = \mu_x + \varepsilon^{n+1},\]où $\varepsilon^{n+1}$ suit une loi normale de moyenne 0 et de variance (que nous supposons connue) donnée par $(\sigma^W)^2$. Le véritable enjeu est que nous ne connaissons pas $\mu_x$. Compte tenu de ce que nous savons après $n$ expériences avec différents médicaments, nous supposons que $\mu_x$ suit une loi normale de moyenne $\mubar^n_x$ et de précision $\beta^n_x$. Nous écrivons cela comme
\[\begin{align} \mu_x\vert S^n \sim N(\mubar^n_x, \beta^n_x) \label{eq:mugivenS} \end{align}\]où le côté droit de $\eqref{eq:mugivenS}$ se lit « la moyenne $\mu_x$ étant donné l’état $S^n$ » ce qui signifie que nous supposons savoir que la moyenne $\mu_x$ est donnée par $\mubar^n_x$. Nous utilisons la précision $\beta^n_x$ (qui est l’inverse de la variance) au lieu de la variance habituelle lorsque nous écrivons notre distribution normale. Nous écrivons ensuite la distribution de $W^{n+1}$ conditionnée sur $\mu_x$ en utilisant
\[W^{n+1}\vert \mu_x \sim N(\mu_x, \beta^W_x).\]Cela signifie que nous devons simuler deux variables aléatoires : la performance réelle du médicament $x$ sur notre patient, donnée par $\mu_x$ (compte tenu de nos croyances après $n$ expériences), puis le bruit $\varepsilon^{n+1}$ lorsque nous essayons d’observer $\mu_x$. Cela signifie simplement qu’au lieu de générer une seule variable aléatoire normalement distribuée, comme nous l’avons fait dans notre problème de vente d’actif, nous devons en générer deux.
Conception des politiques
Une classe populaire de politiques pour cette classe de problèmes relève d’une catégorie connue sous le nom de bornage de confiance supérieure (upper confidence bounding). L’une des premières politiques UCB a la forme
\[\begin{align} X^{UCB}(S^n) = \argmax_{x\in\Xcal} \left(\mubar^n_x + 4 \sigma^W \sqrt{\frac{\log n}{N^n_x}}\right), \label{eq:diabetesUCB1} \end{align}\]où $N^n_x$ est le nombre de fois où nous avons essayé le médicament $x$ (rappelons que « $\argmax_x$ » renvoie la valeur de $x$ qui atteint le maximum). Il est d’usage courant de remplacer le coefficient $4 \sigma^W$ par un paramètre ajustable, ce qui nous donne
\[\begin{align} X^{UCB}(S^n\vert \theta^{UCB}) = \argmax_{x\in\Xcal} \left(\mubar^n_x + \theta^{UCB} \sqrt{\frac{\log n}{N^n_x}}\right). \label{eq:diabetesUCB2} \end{align}\]Une variante populaire dont nous avons constaté qu’elle fonctionne étonnamment bien a été introduite à l’origine sous le nom d’estimation par intervalle, donnée par
\[\begin{align} X^{IE}(S^n\vert \theta^{IE}) = \argmax_{x\in\Xcal} \left(\mubar^n_x + \theta^{IE} \sigmabar^n_x \right), \label{eq:diabetesIE} \end{align}\]où $\sigmabar^n_x$ est l’écart-type de l’estimation $\mubar^n_x$.
Les politiques $\eqref{eq:diabetesUCB2}$–$\eqref{eq:diabetesIE}$ partagent toutes deux la structure consistant à choisir le médicament $x$ qui maximise notre estimation de sa performance $\mubar^n_x$ plus un terme souvent appelé « bonus d’incertitude ». L’intuition derrière ces politiques est que les estimations $\mubar^n_x$ peuvent être faibles en raison de malchance. Sans le bonus d’incertitude, quelques résultats médiocres pourraient signifier que nous ne réessayons jamais un médicament. Ces politiques ont attiré une attention considérable de la littérature de recherche, qui peut dériver des bornes théoriques sur leur performance, mais en fin de compte tout dépend de comparaisons expérimentales utilisant des données réalistes. Une étape importante dans l’évaluation des politiques est le réglage du paramètre $\theta^{UCB}$ ou $\theta^{IE}$.
Une troisième stratégie qui a attiré une attention considérable est connue sous le nom d’échantillonnage de Thompson. Cette approche prend un échantillon aléatoire de notre croyance sur $\mu_x$ pour chaque médicament $x$, puis prend le meilleur d’entre eux. Plus précisément, soit
\[\muhat^n_x \sim N(\mubar^n_x, \theta^{TS} \sigmabar^n_x)\]un échantillon aléatoire tiré d’une distribution normale de moyenne $\mubar^n_x$ et d’écart-type $\sigmabar^n_x$, qui représente notre croyance actuelle sur la réponse réelle $\mu_x$. Le paramètre $\theta^{TS}$ est un paramètre ajustable qui influence l’incertitude que nous avons autour de la moyenne estimée $\mubar^n_x$.
Choisissons maintenant le médicament à essayer ensuite en utilisant
\[\begin{align} X^{TS}(S^n\vert \theta^{TS}) = \argmax_{x\in\Xcal} \muhat^n_x. \label{eq:thompsonsampling} \end{align}\]L’échantillonnage de Thompson favorise les choix où la performance estimée $\mubar^n_x$, compte tenu de ce que nous savons après $n$ observations (à travers tous les médicaments), mais randomise la performance. Cette randomisation encourage l’exploration, puisque les médicaments dont l’impact estimé sur l’A1c n’est peut-être pas le plus élevé ont tout de même une chance de ressortir avec la valeur échantillonnée la plus élevée $\muhat^n_x$.
Nous notons que ces trois politiques, $X^{UCB}(S^n\vert \theta^{UCB})$, $X^{IE}(S^n\vert \theta^{IE})$ et $X^{TS}(S^n\vert \theta^{TS})$, partagent toutes deux caractéristiques : la politique elle-même nécessite la résolution d’un problème d’optimisation (le « $\argmax_x$ »), et elles ont toutes des paramètres ajustables. Pour cette raison, ce sont toutes des exemples d’approximations de fonction de coût (ou CFA).
Évaluation de la politique
Nous avons initialement écrit notre fonction objectif comme
\[\max_\pi F^\pi(S_0) = \E \left\{\sum_{n=0}^{N-1} W^{n+1}_{x^n}\vert S_0\right\},\]mais écrire l’espérance de cette manière est un peu vague. Rappelons que nous avons deux ensembles de variables aléatoires : les valeurs réelles de $\mu_x$ pour tout $x\in\Xcal$, et les observations $W^1, \ldots, W^N$ (ou plus précisément, le bruit lorsque nous essayons d’observer $\mu_x$). Nous pouvons exprimer cette dépendance imbriquée en écrivant la fonction objectif comme
\[\max_\pi F^\pi(S_0) = \E_\mu \E_{W^1, \ldots, W^N\vert \mu} \left\{\sum_{n=0}^{N-1} W^{n+1}_{x^n}\vert S_0\right\}.\]Il existe deux façons de simuler la valeur d’une politique :
- Échantillonnage imbriqué – D’abord, nous simulons la valeur de la vérité $\mu_x$ pour tout $x\in\Xcal$ où nous laissons $\psi\in\Psi$ être une réalisation échantillonnée de $\mu$, que nous écrivons $\mu(\psi)$. Nous simulons ensuite les observations $W$, où nous laissons $\omega\in\Omega$ être une réalisation échantillonnée de $W^1(\omega), \ldots, W^N(\omega)$, ce qui signifie que $\omega$ est un résultat de toutes les observations possibles sur tous les médicaments possibles $x\in\Xcal$, sur toutes les expériences $n=1, \ldots, N$.
- Échantillonnage simultané – Ici, nous laissons $\omega$ être une réalisation échantillonnée à la fois de $\mu_x$ et des observations $W^1, \ldots, W^N$.
Si nous utilisons l’échantillonnage imbriqué, supposons que nous générions $K$ échantillons des valeurs réelles $\mu(\psi_k)$, et $L$ échantillons des erreurs $\varepsilon^1(\omega_\ell), \ldots, \varepsilon^N(\omega_\ell)$. Pour la vérité échantillonnée $\mu(\psi_k)$ et le bruit $\varepsilon^n(\omega_\ell)$, la performance du médicament $x^n$ lors de la $n+1$ème expérience serait
\[W^{n+1}_{x^n}(\psi_k,\omega_\ell) = \mu(\psi_k) + \varepsilon^n(\omega_\ell).\]Nous pouvons alors calculer une estimation simulée de la performance attendue d’une politique en utilisant
\[\Fbar^\pi(S_0) = \frac{1}{K} \sum_{k=1}^K \left(\frac{1}{L}\sum_{\ell=1}^L \sum_{n=0}^{N-1} W^{n+1}_{x^n}(\psi_k,\omega_\ell)\right),\]où $x^n = X^\pi(S^n)$ et
\[S^{n+1}(\psi_k,\omega_\ell) = S^M(S^n(\psi_k,\omega_\ell), X^\pi(S^n(\psi_k,\omega_\ell)), W^{n+1}(\psi_k,\omega_\ell)).\]Si nous utilisons l’échantillonnage simultané, alors un échantillon $\omega$ détermine à la fois la vérité $\mu(\omega)$ et le bruit $\varepsilon(\omega)$, ce qui nous permet d’écrire une estimation échantillonnée de notre observation $W^{n+1}_{x^n}$ comme
\[W^{n+1}_{x^n}(\omega_\ell) = \mu(\omega_\ell) + \varepsilon^n(\omega_\ell).\]La valeur estimée d’une politique est donnée par
\[\Fbar^\pi(S_0) = \frac{1}{L}\sum_{\ell=1}^L \sum_{n=0}^{N-1} W^{n+1}_{x^n}(\omega_\ell).\]Si nous utilisons l’une de nos politiques paramétrées où $\theta$ est le paramètre ajustable, nous pourrions écrire la performance attendue comme $\Fbar^\pi(\theta\vert S_0)$. Alors, le problème d’optimisation serait
\[\begin{align} \max_\theta \Fbar^\pi(\theta\vert S_0), \label{eq:diabetestuningpolicy} \end{align}\]que nous pouvons résoudre en utilisant diverses procédures de recherche telles que les méthodes présentées dans ce chapitre ou au Chapitre 3. Nous passons en revue les méthodes de recherche plus en détail au Chapitre 7.
Extensions
Nous avons décrit un problème qui s’applique à un seul patient. Cela signifie que nous devrions résoudre ce problème à partir de zéro pour chaque patient. Si nous avons un million de patients diabétiques, nous aurions alors un million de modèles.
Imaginons que nous souhaitions utiliser l’information provenant de différents patients pour apprendre un seul modèle. Nous pouvons le faire en caractérisant chaque patient à l’aide d’un ensemble d’attributs $a = (a_1, \ldots, a_K)$. Supposons pour l’instant que chaque élément $a_k$ soit discret (par exemple, le genre) ou discrétisé (par exemple, l’âge, divisé en tranches). En fait, nous allons commencer par supposer qu’il existe un seul attribut, le genre. Soit $G^n$ le genre du $n$ème patient. Nous avons maintenant deux formes d’information exogène : le genre $G^n$ du $n$ème patient, et le résultat $W^n$ du traitement du $n$ème patient.
Nous commençons avec un état de connaissance $K^0$ qui est notre vecteur $(\mubar^0, \beta^0)$ introduit plus tôt dans le chapitre. Le premier patient aura le genre $G^1$, ce qui signifie que notre variable d’état (c’est-à-dire tout ce que nous savons) après l’arrivée du premier patient est $S^1 = (K^0,G^1)$. Nous prenons ensuite une décision $x^1$ concernant le traitement du patient 1, après quoi nous observons un résultat $W^1$ décrivant comment le traitement a fonctionné. Nous utilisons cette information pour obtenir un état de connaissance mis à jour $K^1$, après quoi le processus se répète :
\[\begin{align*} &(K^0, G^1, S^1=(K^0,G^1), x^1, W^1, K^{1}, G^2, S^2=(K^1,G^2), \ldots, \\ &\hspace{0.75in} K^{n-1}, G^n, S^n=(K^{n-1},G^n), x^n, W^{n}, K^{n}, G^{n+1}, \ldots) \end{align*}\]Nous nous arrêtons un instant pour noter que notre indexation diffère de celle utilisée dans le modèle de base. Dans notre modèle de base, l’indice $n$ faisait référence aux visites d’un patient. Nous prenons une décision $x^n$ après la $n$ème visite en utilisant ce qui est connu des $n$ premières visites. Nous laissons $W^{n+1}$ être le résultat de ce traitement, en incrémentant $n$ à $n+1$ pour souligner que $x^n$ a été calculé sans connaître $W^{n+1}$.
Avec notre nouveau modèle, cependant, $n$ fait référence à un patient. Il est plus logique de laisser $G^n$ être le genre du $n$ème patient, moment auquel nous prenons une décision pour le $n$ème patient, et de laisser $W^n$ être le résultat du traitement pour le $n$ème patient. Nous n’incrémentons pas $n$ avant de voir le $n+1$ème patient suivant, moment auquel nous voyons le genre du $n+1$ème patient suivant.
Qu’avons-nous appris ?
- Nous avons introduit l’idée d’un problème de décision séquentielle qui est un pur problème d’apprentissage, où la variable d’état ne consiste qu’en variables d’état de croyance.
- Nous avons vu un exemple de problème où l’incertitude portait sur la valeur réelle de la performance d’un choix tel que le médicament contre le diabète.
- Nous avons introduit un exemple de politique d’approximation de fonction de coût qui est une forme de problème d’optimisation paramétré, et illustré cette idée à l’aide de trois types de politiques : le bornage de confiance supérieure (qui est une classe générale de politiques), l’estimation par intervalle, et l’échantillonnage de Thompson.
- Nous notons que chaque politique implique un paramètre ajustable et formulons le problème de réglage comme son propre problème d’optimisation.
- Nous avons montré comment modéliser la présence de variables d’information exogène (telles que le genre du patient) comme un problème de décision séquentielle entièrement séquentiel, connu dans la littérature de l’apprentissage sous le nom de « problème de bandit contextuel » (le contexte étant le genre). Au lieu de trouver le meilleur $x$, nous cherchons maintenant le meilleur $x(G)$ en fonction du genre (nous pourrions étendre cela avec d’autres attributs des patients).
Exercices
Questions de révision
- Quelle est la différence fondamentale, d'un point de vue algorithmique, entre le problème du diabète que nous avons résolu dans ce chapitre et le problème résolu au [Chapitre 3](/sdam/fr/chapter-3/) ?
- Lorsque nous laissons $\mubar^n_x$ être l'estimation de la performance du médicament sur un patient après $n$ essais, que mesure $n$ ? Est-ce le nombre de fois où nous avons essayé le médicament $x$ ?
- Quelle est la variable d'état de ce problème ?
- Ci-dessus, nous avons introduit une politique de bornage de confiance supérieure, une politique d'estimation par intervalle, et une politique basée sur l'échantillonnage de Thompson. Quelles caractéristiques ces politiques avaient-elles en commun ?
- Notre fonction objectif optimisait-elle la récompense cumulée ou la récompense finale ? Pourquoi avons-nous utilisé cette version ? Qu'est-ce qui change si nous passons à l'autre fonction objectif en termes de recherche d'une bonne politique ?
Questions de résolution de problèmes
- Vous essayez de déterminer le dosage d'un médicament contre le diabète qui produit la plus grande réduction de la glycémie. Vous expérimentez actuellement avec trois dosages que nous désignons par $d_1$, $d_2$ et $d_3$. Soit $\mu_i$ la réduction réelle de la glycémie produite par le dosage $i$. Après $n$ expériences de différents médicaments, soit $\mubar^n_i$ l'estimation de la réduction produite par le dosage $d_i$. Nous souhaitons exploiter l'observation que nos croyances sur $\mu_i$ sont corrélées. Soit $\sigma_{ii'} = Cov(\mu_i, \mu_{i'})$ la covariance dans notre croyance sur $\mu_i$ et $\mu_{i'}$.
Supposons qu'après $n$ tests de différents dosages, nous obtenons le vecteur actuel d'estimations
$$
\mubar^{n} = \begin{bmatrix} 32 \\ 42 \\ 20 \end{bmatrix}.
$$
Supposons que la variance d'une seule expérience soit $16$ et que notre matrice de covariance $\Sigma^n$ soit donnée par
$$
\Sigma^n = \begin{bmatrix} 8 & 4 & 2 \\ 4 & 8 & 4 \\ 2 & 4 & 8 \end{bmatrix}.
$$
- Écrivez les équations permettant de trouver les estimations mises à jour $\mubar^{n+1}$ et la matrice de covariance $\Sigma^{n+1}$ étant donné une observation $W^{n+1}$.
- Supposons que nous essayions le dosage $d_2$ et obtenions une observation $W^{n+1} = 50$. Calculez les estimations mises à jour $\mubar^{n+1}$ et la matrice de covariance $\Sigma^{n+1}$.
- Montrez comment adapter la politique présentée précédemment à notre problème où le genre est le seul attribut du patient en utilisant une représentation par table de correspondance (lookup table), ce qui signifie qu'au lieu d'apprendre $\mubar^n_x$, nous apprenons $\mubar^n_{a,x}$ où $a=$ genre. Ainsi, au lieu d'apprendre une estimation $\mubar^n_x$ pour chaque traitement $x$, nous devons apprendre une estimation $\mubar^n_{a,x}$ pour chaque combinaison de genre $a = G^n$ et de traitement $x=x^n$.
- Esquissez une stratégie pour appliquer les idées de ce chapitre au problème de planification de marché du [Chapitre 3](/sdam/fr/chapter-3/).
- Est-il possible d'appliquer les méthodes du [Chapitre 3](/sdam/fr/chapter-3/) au problème du diabète ? Expliquez.
- Maintenant, imaginez qu'au lieu du seul genre, nous capturions l'âge par décennie $(0$–$9, 10$–$19, \ldots, 80^+)$, fumeur ou non, et l'origine ethnique (supposons huit catégories d'origine ethnique), ce qui nous donne un vecteur d'attributs $a = (a_{gender}, a_{age}, a_{smoker}, a_{race})$. Si $a\in\Acal$, combien d'éléments $\Acal$ possède-t-il ? Comment cela impacterait-il votre solution proposée dans l'exercice 7 ?
- Imaginez que chaque élément $a_k$ du vecteur d'attributs $a$ ait $L$ valeurs possibles, et que $a$ ait $K$ éléments, ce qui signifie que $\Acal$ a $L^K$ éléments. Si $L = 10$, quelle est la plus grande valeur de $K$ pour que l'apprentissage de notre modèle basé sur les attributs soit plus facile que l'apprentissage d'un modèle pour chacun des 7 millions de patients diabétiques.
- Maintenant, imaginez que notre espace d'attributs $\Acal$ soit tout simplement trop grand pour être pratique. Ce que nous avons fait jusqu'à présent est une représentation par table de correspondance où nous trouvons une estimation $\mubar^n_{a,x}$, ce qui devient problématique lorsque le nombre de valeurs possibles de $a$ devient important. Une approche alternative consiste à utiliser un modèle paramétrique. Le plus simple serait un modèle linéaire où nous écririons
$$
\mubar_{a,x} = \sum_{f\in\Fcal} \theta_f \phi_f(a,x),
$$
où $\phi_f(a,x)$ pour $f\in\Fcal$ est un ensemble de caractéristiques que nous (en tant qu'analystes) devrions définir. Par exemple, une caractéristique pourrait simplement être un indicateur de genre, de tranche d'âge ou de race. Dans ce cas, il y aurait une caractéristique pour chaque genre possible, chaque tranche d'âge possible, et ainsi de suite.
- S'il y a $L$ valeurs possibles pour chacun des $K$ attributs, quel est le nombre minimum de caractéristiques dont nous aurions besoin ?
- Proposez des caractéristiques plus complexes que celles indiquant simplement la valeur de chaque attribut.
- Comparez les forces et les faiblesses d'une représentation par table de correspondance par rapport à notre modèle linéaire.
- Nous allons évaluer différentes politiques pour trouver le meilleur médicament permettant de réduire la glycémie. Nous supposons que notre distribution a priori de croyance pour chaque médicament est donnée dans le Tableau 4.1.
Nous commençons avec une politique d'apprentissage connue sous le nom d'estimation par intervalle donnée par
$$
X^{IE}(S^n\vert \theta^{IE}) = \argmax_{x\in\Xcal} (\mubar^n_x + \theta^{IE} \sigmabar^n_x).
$$
Nous utilisons un modèle de croyance bayésien où il est pratique d'utiliser le concept de *précision*, qui est simplement l'inverse de la variance. Ainsi, la précision de notre estimation initiale de la valeur vraie $\mu_x$ est donnée par
$$
\beta^0_x = \frac{1}{(\sigma^0_x)^2},
$$
où $\sigma^0_x$ est donné dans le Tableau 4.1.
Après $n$ expériences, nous allons utiliser notre politique pour prendre une décision $x^n$ qui est le médicament à essayer pour la $n+1$ème expérience. Nous ne connaissons pas la performance réelle $\mu_x$ du médicament $x$, mais nous pouvons l'observer à l'aide d'une observation bruitée de la valeur vraie $\mu_x$ que nous écrivons en utilisant
$$
W^{n+1}_x = \mu_x + \varepsilon^{n+1}_x.
$$
Supposons que l'écart-type d'une seule expérience soit $\sigma^W = 5$. Nous utilisons l'observation de $W^{n+1}_x$ pour mettre à jour nos croyances en utilisant :
- Si nous essayons le médicament $x$ : $$ \mubar^{n+1}_x = \frac{\beta^n_x \mubar^n_x + \beta^W W^{n+1}_x}{\beta^n_x + \beta^W}, \qquad \beta^{n+1}_x = \beta^n_x + \beta^W. $$
- Si $x$ est un médicament que nous n'essayons pas, alors : $$ \mubar^{n+1}_x = \mubar^n_x, \qquad \beta^{n+1}_x = \beta^n_x. $$
- En utilisant un modèle de croyance bayésien, quelle est la variable d'état ?
- Quelle est la fonction de transition pour le modèle de croyance ?
- Écrivez l'espérance d'une politique $X^\pi(S^n)$ en utilisant l'opérateur d'espérance $\E$. Veillez à indexer l'opérateur pour indiquer quelles variables aléatoires sont impliquées, comme dans $\E_\mu$ ou $\E_W$ (ou $\E_{W_1,\ldots,M}$). Vous pouvez montrer le conditionnement en utilisant $\E_{W\vert \mu}$ (il s'agit de l'espérance sur la réduction observée $W$ étant donné que nous connaissons la moyenne vraie $\mu$).
- Nous pourrions raisonnablement penser que le paramètre $\theta^{IE}$ devrait dépendre du nombre d'expériences restantes dans notre budget, ce qui signifie que $\theta^{IE}$ doit être une fonction de $n$ (ou de manière équivalente, ce serait une fonction des expériences restantes $N-n$). Il existe deux façons de représenter cette fonction. Discutez (sans aucune programmation) des forces de chaque approche, ainsi que des défis computationnels qui en découleraient.
- Table de correspondance – Au lieu de rechercher sur un scalaire $\theta^{IE}$, nous devrions rechercher sur un vecteur $\theta^{IE}_n$.
- Paramétrique – Nous pourrions supposer une forme fonctionnelle telle que $\theta^{IE} = \theta^{slope}(N-n)$, où maintenant nous devons seulement ajuster le scalaire $\theta^{slope}$.
- Nous avons abordé ce problème comme si nous le résolvions pour chaque patient. Imaginez que nous ayons $I$ patients indexés par $i = 1, \ldots, I$, en nous rappelant que $I$ pourrait être 10 millions de patients. Trouver un vecteur d'estimations $\mubar = (\mubar_x)_{x\in\Xcal}$ pour chaque patient s'écrirait $\mubar = (\mubar_{i})_{i=1}^I$ où chaque $\mubar_i = (\mubar_{ix})_{x\in\Xcal}$. Créer 10 millions d'estimations semble un peu maladroit.
Imaginez plutôt que chaque patient possède un vecteur d'attributs $a = (a_1,\ldots, a_M)$ où $a \in \Acal$. Il pourrait y avoir de nombreux attributs, dans ce cas l'ensemble $\Acal$ serait assez grand, mais nous pourrions choisir un petit sous-ensemble pour que $\Acal$ ne soit pas aussi grand, comme le genre et le fait de fumer ou non. Nous pouvons à nouveau utiliser deux représentations différentes de $\mubar_{ax}$. Comme précédemment, discutez des forces et des défis computationnels de chacune des façons suivantes de modéliser $\mubar_{ax}$ :
- Table de correspondance – Nous énumérerions chacun des attributs $a \in \Acal$, et créerions une estimation $\mubar_{ax}$ de la performance de chaque médicament $x$ et pour chaque attribut $a$. Cela pourrait constituer un ensemble important, mais qui devrait être plus petit que 10 millions.
- Paramétrique – Cela nécessite de trouver une forme paramétrique pour $\mubar_{ax}$ pour chaque médicament $x$. Une possibilité serait $$ \mubar_{ax} = \sum_{f\in\Fcal} \thetabar_{fx} \phi_f(a). $$ Les fonctions $\phi_f(a)$ sont parfois appelées fonctions de base (d'autres termes sont variables indépendantes ou covariables). Il pourrait s'agir de variables indicatrices qui capturent, par exemple, le genre du patient ou le fait qu'il soit fumeur ou non. Cette représentation remplace le calcul de $\mubar_{ax}$ pour chaque attribut $a$ par le calcul d'un vecteur de coefficients $\mubar_{ax}$ pour un ensemble de caractéristiques. L'ensemble $\Fcal$ est vraisemblablement beaucoup plus petit que l'ensemble des attributs (si ce n'est pas le cas, nous devrions utiliser la représentation par table de correspondance).
Questions de programmation
Ces exercices utilisent le module Python AdaptiveMarketPlanning disponible sur tinyurl.com/sdagithub.
- Effectuez $L = 1000$ simulations de la politique d'estimation par intervalle sur un budget de $N = 20$ expériences en utilisant $\theta^{IE} = 1$. Soit $\Fhat^{IE}$ la performance de la politique IE pour un chemin d'échantillonnage particulier. Faites l'hypothèse que la performance réelle d'un médicament, $\mu_x$, est donnée dans le Tableau 4.2, et utilisez les hypothèses concernant l'écart-type de chaque croyance issues du Tableau 4.1. Utilisez également l'écart-type $\sigma^W = 5$ pour la variation expérimentale comme nous l'avons fait dans l'exercice 13.
- Calculez la moyenne et l'écart-type de la valeur de la politique $\Fbar^{IE}(\theta^{IE})$ avec $\theta^{IE}=1$.
- Évaluez la politique IE pour $\theta^{IE} = (0, 0.2, 0.4, \ldots, 2.0)$ et tracez $\Fbar^{IE}(\theta)$. Qu'apprenez-vous de ce graphique ?
- Évaluez la politique IE pour un budget $N = 20$ sur les valeurs $\theta^{IE} = (0, 0.2, 0.4, \ldots, 2.0)$ pour deux ensembles différents de valeurs vraies :
- Supposez d'abord que l'a priori est $\mu^0_x = 0.3$ pour tous les médicaments $x$ et où l'écart-type initial $\sigma^0_x = 0.10$. Cela signifie que nous supposons que la valeur vraie $\mu_x \sim N(\mubar^0_x,(\sigmabar^0_x)^2)$. Cependant, nous allons échantillonner notre valeur vraie en utilisant $$ \muhat_x = .3 + \varepsilon $$ où $\varepsilon$ est distribué uniformément dans l'intervalle $[-0.15,+0.15]$. Il s'agit d'un exemple où l'on dispose d'une distribution a priori de croyance (dans ce cas, distribuée normalement autour de 0,3) mais où l'on échantillonne la valeur vraie à partir d'une distribution différente (distribuée uniformément autour de la moyenne 0,3). Effectuez 10 000 répétitions de chaque valeur de $\theta^{IE}$ pour calculer la performance moyenne. Quelles conclusions pouvez-vous tirer du graphique résultant pour les 11 valeurs de $\theta^{IE}$ ?
- Pour cet exercice, nous allons simuler notre valeur vraie à partir de l'a priori en utilisant $$ \mu_x = \mubar^0_x + \varepsilon $$ où $\mubar^0$ est donné dans le Tableau 4.2 (« Réduction de l'A1c ») et où $\varepsilon$ est distribué uniformément dans l'intervalle $[-.5\mubar^0_x, +.5\mubar^0_x]$. Effectuez 10 000 répétitions de chaque valeur de $\theta^{IE}$ pour calculer la performance moyenne. Quelles conclusions pouvez-vous tirer du graphique ?
| Médicament | Réduction de l'A1c | Valeur vraie |
|---|---|---|
| Metformine | 0.32 | 0.25 |
| Sensibilisateurs | 0.28 | 0.30 |
| Sécrétagogues | 0.30 | 0.28 |
| Inhibiteurs de l'alpha-glucosidase | 0.26 | 0.34 |
| Analogues peptidiques | 0.21 | 0.24 |
Tableau 4.2. Valeurs vraies pour un patient particulier.