Kapitel 1: Modellierung sequentieller Entscheidungsprobleme
Der Prozess der Lösung eines beliebigen physischen Problems (und insbesondere eines beliebigen sequentiellen Entscheidungsproblems) auf dem Computer erfordert den Aufbau eines mathematischen Modells, wie in Abbildung 1.1 dargestellt. Seit Jahrzehnten verwendet die Forschungsgemeinschaft einen Standardrahmen für Entscheidungsprobleme, bei denen alle Daten im Voraus bekannt sind (bekannt als deterministische Optimierung). Eine einfache Version eines deterministischen Optimierungsproblems, bekannt als lineares Programm, könnte geschrieben werden als
\[\begin{align} \min_x c^T x, \label{eq:linearprogram1} \end{align}\]wobei $x$ ein Vektor von Elementen ist, die eine Reihe von Nebenbedingungen erfüllen müssen, welche typischerweise geschrieben werden als
\[\begin{align} A x & = b, \label{eq:linearprogram2}\\ x & \geq 0. \label{eq:linearprogram3} \end{align}\]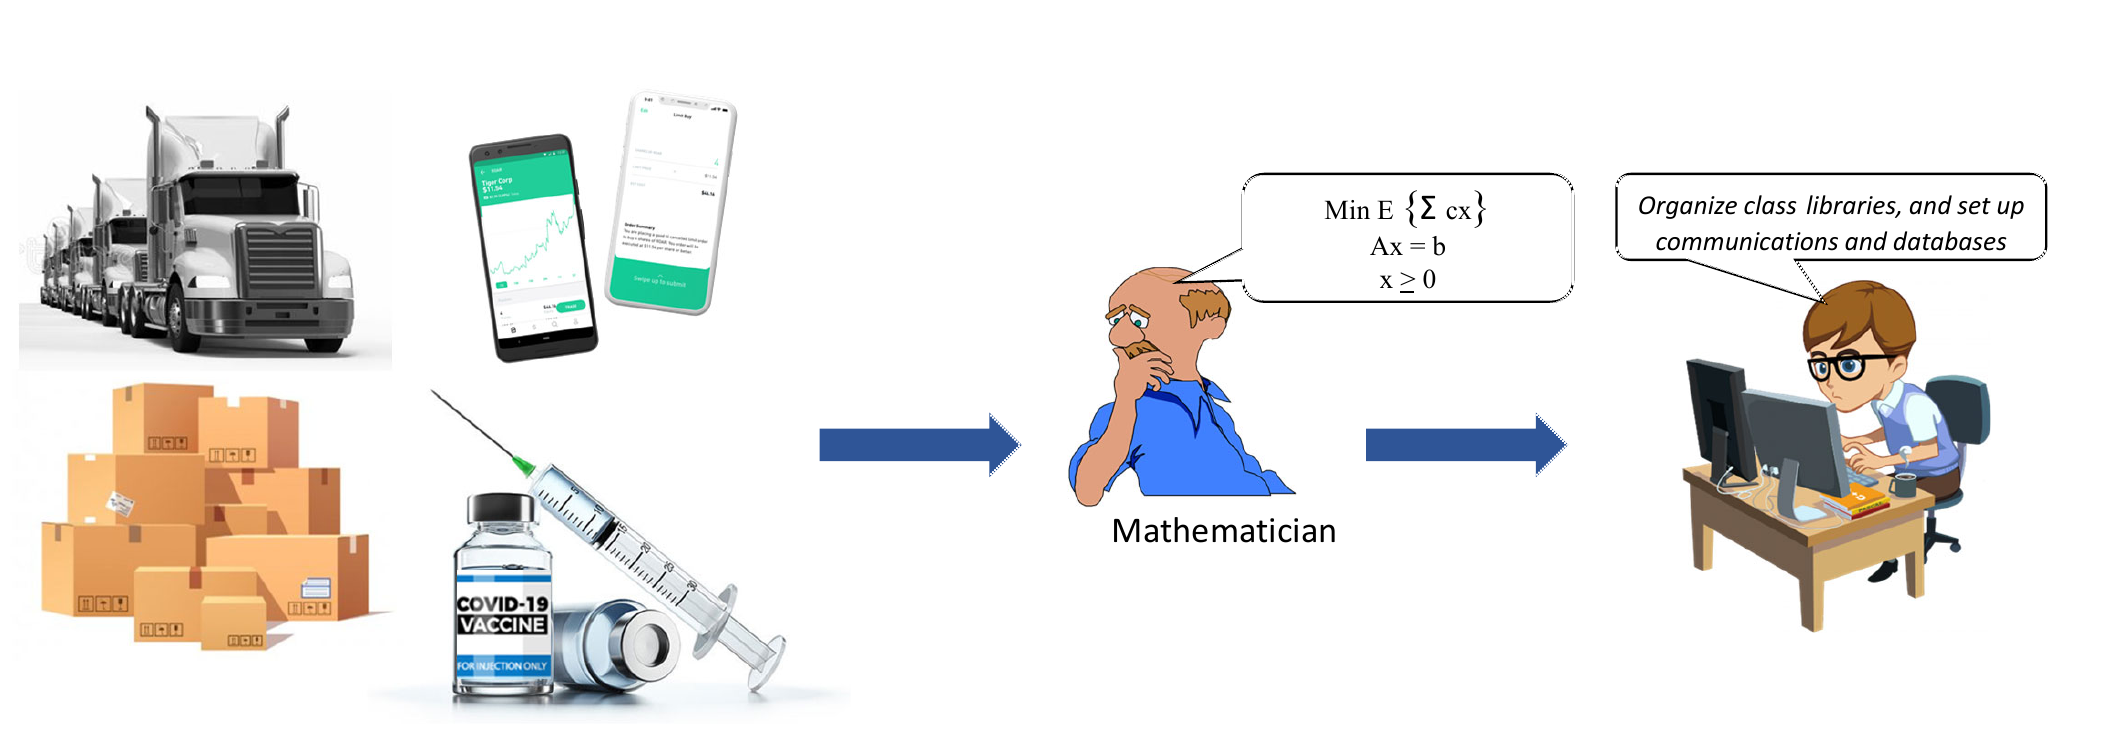
Es ist nicht notwendig, die Gleichungen $\eqref{eq:linearprogram1}$–$\eqref{eq:linearprogram3}$ zu verstehen (was grundlegende Kenntnisse der linearen Algebra erfordert), aber jedes Jahr schließen Tausende von Studierenden Kurse ab, in denen sie diese Notation lernen und außerdem lernen, wie man eine Vielzahl physischer Probleme in diese Notation übersetzt. Anschließend gibt es Softwarepakete, die Probleme in diesem Format in eine Lösung übersetzen. Am wichtigsten ist, dass diese Notationssprache weltweit gesprochen wird. Dieselbe Aussage lässt sich über statistische Modellierung/maschinelles Lernen treffen, was heute eine wesentlich größere Gemeinschaft darstellt als die Menschen, die die Gleichungen $\eqref{eq:linearprogram1}$–$\eqref{eq:linearprogram3}$ verstehen.
Dieselbe Aussage können wir nicht über sequentielle Entscheidungsprobleme treffen, eine Problemklasse, die von mindestens 15 verschiedenen Gemeinschaften unter Verwendung von acht grundlegend unterschiedlichen Notationsstilen untersucht wird, wobei häufig Mathematik verwendet wird, die eine fortgeschrittene Ausbildung erfordert. In diesem Buch verwenden wir einen anhand von Beispielen lehrenden Stil, um zu zeigen, wie man die unglaublich reichhaltige Klasse von Problemen modelliert, die wir sequentielle Entscheidungsprobleme nennen. Obwohl wir uns auf relativ einfachere Probleme konzentrieren, kann unser Rahmen verwendet werden, um jedes sequentielle Entscheidungsproblem zu modellieren. Darüber hinaus kann das resultierende Modell direkt in Software übersetzt werden.
Die analytische Grundlage dieses Buches ist in Reinforcement Learning and Stochastic Optimization: A unified framework for sequential decisions (RLSO) enthalten, einem Lehrbuch auf Graduiertenniveau, das sich auf Methodik konzentriert. Gelegentlich werden wir auf Material in diesem Buch verweisen, für Leser, die an größerer Tiefe interessiert sein könnten, und wir ermutigen technisch interessierte Leser, RLSO als Referenz zu nutzen. Es wird jedoch nicht benötigt. Dieses Buch ist darauf ausgelegt, den kontextuellen Hintergrund in Form einer Reihe von Beispielen zu liefern, die es den Lesern ermöglichen sollten, klar und präzise über sequentielle Entscheidungsprobleme nachzudenken, selbst wenn sie nie eine Zeile Code schreiben werden.
Dieses Buch richtet sich an Studierende auf Bachelor- oder Masterniveau, die einen Kurs in Wahrscheinlichkeitsrechnung und Statistik belegt haben (Kenntnisse in linearer Programmierung sind nicht erforderlich, obwohl wir ein Beispiel haben, das die Lösung eines linearen Programms erfordert). Alle Kapitel sind um spezifische Beispiele herum aufgebaut, mit Ausnahme von Kapitel 1, das einen Überblick über den gesamten Modellierungsrahmen bietet, und Kapitel 7, in dem wir innehalten und die ersten sechs Kapitel nutzen, um einige wichtige Prinzipien zu veranschaulichen.
Die Darstellung sollte keine Mathematik erfordern, die über das hinausgeht, was in einem ersten Kurs zur Wahrscheinlichkeitsrechnung und Statistik zu erwarten wäre. Dennoch konzentriert sich das Buch darauf, zu zeigen, wie man sequentielle Entscheidungsprobleme mithilfe einer Notation beschreibt, die präzise genug ist, um als Grundlage für Computersoftware zu dienen.
Python-Module begleiten die meisten Kapitel; diese Module wurden um den Modellierungsrahmen herum geschrieben, der sich durch das gesamte Buch zieht. Gleichzeitig kann jedes Softwarepaket, das ein sequentielles Entscheidungsproblem simuliert, unabhängig davon, wie es gelöst wird, direkt in den Modellierungsrahmen übersetzt werden, den wir verwenden. Aus diesem Grund ermutigen wir die Leser, jedes Stück Notation als Variable in einem Computerprogramm zu betrachten.
Erste Schritte
Sequentielle Entscheidungsprobleme können immer geschrieben werden als
\[decision,\ information, \ decision, \ information, \ decision, \ldots\]Jedes Mal, wenn wir eine Entscheidung treffen, entstehen uns Kosten oder wir erhalten einen Beitrag oder eine Belohnung (es gibt viele Möglichkeiten, die Leistung zu messen). Entscheidungen werden mit einer Methode getroffen, die wir als Politik bezeichnen werden. Ein zentrales Ziel, das im Mittelpunkt dieses Buches steht, ist die Gestaltung effektiver Politiken, die im Laufe der Zeit gut funktionieren, angesichts der Unsicherheit von Informationen, die noch nicht eingetroffen sind.
Sequentielle Entscheidungsprobleme sind allgegenwärtig und treten praktisch in jedem menschlichen Prozess auf. Tabelle 1.1 bietet eine Beispielliste von Feldern mit Beispielen für einige der Entscheidungen, die auftreten könnten. Die meisten dieser Felder haben wahrscheinlich viele verschiedene Arten von Entscheidungen, deren Komplexität von der Frage, wann ein Vermögenswert verkauft oder ein neues Webdesign übernommen werden soll, über die Auswahl des besten Medikaments, Materials oder Standorts für ein Design bis hin zur Verwaltung komplexer Lieferketten oder dem Einsatz einer Flotte von Lastwagen reicht.
| Feld | Fragen |
|---|---|
| Wirtschaft | Welche Produkte sollten wir mit welchen Merkmalen verkaufen? Welche Lieferanten sollten Sie nutzen? Welchen Preis sollten Sie verlangen? |
| Volkswirtschaft | Welchen Zinssatz sollte die US-Notenbank angesichts des Zustands der Wirtschaft festlegen? Welches Maß an Marktliquidität sollte bereitgestellt werden? |
| Finanzwesen | In welche Aktien sollte ein Portfolio investieren? Wie sollte ein Händler einen Vertrag gegen potenzielle Verluste absichern? |
| Internet | Welche Anzeigen sollten wir schalten, um Klicks zu maximieren? Welche Filme ziehen die meiste Aufmerksamkeit auf sich? Wann/wie sollten Massenmitteilungen versendet werden? |
| Ingenieurwesen | Wie entwirft man Geräte von Aerosoldosen bis Elektrofahrzeugen, Brücken bis Verkehrssystemen, Transistoren bis Computern? |
| Öffentliche Gesundheit | Wie sollten wir Tests durchführen, um den Verlauf einer Krankheit abzuschätzen? Wie sollten Impfstoffe zugeteilt werden? Welche Bevölkerungsgruppen sollten anvisiert werden? |
| Medizinische Forschung | Welche molekulare Konfiguration wird das Medikament hervorbringen, das die meisten Krebszellen abtötet? Welche Schritte sind erforderlich, um einwandige Nanoröhren herzustellen? |
| Lieferkettenmanagement | Wann sollten wir eine Bestandsbestellung aus China aufgeben? Welcher Lieferant sollte genutzt werden? |
| Gütertransport | Welcher Fahrer sollte eine Ladung transportieren? Zu welchen Ladungen sollte sich ein Komplettladungs-Frachtführer verpflichten? Wo sollten Fahrer stationiert werden? |
| Informationssammlung | Wohin sollten wir eine Drohne schicken, um Informationen über Waldbrände oder invasive Arten zu sammeln? Welches Medikament sollten wir testen, um eine Krankheit zu bekämpfen? |
| Multiagentensysteme | Wie sollte ein großes Unternehmen in einem oligopolistischen Markt Angebote für Verträge abgeben, in Erwartung der Reaktion seiner Wettbewerber? |
| Algorithmen | Welche Schrittweitenregel sollten wir in einem Suchalgorithmus verwenden? Wie bestimmen wir den nächsten Punkt zur Auswertung einer teuren Funktion? |
Tabelle 1.1. Eine Auswahl verschiedener Felder und Entscheidungen, die innerhalb jedes Feldes getroffen werden müssen.
Noch schwieriger als die Auflistung aller Arten von Entscheidungen ist die Identifizierung der verschiedenen Quellen der Unsicherheit, die in vielen Anwendungen auftreten. Menschliches Verhalten, Märkte, physische Prozesse, Verkehrsnetze, Energiesysteme und die breite Palette an Unsicherheiten, die im Gesundheitsbereich auftreten, deuten auf die Vielfalt der unterschiedlichen Quellen der Unsicherheit hin.
Während dieses Buch geschrieben wird, kämpft die Menschheit mit der Ausbreitung von Varianten von COVID-19. Der Umgang mit dieser Pandemie wurde als „unglaublich komplex“ beschrieben [USA Today, Sept 8, 2020], aber dies ist eigentlich ein Nebenprodukt eines Versäumnisses, das Problem strukturiert zu durchdenken. Wir werden dem Leser zeigen, wie man Probleme in eine Reihe grundlegender Komponenten zerlegt, die zu praktischen Lösungen führen.
Unser Ansatz beginnt mit der Identifizierung einiger Kernelemente wie Leistungskennzahlen, Entscheidungen und Unsicherheitsquellen, was dann zur Erstellung eines mathematischen Modells des Problems führt. Der nächste Schritt besteht in der Regel (aber nicht immer) darin, das Modell auf dem Computer zu implementieren, aber es wird viele Probleme geben, bei denen der Prozess der Erstellung eines Computermodells aus verschiedenen Gründen unpraktisch ist. Aus diesem Grund werden wir auch Probleme betrachten, bei denen wir Ideen im Feld testen und bewerten müssen. Um die Leistung zu verbessern, müssen wir zunächst lernen, im Laufe der Zeit gute Entscheidungen zu treffen (so steuern wir das System). Dann wenden wir uns dem Design des Systems zu.
Zum jetzigen Zeitpunkt hat die akademische Gemeinschaft keinen Standardmodellierungsprozess für sequentielle Entscheidungsprobleme übernommen. Dies steht in scharfem Kontrast zum Bereich der statischen, deterministischen Optimierungsprobleme, die seit den 1950er Jahren einem strikten Rahmen folgen (die Gleichungen $\eqref{eq:linearprogram1}$–$\eqref{eq:linearprogram3}$ stellen ein Beispiel für diesen Rahmen dar). Unser Modellierungsprozess basiert auf der Darstellung in RLSO, einem Buch, das sich an ein technisches Publikum richtet, das in erster Linie daran interessiert ist, Modelle auf dem Computer zu entwickeln und zu implementieren.
Im Gegensatz dazu richtet sich dieses Buch an ein breiteres Publikum, das vor allem daran interessiert ist zu lernen, wie man über sequentielle Entscheidungsprobleme nachdenkt. Es verwendet einen anhand von Beispielen lehrenden Stil, der sich darauf konzentriert, den Modellierungsprozess zu vermitteln, den wir für nützlich halten, auch ohne letztendlich Computermodelle zu erstellen. Zentral für unseren Ansatz ist die Erstellung eines mathematischen Modells, das die Mehrdeutigkeit beseitigt, die bei der Beschreibung von Problemen in gewöhnlichem Englisch entsteht. Für Leser, die daran interessiert sind, Computermodelle zu entwickeln, ist die Notation das Sprungbrett zum Schreiben von Software. Wir werden jedoch mathematische Notation vor allem verwenden, um Klarheit bei der Beschreibung eines Problems zu schaffen, selbst wenn der Leser nie beabsichtigt, eine Zeile Code zu schreiben.
Unsere Darstellung verläuft wie folgt:
- Kapitel 1 bietet eine leichte Einführung in den universellen Modellierungsrahmen, veranschaulicht anhand zweier Bestandsprobleme (eines einfachen und eines etwas komplexeren), gefolgt von einer kurzen Diskussion der Modellierung von Unsicherheit. Anschließend wird eine Einführung in die vier Klassen von Politiken gegeben, die jede Methode zur Entscheidungsfindung abdecken.
- Die Kapitel 2–6 beschreiben jeweils ein spezifisches sequentielles Entscheidungsproblem, um den Modellierungsrahmen in einem anhand von Beispielen lehrenden Stil zu veranschaulichen. Diese Anwendungen wurden ausgewählt, um jede der vier Klassen von Politiken hervorzuheben.
- Kapitel 7 kehrt ausführlicher zum universellen Modellierungsrahmen zurück. Es wird eine wesentlich sorgfältigere Diskussion der vier Klassen von Politiken sowie verschiedener Arten von Zustandsvariablen gegeben, wobei die Beispiele aus den Kapiteln 2–6 als Kontext dienen.
- Die Kapitel 8–14 bieten zusätzliche Beispiele, die komplexere Rahmenbedingungen nutzen, um fortgeschrittenere Modellierungskonzepte zu veranschaulichen, wobei sowohl die Modellierung von Unsicherheit (insbesondere die Modellierung von Strompreisen in Kapitel 8) als auch ein reichhaltigerer Satz von Politiken behandelt werden.
Die Anwendungskapitel (2–6 und 8–14) folgen alle demselben Aufbau. Sie können in beliebiger Reihenfolge behandelt werden, wobei zu beachten ist, dass die Anwendungen in den Kapiteln 2–6 einfacher sind und ausgewählt wurden, um jede der vier Klassen von Politiken zu veranschaulichen. Leser, die an spezifischen Modellierungsthemen interessiert sind (wie Zustandsvariablen, Modellierung von Unsicherheit oder verschiedene Beispiele von Politiken), können Kapitel überfliegen und direkt zu den Themen springen, die sie interessieren.
Jedes Kapitel schließt mit einer Reihe von Übungen, die in drei Kategorien unterteilt sind:
- Wiederholungsfragen – Dies sind einfache Fragen, die genutzt werden können, um das grundlegende Verständnis aus der Lektüre des Kapitels zu festigen.
- Problemlösungsfragen – Diese führen Modellierungsherausforderungen ein, die Problemlösungsfähigkeiten erfordern.
- Programmieraufgaben – Die meisten Kapitel enthalten Programmierübungen, die auf einer Reihe von Python-Modulen aufbauen. Die ursprünglichen Python-Module, geschrieben in Python 2, profitierten von einem umfassenden Upgrade durch Professor Dennis Djanka, einen Professor an der Universität Karlsruhe in Deutschland. Die neue Bibliothek kann unter tinyurl.com/sdagithub heruntergeladen werden. Einige dieser Fragen erfordern die Vornahme von Programmieränderungen am Python-Code.
Was also ist eine Entscheidung?
Es gibt eine lange Geschichte, die über 2.000 Jahre zurückreicht bis in die Zeit von Sokrates, Aristoteles und Platon, die dokumentiert, wie Menschen Entscheidungen treffen. Dann gibt es eine umfangreiche Literatur, meist seit den 1950er Jahren (aber mit einigen wichtigen Arbeiten davor), zur Mathematik des optimalen Entscheidens, bestehend aus vielen Tausend Aufsätzen und Büchern. Was diese Literatur zu übersehen scheint, ist die grundlegende Frage:
Was ist eine Entscheidung?
Wir beginnen mit der Beobachtung, dass eine Entscheidung eine Form von Information ist, die das Verhalten eines “Systems” beeinflusst, das wir steuern wollen. Diesem System liegen implizit ein oder mehrere Maße zugrunde, die quantifizieren, wie gut unser System funktioniert. Wir müssen dann einen Agenten identifizieren, der einen bestimmten Aspekt unseres Systems steuert.
Ausgehend von dieser Grundlage ist es hilfreich, drei Klassen von Information zu unterscheiden:
- Der Wissenszustand – Dies ist Information, die wir gerade jetzt besitzen und die für die Leistung unseres Systems relevant ist.
- Information, die den Wissenszustand verändert und die wir kontrollieren (dies erfordert die Identifikation eines steuernden Agenten für unser System).
- Information, die in unserem System eintrifft und den Wissenszustand verändert, ohne dass wir Kontrolle darüber haben.
Wir bezeichnen Information der Klasse 2 als Entscheidungen. Dies legt eine formale Definition einer Entscheidung nahe, in Anlehnung an Bridging Decision Problems, Volume I: Framing the Problem:
Definition (formal): Eine Entscheidung ist eine endogen kontrollierbare Informationsklasse.
Eine informelle Definition könnte lauten:
Definition (informell): Eine Entscheidung ist Information, die wir kontrollieren.
Diese Definitionen bieten einen Ausgangspunkt, aber wir lernen aus ihnen nicht sehr viel. Viel interessanter ist es, konkrete Beispiele für Entscheidungen zu identifizieren, was wir als Nächstes tun.
Arten von Entscheidungen
Wir haben 10 Arten von Entscheidungen identifiziert, basierend auf den Rahmenbedingungen und den Werkzeugen, die wir nutzen könnten, um die beste Entscheidung zu bestimmen. Diese sind:
1) Physische und finanzielle Entscheidungen – Diese Entscheidungen entstehen bei der Verwaltung physischer und finanzieller Ressourcen, wie Menschen, Ausrüstung, Einrichtungen, Produkte, Wasser, Energie sowie finanzieller Ressourcen wie Bargeld oder Investitionen. Zu den Entscheidungen gehören Kauf, Verkauf und Veränderung von Ressourcen, wobei eine Veränderung bedeuten kann, sie von einem Ort zum anderen zu bewegen, Ausrüstung zu reparieren, eine Person zu schulen oder Zutaten zu einem Kuchen zu kombinieren.
2) Komplexe/strategische Entscheidungen – Dies sind Entscheidungen, die möglicherweise mehrere Änderungen an einem System vornehmen (Änderung von Ressourcen, Parametern, Überzeugungen), und die typischerweise bedeutende Quellen von Unsicherheit beinhalten. Diese Entscheidungen werden in der Regel einmal bewertet, aber die Option, zu warten und die Entscheidung später zu treffen, kann bestehen.
3) Informationsbeschaffungs-/Beobachtungsentscheidungen – Dazu gehören Entscheidungen wie das Durchführen von Laborexperimenten, Feldtests oder Computersimulationen. Es könnte die Durchführung von Marktforschung, die Einstellung eines Experten oder das Befragen eines großen Sprachmodells umfassen.
4) Informationskommunikations-/Weitergabeentscheidungen – Diese treten in zwei Formen auf:
- a) Botschaften – Dies spiegelt wider, was wir in Text, Video und/oder Audio sagen.
- b) Kanäle und Timing – Dies umfasst die Wahl, wie die Information gesendet wird: Text/E-Mails, Veröffentlichung (gedruckt oder online), soziale Medien oder Werbekanäle. Es erfordert auch die Wahl des Timings und der Häufigkeit.
5) Leistungskennzahlen und Ziele – Diese stellen die entscheidende Wahl dar, zu quantifizieren, was wir erreichen wollen, wie etwa die Maximierung von Einnahmen, die Minimierung von Kosten, die Minimierung von Krankheit oder die Maximierung der erhaltenen Stimmen.
6) Wahl von Funktionen – Dies können Methoden zum Treffen von Entscheidungen (Politiken), die Formulierung von Optimierungsmodellen, die Wahl von Leistungskennzahlen, Methoden zur Prognose oder Schätzung oder das Design von Übergangsfunktionen (etwa wie sich eine Krankheit ausbreitet) sein.
7) Festlegen von Parametern – Es gibt oft eine Reihe von Parametern, die die Leistung eines Systems beeinflussen. Dies könnten Preise, die Koeffizienten in einem statistischen Modell, die in einem Fertigungsprozess verwendete Temperatur sein. Sie könnten das Gewicht sein, das einer Leistungskennzahl beigemessen wird, oder Leistungsziele.
8) Schätzung oder Identifikation – Wir müssen möglicherweise eine Person identifizieren, die Nachfrage prognostizieren oder eine Krankheit benennen.
9) Merkmale und Verhaltensweisen – Wie ein Produkt zu gestalten ist, welche Merkmale ein Softwarepaket haben sollte, welche Dienstleistungen einem Kunden angeboten werden sollten, oder das Hauptfach eines Studenten, das bestimmt, mit welchen Fähigkeiten er sein Studium abschließt.
10) Entscheiden, was zu entscheiden ist – Während wir für diese letzte Entscheidung im Allgemeinen keine formale Analyse verwenden, ist es wichtig zu erkennen, wann wir eine Entscheidung treffen, und ob wir sie formal mittels Datenanalyse und Modellierung angehen wollen.
Der Identifikation von Entscheidungen liegt implizit das Verständnis zugrunde, wie die Entscheidung die Leistung des Systems beeinflusst. Das Bewegen physischer Ressourcen (Typ 1) ist mit Kosten verbunden, während die Erfüllung von Nachfragen Einnahmen bringt. Eine Entscheidung kann eine unmittelbare Auswirkung auf eine oder mehrere Leistungskennzahlen haben (wie es häufig bei der Verwaltung von Ressourcen vorkommt), aber oft müssen Entscheidungen im Zeitverlauf bewertet werden und hängen von Information ab, die zum Zeitpunkt der Entscheidung nicht bekannt ist. Aus diesem Grund bewerten wir häufig, wie wir Entscheidungen treffen (also die Methode) im Gegensatz zur Entscheidung selbst.
Das Problem einordnen (Framing)
Der erste Schritt bei der Herangehensweise an ein Entscheidungsproblem besteht darin, drei Fragen zu beantworten:
- Was sind die Leistungskennzahlen?
- Welche Arten von Entscheidungen werden getroffen (und wer trifft sie)?
- Was sind die Unsicherheiten, die die Leistung beeinflussen?
Beachten Sie, dass die Antworten auf diese Fragen für jedes Entscheidungsproblem grundlegend sind. In diesem Buch werden diese Fragen recht einfach erscheinen, da wir sie im Kontext der Modelle beantworten, die wir bereits zur Lösung eines Problems entworfen haben. In realen Anwendungen können die Listen der Leistungskennzahlen, Entscheidungen und Unsicherheiten recht lang sein.
Als Andeutung des Reichtums, den das Framing eines Problems annehmen kann, empfehlen wir dem Leser, sich die Monografie Framing the Problem anzusehen, die genau diesem Thema gewidmet ist. Die Monografie hat ganze Kapitel, die jeder dieser Fragen gewidmet sind, welche anhand eines Dutzends verschiedener Anwendungen illustriert werden.
Das Ziel des Framing-Prozesses ist es, herauszufinden, was wichtig ist, beginnend mit den Leistungskennzahlen, wobei sogar ein einfaches Bestandsproblem mit über 20 Leistungskennzahlen, 30 verschiedenen Arten von Entscheidungen und über 30 Arten von Unsicherheiten beschrieben werden kann. Die Tabellenkalkulation, die diese auflistet, findet sich unter tinyurl.com/PowellInventoryDecisions. Dies bedeutet nicht, dass wir tatsächlich ein Modell mit dieser gesamten Komplexität bauen werden. Aus diesem Grund führt das Buch ein Instrument namens Interaktionsmatrizen ein, bei dem ein Fachexperte die Kennzahlen priorisiert und dann mittels Urteilsvermögen die Entscheidungen und Unsicherheiten identifiziert, die den größten Einfluss auf die wichtigsten Kennzahlen haben.
Dieses Buch geht davon aus, dass wir ein Problem bereits auf eine kleine Anzahl von Kennzahlen, Entscheidungen und Unsicherheiten reduziert haben, und nutzt diese, um die Entwicklung eines mathematischen Modells zu fokussieren.
Der Modellierungsprozess
Modellierung ist eine Kunst, aber es ist eine Kunst, die von einem mathematischen Rahmenwerk geleitet wird, das sicherstellt, dass wir ein wohldefiniertes Problem erhalten, das wir auf dem Computer umsetzen und lösen können. Dies kann als der Bau einer Brücke von einem unübersichtlichen, schlecht definierten Problem der realen Welt zu etwas mit der Klarheit betrachtet werden, die ein Computer verstehen kann, selbst wenn Ihr Endziel nicht darin besteht, es auf dem Computer umzusetzen.
Historisch gesehen wandte man sich, wenn eine Modellierungsanstrengung versuchte, Entscheidungen zu treffen, dem bekannten Rahmenwerk der deterministischen Optimierung zu, das oft wie das Modell aussieht, das durch die Gleichungen $\eqref{eq:linearprogram1}$–$\eqref{eq:linearprogram3}$ gegeben ist und aus den Entscheidungsvariablen $x$, einer Zielfunktion $cx$ und den durch $\eqref{eq:linearprogram2}$–$\eqref{eq:linearprogram3}$ gegebenen Nebenbedingungen besteht.
Das Problem mit diesem klassischen Modellierungsrahmenwerk ist, was es außer Acht lässt:
- Es geht davon aus, dass alle Daten (enthalten in den Variablen $A$, $b$ und $c$), die das Modell charakterisieren, perfekt bekannt sind.
- Die meisten Entscheidungen treten wiederholt über die Zeit auf, und dennoch gibt es keine Berücksichtigung dessen.
- Es gibt keine Möglichkeit, den Informationsfluss in das System darzustellen.
- Als Nebenprodukt kann die optimale Lösung dieses Modells keine Ereignisse antizipieren, die die Leistung von $x$ im Feld beeinflussen.
- Es gibt keine Möglichkeit, Risiko darzustellen, ein wichtiges Thema in vielen Anwendungen.
- Es geht von einem einzigen Entscheidungsträger aus.
Mathematische Modelle sollten in erster Linie einen Weg aufzeigen, der uns sagt, wie wir über Probleme nachdenken sollen. Die klassischen deterministischen Optimierungsmodelle, die dem Format der Gleichungen $\eqref{eq:linearprogram1}$–$\eqref{eq:linearprogram3}$ folgen, ignorieren vollständig alles, was mit der Entwicklung unseres Problems über die Zeit zu tun hat.
Dieses Buch ist vollständig um einen Modellierungsansatz herum aufgebaut, der als universelles Modellierungsrahmenwerk bezeichnet wird. Kurz gesagt, strebt es an, jeden Aspekt eines steuerbaren Systems darzustellen. Unser Standardmodell geht davon aus, dass sich das System über die Zeit entwickelt, während neue Information eintrifft.
In diesem Abschnitt werden wir eine sehr kompakte Version des universellen Modellierungsrahmenwerks vorstellen. Dann werden wir das Rahmenwerk illustrieren, zunächst anhand eines sehr einfachen Bestandsproblems, aber dann einige bescheidene Erweiterungen einführen. Nach der Präsentation dieser Beispiele werden wir zu einer detaillierteren Darstellung des universellen Modellierungsrahmenwerks zurückkehren.
Eine kompakte Darstellung eines dynamischen Modells
Wir beginnen mit der Beobachtung, dass wir jedes sequentielle Entscheidungsproblem mit Hilfe der Sequenz modellieren können
\[(S_0,x_0,W_1,S_1,x_1,W_2, \ldots, S_t, x_t, W_{t+1}, \ldots, S_T),\]wobei:
- $S_t$ die Zustandsvariablen sind, die alles erfassen, was wir benötigen, um:
- a) Eine Entscheidung zum Zeitpunkt $t$ zu treffen.
- b) Die Leistungskennzahlen zum Zeitpunkt $t$ zu berechnen.
- c) Jede andere Information zu erfassen, die benötigt wird, um (a) oder (b) zu irgendeinem zukünftigen Zeitpunkt zu berechnen.
Es ist am besten, sich $S_t$ als den Informationszustand oder, allgemeiner, den Wissenszustand zum Zeitpunkt $t$ vorzustellen.
- $x_t$ steht für Entscheidungsvariablen, die die Elemente erfassen, die wir kontrollieren, wie etwa ob ein Haus verkauft werden soll, den Weg durch ein Netzwerk, die Wahl des Medikaments für eine Behandlung, den Preis, zu dem ein Produkt verkauft werden soll, oder die Wahl des Lkw, um eine Frachtladung zu transportieren.
-
$W_{t+1}$ ist die Information, die eintrifft, nachdem wir die Entscheidung $x_t$ getroffen haben, was der endgültige Verkaufspreis eines Hauses, die Reisezeiten durch ein Netzwerk, wie ein Patient auf ein Medikament reagiert, die Verkäufe eines Produkts zu einem Preis, und die Frachtladungen sein könnten, die eingehen, nachdem wir die anfänglichen Zuweisungen vorgenommen haben. Wir betrachten die Information in $W_{t+1}$ als von außerhalb unseres Systems kommend, was bedeutet, dass sie außerhalb unserer Kontrolle liegt. Aus diesem Grund bezeichnen wir sie als exogene Information.
Es gibt viele Situationen, in denen es am besten ist, sich $W_{t+1}$ als eine Funktion $W_{t+1}(S_t,x_t)$ vorzustellen, die vom aktuellen Zustand $S_t$ und/oder der Entscheidung $x_t$ abhängt. Wir besprechen dies weiter unten ausführlicher. Wir werden $W_{t+1}$ als unsere Standardnotation verwenden, jedoch mit dem Verständnis, dass sie durch den Zustand $S_t$ oder die Entscheidung $x_t$ beeinflusst werden kann.
Die Entscheidung $x_t$ wird durch eine Methode bestimmt, die wir als Politik bezeichnen, welche wir mit $X^\pi(S_t)$ kennzeichnen. Die Notation $\pi$ trägt Informationen über die Struktur der Funktion, die wir durch $f$ innerhalb einer Menge potenzieller Funktionen $\Fcal$ darstellen, sowie über alle anpassbaren Parameter $\theta\in\Theta^f$, die durch die Struktur der Funktion definiert werden. Zum Beispiel könnte eine Bestandspolitik darin bestehen, $\theta^{order}$ Einheiten zu bestellen, sobald der Bestand unter $\theta^{min}$ fällt, was bedeutet, dass die anpassbaren Parameter $\theta = (\theta^{order}, \theta^{min})$ sind. Die Struktur der Funktion wäre ein Beispiel für eine Funktion $f$.
Wir nehmen an, dass wir über eine Übergangsfunktion verfügen, die als Eingabe den Zustand $S_t$, die Entscheidung $x_t$ und die exogene Information $W_{t+1}$ nimmt und uns den aktualisierten Zustand $S_{t+1}$ liefert. Übergangsfunktionen sind eine Reihe von Gleichungen, die jedes Element der Zustandsvariable $S_t$ aktualisieren, welche nur ein einziges Element oder Zehntausende (oder noch viel mehr) enthalten kann.
Wir erhalten einen Beitrag (oder Kosten) $C(S_t,x_t)$, wenn wir die Entscheidung $x_t=X^\pi(S_t)$ angesichts der Information im Zustand $S_t$ treffen. Unser Ziel ist es, die Politik zu finden, die ein Ziel maximiert, das von den Beiträgen $C(S_t,x_t)$ abhängt, wobei $x_t=X^\pi(S_t)$. Bei komplexeren Szenarien kann $C(S_t,x_t)$ tatsächlich eine Menge von Leistungskennzahlen sein, obwohl wir diese kombinieren müssen, um festzulegen, welche Entscheidung $x_t$ zu treffen ist.
Dies ist eine sehr kompakte Beschreibung eines sequentiellen Entscheidungsproblems. Als Nächstes beschreiben wir eine Reihe von Schritten, die im Modellierungsprozess zu befolgen sind.
Die Schritte im Modellierungsprozess
Es ist möglich, den gesamten Modellierungsprozess in sieben Schritte zu unterteilen (für unsere Zwecke). Diesen Schritten vorangestellt (unten als “Schritt 0” bezeichnet) ist eine kurze Zusammenfassung der technischen Komplexität der Anwendung, um Leserinnen und Lesern zur Orientierung zu dienen.
Schritt 0. Kapitelzusammenfassung – Wir eröffnen jedes Kapitel mit einer Zusammenfassung dessen, was das Kapitel behandeln wird, und in manchen Fällen, wie es sich auf Material aus anderen Kapiteln bezieht. Die Zusammenfassungen zeigen an, welche Ansätze zur Modellierung von Unsicherheit und welche Politiken verwendet werden.
Schritt 1. Die Erzählung – Dies wird eine Beschreibung des Problems in einfachem Englisch sein. Die Erzählung liefert nicht alle Informationen, die zur Erstellung eines mathematischen Modells notwendig sind; vielmehr ist sie ein erster Schritt, der dem Modellierer das Gesamtbild vermitteln soll, ohne sich in der Notation zu verlieren.
Schritt 2. Das Problem einrahmen – Dies besteht aus der Beantwortung dreier Fragen:
- Was sind die Leistungskennzahlen?
- Welche Arten von Entscheidungen werden getroffen (und in manchen Fällen, welcher Akteur trifft sie)?
- Was sind die Unsicherheitsquellen, die die Leistung beeinflussen?
Schritt 3. Identifizierung der Kernelemente des Problems, mit besonderem Schwerpunkt auf drei Dimensionen eines jeden sequentiellen Entscheidungsproblems. Diese Elemente werden ohne Verwendung von Mathematik beschrieben:
- Welche Kennzahlen versuchen wir zu beeinflussen? Einzelne Fachgebiete (wie Lieferkettenmanagement, Gesundheitswesen, Energie, Finanzen) werden jeweils durch eine Reihe von Kennzahlen charakterisiert, die mit Begriffen wie Kosten, Erlöse, Gewinne, Belohnungen, Gewinne, Verluste, Leistung und Risiko beschrieben werden könnten.
- Welche Entscheidungen werden getroffen? Die Identifizierung von Entscheidungen ist bei vielen Problemen, wie zum Beispiel Computerspielen, recht einfach, doch wenn wir uns einem komplexen Problem wie der Reaktion auf einen öffentlichen Gesundheitsprozess, der Reduzierung des CO2-Fußabdrucks oder der Verwaltung einer Lieferkette widmen, kann die Identifizierung aller Entscheidungen ziemlich herausfordernd sein.
- Was sind die verschiedenen Unsicherheitsquellen? Worüber sind wir uns unsicher, bevor wir beginnen? Welche Informationen treffen im Laufe der Zeit exogen ein (das heißt, sie treffen ein, nachdem wir eine Entscheidung getroffen haben)? Tabelle 1.2 veranschaulicht verschiedene Unsicherheitsquellen für ein Modell der Verteilung von COVID-Impfstoffen (siehe RLSO, Kapitel 10, für eine Darstellung von 12 Klassen der Unsicherheit).
Wir bezeichnen den Prozess der Beantwortung dieser drei Fragen als Einrahmen des Problems.
| Art der Unsicherheit | Beschreibung |
|---|---|
| 1) Beobachtungsfehler | Beobachtung von Personen mit Symptomen; Fehler bei der Klassifizierung von Personen mit Symptomen als COVID-Fälle |
| 2) Exogene Unsicherheit | Berichte über neue Fälle, Todesfälle; Verfügbarkeit von Intensivbetten; tatsächliche Impfstoffproduktion |
| 3) Prognostische Unsicherheit | Krankenhauseinweisungen; zukünftige Wirksamkeit der Impfstoffe; Reaktion der Bevölkerung auf Impfstoffe |
| 4) Inferenzielle Unsicherheit | Schätzungen der Infektionsraten; Schätzungen der Wirksamkeit von Impfstoffen |
| 5) Experimentelle Unsicherheit | Wirkstoffleistung in einer klinischen Studie; Anzahl der Geimpften |
| 6) Modellunsicherheit | Übertragungsraten der Krankheit; geografische Ausbreitung der Infektionen |
| 7) Übergangsunsicherheit | Zugänge/Abgänge bei den Impfstoffbeständen |
| 8) Kontrollunsicherheit | Welche Bevölkerungsgruppen geimpft wurden; Impfstoffzuteilungen |
| 9) Umsetzungsunsicherheit | Ausbleibende Impfung |
| 10) Kommunikationsfehler | Meldefehler aus dem Feld; ausbleibende Benachrichtigung, wann geimpft werden soll |
| 11) Zielunsicherheit | Meinungsverschiedenheiten darüber, wer geimpft werden sollte |
| 12) Umgebungsunsicherheit | Ob/wann ein Impfstoff zugelassen wird; Verteilung der Impfstoffe auf verschiedene Bundesstaaten, Länder |
Tabelle 1.2. Veranschaulichung verschiedener Arten von Unsicherheit, die bei der Reaktion auf die COVID-Pandemie im Zusammenhang mit Impfungen auftreten.
Schritt 4. Das mathematische Modell – Hier bauen wir auf den ersten drei Elementen aus Schritt 2 auf, müssen nun aber ein mathematisches Modell erstellen, das aus fünf Dimensionen besteht, die für jedes sequentielle Entscheidungsproblem gelten:
- Zustandsvariablen $S_t$ – Die Zustandsvariable erfasst alles, was Sie zum Zeitpunkt $t$ wissen müssen, um zum Zeitpunkt $t$ eine Entscheidung zu treffen, Kosten und Nebenbedingungen zu berechnen und, falls notwendig, bis zum Zeitpunkt $t+1$ zu simulieren. Zustandsvariablen können Informationen über physische Ressourcen enthalten (Bestände oder der Standort eines Fahrzeugs, die über Nebenbedingungen in das Problem eingehen), andere Informationen (wie Kosten oder Preise, die in die Zielfunktion eingehen) sowie Überzeugungen über Größen und Parameter, die uns nicht perfekt bekannt sind (wie Prognosen oder Schätzungen darüber, wie ein Patient auf ein Medikament reagieren würde).
-
Entscheidungsvariablen $x_t$ – Diese beschreiben, wie wir unser System gestalten oder steuern werden. Entscheidungen müssen Nebenbedingungen erfüllen, die wir als $x_t \in \Xcal$ schreiben, wobei $\Xcal$ eine Menge diskreter Wahlmöglichkeiten oder eine Reihe linearer Gleichungen sein könnte. Entscheidungen werden durch Politiken bestimmt, das sind Funktionen (oder Regeln), die wir mit $X^\pi(S_t)$ bezeichnen und die $x_t$ auf Grundlage dessen, was in der Zustandsvariable enthalten ist, festlegen. Politiken können sehr einfach sein (billig kaufen, teuer verkaufen) oder ziemlich komplex.
Der Index $\pi$ trägt Informationen über die Art der Funktion, die zur Entscheidungsfindung verwendet wird, sowie über beliebige anpassbare Parameter. Sei $f\in\Fcal$ die Struktur der Funktion, $\Fcal$ die Menge der möglichen Funktionen, und sei $\theta\in\Theta^f$ ein beliebiger anpassbarer Parameter für die Funktion $f$. Unsere Politik würde dann als $\pi = (f,\theta)$ dargestellt werden. Wir werden die Politik oft als $X^\pi(S_t\vert \theta)$ schreiben, um die Abhängigkeit von anpassbaren Parametern anzuzeigen.
Wir kommen in diesem Kapitel und im gesamten Buch noch ausführlich darauf zurück. Jedes der im Buch gegebenen Beispiele wurde ausgewählt, um bestimmte Arten von Politiken zu veranschaulichen.
- Exogene Information $W_{t+1}$ – Dies ist neue Information, die eintrifft, nachdem wir die Entscheidung $x_t$ getroffen haben (aber bevor wir $x_{t+1}$ entscheiden), wie zum Beispiel wie viel wir nach der Festlegung eines Preises verkaufen, oder die Zeit, die benötigt wird, um den von uns gewählten Weg zurückzulegen. Wenn wir zum Zeitpunkt $t$ eine Entscheidung treffen, ist die Information in $W_{t+1}$ unbekannt, sodass wir sie als Zufallsvariable behandeln, wenn wir $x_t$ wählen.
- Die Übergangsfunktion $S^M(S_t,x_t,W_{t+1})$ – Dies sind die Gleichungen, die beschreiben, wie sich die Zustandsvariablen im Laufe der Zeit entwickeln. Bei vielen realen Problemen erfassen Übergangsfunktionen die gesamte Dynamik des Problems und können ziemlich komplex sein. In manchen Fällen kennen wir nicht einmal die Gleichungen und müssen uns allein auf die Zustandsvariablen verlassen, die wir beobachten können. Wir schreiben die Entwicklung der Zustandsvariablen $S_t$ mithilfe unserer Übergangsfunktion als
wobei $S^M(\cdot)$ als Zustands- (oder System-)Übergangsmodell bezeichnet wird (daher das $M$ im Exponenten). Die Übergangsfunktion beschreibt, wie sich jedes Element der Zustandsvariable angesichts der Entscheidungen $x_t$ und der exogenen Information $W_{t+1}$ ändert. Bei komplexen Problemen kann die Umsetzung der Übergangsfunktion Tausende von Codezeilen erfordern.
-
Die Zielfunktion – Diese erfasst die Leistungskennzahlen, die wir zur Bewertung unserer Leistung verwenden, und bildet die Grundlage für die Suche über Politiken. Wir bezeichnen mit $C(S_t,x_t)$ den Beitrag (bei Maximierung) oder die Kosten (bei Minimierung) der Entscheidung $x_t$, die von der Information in $S_t$ abhängen kann. In manchen Szenarien ist es natürlicher, die Einperioden-Beitragsfunktion als $C(S_t,x_t,W_{t+1})$ zu schreiben, die Beitragsfunktion ausgewertet am Ende des Zeitintervalls $(t,t+1)$, nachdem $W_{t+1}$ beobachtet wurde. Zum Beispiel können wir eine Bestellung über $x_t$ aufgeben, die sofort eintrifft, um die unsichere Nachfrage zu decken, die in $W_{t+1}$ enthalten ist.
Unser Ziel ist es, die beste Politik $X^\pi(S_t)$ zu finden, um eine Kennzahl zu optimieren, wie zum Beispiel:
- Maximierung der erwarteten Summe der Beiträge über einen bestimmten Horizont.
- Maximierung der erwarteten Leistung eines endgültigen Designs, das wir über eine Reihe von Experimenten oder Beobachtungen gelernt haben.
- Minimierung des mit einem endgültigen Design verbundenen Risikos.
Unsere gebräuchlichste Art, die Zielfunktion zu schreiben, ist
wobei “$\E$” der Erwartungswertoperator genannt wird, was bedeutet, dass ein Mittelwert über alles Zufällige gebildet wird, was unsichere Information im Ausgangszustand $S_0$ sowie den exogenen Informationsprozess $W_1, \ldots, W_T$ umfassen kann. Es ist üblich, den Erwartungswertoperator zu schreiben, aber wir können ihn tatsächlich nie berechnen. Später zeigen wir, wie man ihn annähern kann, indem man eine Reihe von Simulationen durchführt und einen Mittelwert bildet, oder indem man einen Prozess im Feld beobachtet.
Bei der Interpretation des Erwartungswertoperators “$\E$” in Gleichung $\eqref{eq:baseobjectivefunction}$ ist Vorsicht geboten. Was dieser Operator wörtlich bedeutet, ist “einen Mittelwert über alles zu bilden, was unsicher ist.” Das offensichtlichste Element der Unsicherheit ist der exogene Informationsprozess $W_1, W_2, \ldots, W_t, \ldots, W_T$.
Der Übergang vom realen Problem (geleitet durch die Erzählung) zu den Elementen des mathematischen Modells ist vielleicht der schwierigste Schritt, da er häufig das Einholen von Informationen aus einer nichttechnischen Quelle erfordert.
Wir stellen fest, dass wir das gesamte Modell vorgestellt haben, ohne festzulegen, wie wir Entscheidungen treffen, was durch die Politik $X^\pi(S_t)$ dargestellt wird. Wir nennen dies “erst modellieren, dann lösen”, und es stellt eine bedeutende Abweichung von der umfangreichen Literatur dar, die sich mit sequentiellen Entscheidungsproblemen befasst. Es lässt sich kaum vermitteln, wie wichtig es ist, sequentielle Entscheidungsprobleme auf diese Weise anzugehen.
Schritt 5. Das Unsicherheitsmodell – Dies ist die Art und Weise, wie wir die verschiedenen Arten von Unsicherheit modellieren. Es gibt zwei Möglichkeiten, Unsicherheit in unser Modell einzubringen:
- Über den Ausgangszustand $S_0$, der eine Wahrscheinlichkeitsverteilung für unsichere Parameter angeben könnte, wie zum Beispiel, wie ein Patient auf ein Medikament reagieren könnte oder wie der Markt auf einen Preis reagieren könnte.
- Über den exogenen Informationsprozess $W_1, \ldots, W_T$.
Wir haben drei Möglichkeiten, den exogenen Informationsprozess zu modellieren:
- Ein mathematisches Modell von $W_1, W_2, \ldots, W_T$ erstellen.
- Beobachtungen aus der Vergangenheit verwenden, wie zum Beispiel vergangene Preise, Verkäufe oder Wetterereignisse.
- Das System im Feld laufen lassen und $W_t$ beobachten, wenn sie geschehen.
Schritt 6. Entwurf von Politiken – Politiken sind Funktionen, daher müssen wir nach der besten Funktion suchen. (Ja, Politiken sind Funktionen, um die beste Entscheidung zu wählen, aber die Wahl der Politik ist ebenfalls eine Entscheidung!) Wir tun dies, indem wir zwei Kernstrategien für den Entwurf von Politiken identifizieren:
- Suche über eine Familie von Funktionen, um diejenige zu finden, die im Zeitverlauf im Durchschnitt am besten funktioniert.
- Erstelle eine Politik, indem die unmittelbaren Kosten oder den unmittelbaren Beitrag einer Entscheidung $x_t$ geschätzt werden, zuzüglich einer Näherung der zukünftigen Kosten oder Beiträge, und dann die Wahl $x_t$ gefunden wird, die die Summe aus aktuellen und zukünftigen Kosten oder Beiträgen optimiert. Google Maps entscheidet, ob links oder rechts abgebogen wird, indem über die Zeit optimiert wird, die benötigt wird, um das nächste Segment im Netzwerk zu durchqueren, zuzüglich der verbleibenden Zeit, um zum Ziel zu gelangen. Eine Bestandsentscheidung könnte über die Kosten einer Bestellung plus dem geschätzten Wert des Haltens einer bestimmten Bestandsmenge für die Zukunft optimieren.
Wir werden viel expliziter darlegen, wie diese Politiken identifiziert werden können. Ein späterer Abschnitt beschreibt vier Klassen von Politiken, die jede Methode zur Entscheidungsfindung einschließen (dies sind Meta-Klassen).
Schritt 7. Bewertung von Politiken – Die beste Politik zu finden bedeutet, Politiken zu bewerten, um zu bestimmen, welche die beste ist. Es gibt zwei Möglichkeiten, eine Politik zu bewerten:
- Testen der Politik in einem Computersimulator. Dies erfordert die Programmierung aller Gleichungen im Zustandsübergangsmodell $S^M(S_t,x_t,W_{t+1})$, die zur Aktualisierung der Zustandsvariable $S_t$ benötigt werden. Es bedeutet auch, in der Lage zu sein, Stichproben von $W_{t+1}$ zu erzeugen, was oft der subtilste Aspekt eines Simulators ist.
- Beobachtung, wie die Politik in der Praxis funktioniert.
Simulatoren können komplex und schwierig zu erstellen sein und unterliegen immer noch Modellierungsapproximationen. Aus diesem Grund beinhaltet die überwiegende Mehrheit der in der Praxis auftretenden Probleme in der Regel Tests im Feld, was langsam ist (es dauert einen Tag, um einen Tag zu simulieren) und erfordert, mit den Ergebnissen der Experimente zu leben.
Die einzige Möglichkeit, sich mit einem mathematischen Modell vertraut zu machen, besteht darin, es anhand eines bekannten Beispiels illustriert zu sehen. Wir beginnen mit einem universellen Problem, dem wir alle im Alltag begegnen: der Verwaltung von Beständen.
Einige Bestandsprobleme
Wir werden unser Modellierungsrahmenwerk anhand von zwei Varianten eines klassischen Bestandsproblems veranschaulichen, das häufig als Anwendung zur Illustration bestimmter Methoden zur Lösung sequentieller Entscheidungsprobleme verwendet wird. Wir beginnen mit einem einfachen Bestandsbeispiel, das die Kernelemente unseres Modellierungsrahmenwerks vermittelt, uns aber erlaubt, viele der Komplexitäten zu ignorieren, die wir im weiteren Verlauf des Buches untersuchen werden.
Dann werden wir zu einem etwas komplizierteren Bestandsproblem übergehen, das es uns erlaubt, einige Modellierungsprinzipien zu veranschaulichen. Im gesamten Buch werden wir auch die Idee verwenden, mit einer grundlegenden Version eines Problems zu beginnen und dann Erweiterungen einzuführen, die auf die Arten von Komplikationen hindeuten, die in realen Anwendungen auftreten können.
Ein einfaches Bestandsproblem
Eines der vertrautesten sequentiellen Entscheidungsprobleme, das wir alle jedes Mal erleben, wenn wir ein Geschäft besuchen, ist ein Bestandsproblem. Wir werden eine einfache Version dieses Problems verwenden, um die sechs Schritte unseres oben eingeführten Modellierungsprozesses zu veranschaulichen:
Schritt 1: Erzählung – Eine Pizzeria muss entscheiden, wie viele Pfund Wurst sie bei ihrem Lebensmittelhändler bestellt. Das Restaurant muss die Entscheidung am Ende von Tag $t$ treffen, die Bestellung mitteilen, die dann am nächsten Morgen eintrifft, um die Bestellungen des nächsten Tages zu erfüllen. Wenn Wurst übrig bleibt, kann sie bis zum nächsten Tag aufbewahrt werden. Die Kosten der Wurst und der Preis, zu dem sie am nächsten Tag verkauft wird, sind im Voraus bekannt, aber die Nachfrage ist es nicht.
Schritt 2: Die Kernelemente des Problems sind:
- Metriken – Wir wollen die Gewinne maximieren, die sich aus den Verkäufen von Wurst abzüglich der Kosten für den Kauf der Wurst ergeben.
- Entscheidungen – Wir müssen entscheiden, wie viel am Ende eines Tages bestellt wird, das zu Beginn des nächsten eintrifft.
- Unsicherheitsquellen – Die einzige Unsicherheitsquelle in diesem einfachen Modell ist die Nachfrage nach Wurst am nächsten Tag.
Schritt 3: Das mathematische Modell – Dies besteht aus fünf Elementen.
1) Die Zustandsvariable $S_t$ – Wir unterscheiden zwischen der initialen Zustandsvariable $S_0$ und der dynamischen Zustandsvariable $S_t$ für $t > 0$. Die initiale Zustandsvariable $S_0$ besteht aus festen Parametern und initialen Werten von Variablen, die sich im Zeitverlauf ändern, was uns
\[S_0 = (R^{inv}_0, (p, c), (\Dbar, \sigmabar^D)).\]ergibt. Wir haben den initialen Zustand in drei Arten von Variablen unterteilt:
- Initiale Werte des Ressourcenzustands $R^{inv}_0$.
- Werte konstanter Parameter $c$ und $p$.
- Unser Belief über die Nachfragen, gegeben durch eine Normalverteilung mit Mittelwert $\Dbar$ und Standardabweichung $\sigmabar^D$.
Die dynamische Zustandsvariable $S_t$ ist unser Bestand, den wir $R^{inv}_t$ nennen werden. Vorerst ist dies das einzige Element der dynamischen Zustandsvariable, also
\[S_t = R^{inv}_t.\]Später werden wir zusätzliche Elemente zu unserer Zustandsvariable einführen.
2) Die Entscheidungsvariable $x_t$ ist, wie viel wir zum Zeitpunkt $t$ bestellen, was (vorerst) sofort eintrifft, wie wir annehmen. Wir treffen unsere Entscheidungen mit einer Politik $X^\pi(S_t)$, die wir später entwerfen.
3) Die exogene Information ist die zufällige Nachfrage nach unserem Produkt, die wir mit $\Dhat_{t+1}$ bezeichnen werden, also $W_{t+1} = \Dhat_{t+1}$.
4) Unsere Übergangsfunktion erfasst, wie sich der Bestand $R_t$ im Zeitverlauf entwickelt, gegeben durch
\[\begin{align} R^{inv}_{t+1} = \max\{0, R^{inv}_t+x_t-\Dhat_{t+1}\}. \label{eq:inventoryexampleequation} \end{align}\]5) Unsere Zielfunktion. Für unser Bestandsproblem ist es am natürlichsten, den Beitrag einschließlich der Einkaufskosten des Produkts $x_t$ und der Einnahmen aus der Befriedigung der Nachfrage $\Dhat_{t+1}$ zu berechnen, was bedeutet, dass unsere Einperioden-Beitragsfunktion geschrieben werden würde als
\[C(S_t,x_t,\Dhat_{t+1}) = -cx_t + p \min\{R^{inv}_t+x_t, \Dhat_{t+1}\},\]wobei $x_t = X^\pi(S_t)$. Bei einer gegebenen Sequenz von Nachfragen $\Dhat_1, \ldots, \Dhat_T$ wäre der Wert einer Politik $\Fhat^\pi$
\[\Fhat^\pi(S_0) = \sum_{t=0}^T C(S_t,X^\pi(S_t),\Dhat_{t+1}).\]Unsere Gewinne $\Fhat^\pi(S_0)$ sind zufällig, da sie von einer bestimmten Sequenz zufälliger Nachfragen $\Dhat_1, \ldots, \Dhat_T$ abhängen. Schließlich mitteln wir über diese zufälligen Nachfragen, indem wir den Erwartungswert bilden:
\[\begin{align} F^\pi(S_0) = \E \left\{\sum_{t=0}^T C(S_t,X^\pi(S_t),\Dhat_{t+1})\vert S_0\right\}. \label{eq:inventoryobjective} \end{align}\]Hier kann die Bedingung auf den initialen Zustand $S_0$ so gelesen werden, dass gesagt wird “nimm den Erwartungswert gegeben, was wir anfänglich wissen.” Die Bedingung auf $S_0$ ist immer implizit, wenn wir einen Erwartungswert bilden, und daher lassen viele Autoren sie weg. Wir werden jedoch die Bedingung auf $S_0$ einbeziehen, um deutlich zu machen, dass, wenn sich unsere anfänglichen Eingaben (einschließlich Beliefs) ändern, dies eine Auswirkung darauf haben kann, wie eine Politik funktioniert.
Schritt 4. Das Unsicherheitsmodell – Der einfachste Ansatz zur Modellierung von Unsicherheit besteht darin, einfach historische Daten zu verwenden. Das Problem, auf das wir stoßen könnten, ist, dass wir, wenn uns die Wurst ausgeht, möglicherweise nicht die volle Nachfrage nach Wurst an diesem Tag beobachten. Wenn wir in der Lage sind, diese verlorene Nachfrage zu erfassen, dann ist dies ein vernünftiger Ansatz.
Eine Alternative besteht darin, ein mathematisches Modell zu erstellen. Wir könnten annehmen, dass unsere Nachfrage normalverteilt ist mit einem bestimmten Mittelwert $\Dbar$ und einer Standardabweichung $\sigmabar^D$. Wenn wir annehmen, dass beide bekannt sind, können wir unsere Nachfrage schreiben als
\[\Dhat_{t+1} \sim N(\Dbar,(\sigmabar^D)^2),\]und Pakete nutzen, die aus der Normalverteilung stichprobieren können (zum Beispiel wird dies in Excel Norm.inv$(Rand(),\Dbar,\sigmabar)$ genannt), um eine zufällige Beobachtung mit Mittelwert $\Dbar$ und Standardabweichung $\sigmabar$ zu erzeugen.
Unter Verwendung dieses Modells können wir eine Menge von Nachfragen $(\Dhat_1, \Dhat_2, \ldots, \Dhat_T)$ erstellen. Dann können wir dies $N$ Mal wiederholen, um $N$ Sequenzen von $T$ Nachfragen zu erstellen, was uns die Sequenz $(\Dhat^n_1, \Dhat^n_2, \ldots, \Dhat^n_T)$ für $n=1, \ldots, N$ ergibt, die wir benötigen, um den Wert der Politik zu schätzen (wir verwenden dies unten in Schritt 6).
Schritt 5. Entwurf von Politiken – Als Nächstes müssen wir eine Methode zur Bestimmung unserer Bestellungen entwerfen. Eine häufig verwendete Strategie für Bestandsprobleme ist als “order-up-to”-Politik bekannt, die wie folgt aussieht
\[\begin{align} X^\pi(S_t\vert \theta) = \begin{cases} \theta^{max} - R_t & \text{if } R_t < \theta^{min}, \\ 0 & \text{otherwise,}\end{cases} \label{eq:introorderupto} \end{align}\]wobei $\theta = (\theta^{min},\theta^{max})$ eine Menge von Parametern ist, die abgestimmt werden müssen. Sie wird “order-up-to” genannt, da wir eine Bestellung aufgeben, um den Bestand “bis zur” oberen Grenze $\theta^{max}$ zu bringen.
Schritt 6. Bewertung von Politiken – Es gibt eine Vielzahl von Strategien, die wir verwenden könnten. In der Praxis können wir den Erwartungswert in der Zielfunktion in Gleichung $\eqref{eq:inventoryobjective}$ nicht berechnen, also nehmen wir eine Reihe von Stichproben von Nachfragen. Sei $\Dhat^n_1, \ldots, \Dhat^n_T$ eine Stichprobe von Nachfragen über $t=1, \ldots, T$, und nehmen wir an, wir können $N$ davon erzeugen. Nun können wir unsere erwarteten Gewinne aus Politik $X^\pi(S_t)$ schätzen, indem wir über die Stichproben für $n=1, \ldots, N$ mitteln, was berechnet wird unter Verwendung von
\[\Fbar^\pi(\theta\vert S_0) = \frac{1}{N} \sum_{n=1}^N \sum_{t=0}^T C(S_t,X^\pi(S_t\vert \theta),\Dhat^n_{t+1}).\]Auf gut Deutsch gesagt, simulieren wir die Politik $X^\pi(S_t\vert \theta)$ $N$ Mal unter Verwendung der simulierten (oder aus der Historie beobachteten) Stichproben von Nachfragen $\Dhat^n_1, \ldots, \Dhat^n_T$ und mitteln dann die Leistung, um $\Fbar^\pi(\theta\vert S_0)$ zu erhalten. Wir stehen dann vor dem Problem, den besten Wert von $\theta$ zu finden. Eine einfache Strategie wäre, $K$ mögliche Werte $\theta_1, \ldots, \theta_K$ zu erzeugen, jeden zu simulieren, um $\Fbar^\pi(\theta_k\vert S_0)$ für jedes $k$ zu finden, und dann den Wert von $\theta_k$ zu wählen, der am besten funktioniert. Dies ist keine optimale Strategie, bietet aber einen einfachen, praktischen Ausgangspunkt.
Ein etwas komplizierteres Problem
Das obige einfache Bestandsproblem ist ein klassisches Setting zur Demonstration einer bestimmten Methode zur Lösung sequentieller Entscheidungsprobleme, die als dynamische Programmierung bekannt ist, welche davon abhängt, eine einfache Zustandsvariable zu haben, die a) diskret ist und b) nicht zu viele mögliche Werte hat. In unserem etwas komplizierteren Bestandsproblem werden wir drei verschiedene Ausprägungen von Zustandsvariablen veranschaulichen, die für eine populäre Methode zur Lösung sequentieller Entscheidungsprobleme eine ernsthafte Komplikation darstellen würden, aber keine Auswirkung auf die Politik haben, die wir gewählt haben.
Schritt 1: Erzählung – Wir haben wieder unsere Pizzeria, die Wurst bestellen muss, aber wir werden zulassen, dass der Preis, den wir für Wurst zahlen, von Tag zu Tag variiert, wobei wir annehmen, dass der Preis an einem Tag unabhängig vom Preis am Vortag ist. Dann werden wir auch annehmen, dass, während die Nachfrage nach Wurst am nächsten Tag zufällig ist, wir eine Prognose der morgigen Nachfrage erhalten, die zwar nicht perfekt ist, aber besser als gar keine Prognose zu haben. Ansonsten ist alles an unserem komplizierteren Problem gleich wie zuvor.
Schritt 2: Kernelemente – Diese sind:
- Metriken – Wir wollen die Gewinne maximieren, die sich aus den Verkäufen von Wurst abzüglich der Kosten für den Kauf der Wurst ergeben, wobei die Kosten von Tag zu Tag variieren.
- Entscheidungen – Wie bei unserem einfacheren Bestandsproblem müssen wir entscheiden, wie viel am Ende eines Tages bestellt wird, das zu Beginn des nächsten eintrifft.
- Unsicherheitsquellen – Es gibt nun drei Unsicherheitsquellen: die Differenz zwischen der tatsächlichen Nachfrage und der Prognose, die Entwicklung der Prognosen von einem Tag zum nächsten, und der Preis, den wir für die Wurst zahlen.
Schritt 3: Mathematisches Modell – Wir haben immer noch dieselben fünf Elemente, aber jetzt ist das Problem etwas reichhaltiger:
1) Um die Zustandsvariable zu konstruieren, müssen wir die Information auflisten (insbesondere Information, die sich im Zeitverlauf entwickelt), die in drei verschiedenen Teilen des Modells benötigt wird: (1) die Zielfunktion, (2) die Politik zur Entscheidungsfindung (die die Nebenbedingungen einschließt), und (3) die Übergangsfunktion. Natürlich haben wir noch keine dieser Funktionen eingeführt, also müssen Sie weiterlesen und überprüfen, dass unsere Zustandsvariable alle Informationen enthält, die zur Berechnung jeder dieser Funktionen benötigt werden. Betrachten Sie dies als ein Wörterbuch der Information, die wir benötigen werden.
Wir beginnen mit dem initialen Zustand $S_0$, der aus konstanten Parametern und initialen Werten von Größen und Parametern besteht, die sich im Zeitverlauf ändern. Diese sind:
- Initialer Bestand – Wir beginnen mit einem initialen Bestand $R_0$.
- Initiale Einkaufskosten – $c_0$.
- Preis – Wir nehmen an, dass wir unsere Wurst zu einem festen Preis $p$ verkaufen.
- Initiale Prognose – Wir nehmen an, dass unsere erste Prognose $f^D_{0,1}$ gegeben ist, wobei $f^D_{0,1}$ die zum Zeitpunkt 0 bekannte Prognose für die Nachfrage zum Zeitpunkt 1 ist.
- Initiale Schätzung der Standardabweichung der Nachfrage – $\sigmabar^D_0$.
- Initiale Schätzung der Standardabweichung der Prognose – $\sigmabar^f_0$.
Das bedeutet, unsere initiale Zustandsvariable ist
\[S_0 = (R_0,c_0, p, f^D_{0,1}, \sigmabar^D_0, \sigmabar^f_0).\]Wir haben dann die Information, die sich im Zeitverlauf entwickelt und unsere dynamische Zustandsvariable $S_t$ ausmacht:
- Aktueller Bestand $R^{inv}_t$ – Der Bestand zu Beginn des Zeitintervalls $(t,t+1)$.
- Einkaufskosten $c_t$ – Dies sind die Kosten der zum Zeitpunkt $t$ gekauften Wurst, die uns zum Zeitpunkt $t$ gegeben werden.
- Nachfrageprognose $f^D_{t,t+1}$ – Dies ist die Prognose von $\Dhat_{t+1}$ gegeben dem, was wir zum Zeitpunkt $t$ wissen.
- Aktuelle Schätzung der Standardabweichung der Nachfrage – $\sigmabar^D_t$.
- Aktuelle Schätzung der Standardabweichung der Prognose – $\sigmabar^f_t$.
Unsere dynamische Zustandsvariable ist dann gegeben durch
\[S_t = (R^{inv}_t, c_t, f^D_{t,t+1}, \sigmabar^D_t, \sigmabar^f_t).\]2) Die Entscheidungsvariable $x_t$ ist die Menge, die wir zum Zeitpunkt $t$ bestellen, wobei wir (vorerst) annehmen, dass sie sofort eintrifft. Wir treffen unsere Entscheidungen mit einer Politik $X^\pi(S_t)$, die wir später entwerfen.
3) Die exogene Information besteht nun aus:
- Einkaufskosten $\chat_{t+1}$ – Dies sind die Einkaufskosten für Wurst am Tag $t+1$, die exogen festgelegt werden.
- Prognosen – In jeder Zeitperiode erhalten wir eine neue Prognose. Sei $\varepsilon^f_{t+1}$ die Änderung der Prognose zwischen Zeitpunkt $t$ und $t+1$.
- Nachfragen – Schließlich nehmen wir an, dass die tatsächliche Nachfrage eine zufällige Abweichung von der Prognose ist, die wir wie folgt schreiben können
Unsere vollständige Menge an exogenen Informationsvariablen kann nun geschrieben werden als
\[W_{t+1} = \big(\chat_{t+1}, \varepsilon^f_{t+1}, \varepsilon^D_{t+1}\big).\]4) Übergangsfunktion – Diese legt fest, wie sich jede der (dynamischen) Zustandsvariablen $S_t$ im Zeitverlauf entwickelt. Wir aktualisieren unseren Bestand mit:
\[\begin{align} R^{inv}_{t+1} &= \max\{0, R^{inv}_t + x_t - \Dhat_{t+1}\}. \label{eq:introcomplexinventorytransition1} \end{align}\]Die Nachfrage ist die prognostizierte Nachfrage plus die Abweichung $\varepsilon^D_{t+1}$ von der Prognose, was uns die Gleichung liefert:
\[\begin{align} \Dhat_{t+1} &= f^D_{t,t+1} + \varepsilon^D_{t+1}. \label{eq:introcomplexinventorytransition2} \end{align}\]Wir nehmen an, dass unsere Prognose aktualisiert wird mit
\[\begin{align} f^D_{t+1,t+2} &= f^D_{t,t+1} + \varepsilon^f_{t+1}. \label{eq:introcomplexinventorytransition3} \end{align}\]Als Nächstes werden wir die Varianz der Nachfrage und der Nachfrageprognose adaptiv schätzen:
\[\begin{align} (\sigmabar^D_{t+1})^2 &= (1-\alpha)(\sigmabar^D_t)^2 + \alpha (f^D_{t,t+1} - \Dhat_{t+1})^2, \label{eq:introcomplexinventorytransition4}\\ (\sigmabar^f_{t+1})^2 &= (1-\alpha)(\sigmabar^f_t)^2 + \alpha (f^D_{t,t+1} - f^D_{t+1,t+2})^2, \label{eq:introcomplexinventorytransition5} \end{align}\]wobei $0 < \alpha < 1$ ein Glättungsfaktor ist.
Schließlich aktualisieren wir die Kosten $c_{t+1}$ mit den “beobachteten Kosten” $\chat_{t+1}$, was wir einfach schreiben als
\[\begin{align} c_{t+1} = \chat_{t+1}.\label{eq:introcomplexinventorytransition6} \end{align}\]Gleichung $\eqref{eq:introcomplexinventorytransition6}$ ist ein Beispiel für eine Zustandsvariable, die wir beobachten, anstatt sie zu berechnen, wie wir es beim Bestand $R^{inv}_t$ in $\eqref{eq:introcomplexinventorytransition1}$ getan haben. Gleichung $\eqref{eq:introcomplexinventorytransition1}$ wird manchmal als “modellbasiert” bezeichnet, da sie die Physik widerspiegelt, wie Bestände aktualisiert werden, während Gleichung $\eqref{eq:introcomplexinventorytransition6}$ als “modellfrei” bezeichnet wird, da wir keinerlei Versuch unternehmen, den zugrunde liegenden Prozess zu modellieren, der die Kostenänderung erzeugt.
Unsere Übergangsfunktion $S_{t+1} = S^M(S_t,x_t,W_{t+1})$ besteht aus den Gleichungen $\eqref{eq:introcomplexinventorytransition1}$–$\eqref{eq:introcomplexinventorytransition6}$.
5) Schließlich würde unsere Einperioden-Beitragsfunktion nun geschrieben werden als
\[C(S_t,x_t,\Dhat_{t+1}) = -c_tx_t + p \min\{R_t+x_t, \Dhat_{t+1}\},\]wobei der einzige Unterschied zum einfacheren Bestandsproblem darin besteht, dass die Kosten $c$ nun zeitabhängig sind $c_t$. Wir weichen von unserer Konvention ab, den Beitrag als $C(S_t,x_t)$ zu schreiben, und lassen ihn Erlöse aus den Nachfragen $\Dhat_{t+1}$ einbeziehen.
Wir formulieren nun unsere Zielfunktion formal als
\[\begin{align} \max_{\pi=(f,\theta)} \E \left\{\sum_{t=0}^T C(S_t,X^\pi(S_t\vert \theta),\Dhat_{t+1})\vert S_0\right\}. \label{eq:introcomplexinventoryobjective} \end{align}\]Die Optimierung $\max_\pi$ bedeutet, dass wir über alle möglichen Politiken suchen, die durch $(f,\theta)$ dargestellt werden, was buchstäblich bedeutet, über all die verschiedenen Funktionen zu suchen, die wir zur Entscheidungsfindung verwenden könnten. Die Beispiele in diesem Buch werden zeigen, wie wir über Funktionen suchen werden.
Erinnern Sie sich daran, dass wir oben festgestellt haben, dass der Index $\pi$ Informationen über den Funktionstyp $f\in\Fcal$ und etwaige einstellbare Parameter $\theta\in\Theta^f$ trägt. In der Praxis erfolgt die Suche über die Funktionstypen $f\in\Fcal$ tendenziell ad hoc (ein sachkundiger Analyst wählt Funktionen aus, die für ein Problem sinnvoll sind), während ein Computeralgorithmus die Suche nach dem besten Wert von $\theta\in\Theta^f$ durchführt.
Schritt 4. Das Unsicherheitsmodell – Wir werden annehmen, dass die exogenen Änderungen $\varepsilon^D_{t+1}$ und $\varepsilon^f_{t+1}$ durch Normalverteilungen mit Mittelwert 0 und Varianzen $(\sigmabar^D_t)^2$ und $(\sigmabar^f_t)^2$ beschrieben werden, was wir wie folgt ausdrücken
\[\varepsilon^D_t \sim N(0, (\sigmabar^D_t)^2), \quad \varepsilon^f_t \sim N(0, (\sigmabar^f_t)^2).\]Unsicherheitsmodelle können recht komplex werden, aber dies soll als Veranschaulichung dienen.
Schritt 5. Entwurf von Politiken – Als Nächstes müssen wir eine Methode zur Bestimmung unserer Bestellungen entwerfen. Anstelle der Order-up-to-Politik unseres einfacheren Modells schlagen wir die Idee vor, so viel zu bestellen, dass die erwartete Nachfrage für morgen gedeckt wird, mit einer Anpassung. Wir könnten dies schreiben als
\[\begin{align} X^\pi(S_t\vert \theta) = \max\{0,f^D_{t,t+1}-R_t\} + \theta. \label{eq:adjustedforecastpolicy} \end{align}\]Hätten wir eine perfekte Prognose, müssten wir nur $f^D_{t,t+1}$ (unsere Prognose von $\Dhat_{t+1}$) abzüglich des vorhandenen Bestands bestellen. Aufgrund der Unsicherheit werden wir jedoch eine Anpassung $\theta$ hinzufügen, sodass wir einen gewissen Puffer haben, um Fehlbestände zu vermeiden.
Schritt 6. Bewertung von Politiken – Diesmal müssen wir Stichproben aller Zufallsvariablen in der Sequenz $W_1, W_2, \ldots, W_T$ erzeugen. Wiederum könnten wir $N$ Stichproben der gesamten Sequenz erzeugen, sodass wir die Leistung einer Politik schätzen können mit
\[\Fbar^\pi(\theta) = \frac{1}{N} \sum_{n=1}^N \sum_{t=0}^T C(S_t,X^\pi(S_t\vert \theta),\Dhat^n_{t+1}).\]Wir stehen erneut vor dem Problem, den besten Wert von $\theta$ zu finden, doch wir kommen später auf diese Herausforderung zurück.
Der universelle Modellierungsrahmen
Wir sind nun bereit, die Elemente des universellen Modellierungsrahmens (UMF) genauer zu beschreiben. Wir stellen fest, dass der UMF jedes sequentielle Entscheidungsproblem modellieren kann. Diese ziemlich weitreichende Behauptung wird deutlich werden, sobald sich die Elemente entfalten, da wir lediglich Notation auf die allgemeine Aussage eines sequentiellen Entscheidungsproblems anwenden.
Die fünf Elemente des UMF
Der UMF besteht aus den folgenden Elementen:
- Den Zustandsvariablen $S_t$.
- Den Entscheidungsvariablen $x_t$.
- Dem exogenen Informationsprozess $W_t$.
- Dem Zustandsübergangsmodell $S^M(S_t,x_t,W_{t+1})$.
- Der Zielfunktion.
Wir beschreiben diese im Folgenden genauer:
Zustandsvariablen – Der Zustand $S_t$ des Systems zum Zeitpunkt $t$ enthält alle Informationen, die notwendig und hinreichend sind, um unser System ab dem Zeitpunkt $t$ zu modellieren. Genauer gesagt besteht diese Information aus:
- a) Den Informationen, die benötigt werden, um zum Zeitpunkt $t$ eine Entscheidung zu treffen.
- b) Den Informationen, die benötigt werden, um die Leistungskennzahlen zum Zeitpunkt $t$ zu berechnen.
- c) Allen Informationen, die jetzt benötigt werden, um (a) und (b) in der Zukunft zu berechnen.
Es gibt drei Arten von Informationen in $S_t$:
- Der physische Zustand, $R_t$, erfasst physische Größen wie Bestände, Personen, verfügbare Maschinen, Einrichtungen, Wasser, Medikamente, Energie und Geld (in seinen verschiedenen Formen). $R_t$ umfasst auch Kundenanfragen nach Produkten oder Dienstleistungen. In vielen Anwendungen beschreibt $R_t$ die Ressource, die verwaltet wird, und ein recht häufiger Fehler besteht darin, “Zustand” mit “physischem Zustand” gleichzusetzen.
- Der Informationszustand, $I_t$, der die verwendeten Funktionen (wenn es eine Wahl gibt) sowie etwaige einstellbare Parameter enthält. $I_t$ könnte festlegen, wie wir Nachfragen prognostizieren, und die Parameter, die zur Anpassung der Prognose verwendet werden, zusätzlich zu allen anderen Parametern, die die Entwicklung des Systems steuern.
- Der Belief-Zustand, $B_t$, der Schätzungen oder Überzeugungen über Größen und Parameter enthält, die nicht perfekt bekannt sind. So könnte $B_t$ den geschätzten Mittelwert und die Varianz einer Normalverteilung erfassen (wie bei unserer obigen Nachfrageprognose). Alternativ könnte es sich um einen Vektor von Wahrscheinlichkeiten handeln, die sich im Zeitverlauf entwickeln.
Der physische Zustand $R_t$ könnte der Geldbetrag auf einem Kassenkonto sein, während $I_t$ der aktuelle Zustand der Aktien- und Anleihenmärkte sein könnte. Wenn wir uns über ein dynamisches Netzwerk bewegen, könnte $R_t$ unser Standort im Netzwerk sein, während $I_t$ das sein könnte, was wir über die Reisezeiten auf jeder Verbindung wissen. Wenn wir einen Pfad planen und dann Abweichungen vom Plan bestrafen möchten, würde der Plan durch $I_t$ in die Zustandsvariable einbezogen werden.
Zustandsvariablen sind typischerweise nicht offensichtlich. Sie entstehen während des Modellierungsprozesses, anstatt etwas zu sein, das man sofort niederschreiben kann. Nur weil wir sie zuerst schreiben, bedeutet das nicht, dass Sie immer sofort alle Elemente der Zustandsvariable auflisten können. Aber letztendlich ist dies der Ort, an dem Sie alle Informationen speichern, die Sie benötigen, um Ihr System ab dem Zeitpunkt $t$ zu modellieren.
Entscheidungsvariablen – Unterschiedliche Communities verwenden unterschiedliche Notationen für Entscheidungen, wie zum Beispiel $a_t$ für eine (typischerweise diskrete) Aktion oder $u_t$ für eine (typischerweise kontinuierliche) Steuerung im Ingenieurwesen. Wir verwenden $x_t$ als unseren Standard, da es von der Community der mathematischen Programmierung weit verbreitet verwendet wird.
Entscheidungsvariablen gibt es in verschiedenen Ausprägungen:
- Binär (z. B. zur Modellierung, ob ein Vermögenswert verkauft werden soll oder nicht, oder für A/B-Tests unterschiedlicher Webdesigns).
- Diskret (z. B. Wahl des Medikaments, welches Produkt beworben werden soll).
- Kontinuierlich skalar (Preise, Temperaturen, Konzentrationen).
- Vektoren (diskret oder kontinuierlich, wie etwa Zuweisungen von Blutkonserven an Krankenhäuser).
- Kategorial (z. B. welche Merkmale in einer Produktwerbung hervorgehoben werden sollen).
Wir stellen fest, dass es Algorithmenklassen gibt, die durch die Natur der Entscheidungsvariable bestimmt werden.
Wir gehen davon aus, dass Entscheidungen mit einer Politik getroffen werden, die wir $X^\pi(S_t)$ nennen könnten, wenn wir $x_t$ als unsere Entscheidung verwenden. Wir nehmen an, dass eine Entscheidung $x_t = X^\pi(S_t)$ zum Zeitpunkt $t$ zulässig ist, was $x_t \in \Xcal_t$ für eine bestimmte Menge (oder Region) $\Xcal_t$ bedeutet, die von $S_t$ abhängen kann.
Wir lassen “$\pi$” die Information über den Funktionstyp $f\in\Fcal$ (zum Beispiel ein lineares Modell mit bestimmten erklärenden Variablen) sowie etwaige einstellbare Parameter $\theta \in \Theta^f$ tragen.
Exogene Information – Wir bezeichnen mit $W_{t+1}$ jede neue Information, die zum Zeitpunkt $t+1$ erstmals bekannt wird (das heißt zwischen $t$ und $t+1$), wobei die Quelle der Information von außerhalb unseres Systems stammt (weshalb sie “exogen” ist). Bei der Modellierung spezifischer Variablen verwenden wir “Dachzeichen”, um exogene Information anzuzeigen. So könnte $\Dhat_{t+1}$ die Nachfrage sein, die zwischen $t$ und $t+1$ entsteht, oder wir könnten $\phat_{t+1}$ als die Preisänderung zwischen $t$ und $t+1$ festlegen.
Der exogene Informationsprozess kann stationär oder nichtstationär sein, rein exogen oder zustands- (und möglicherweise aktions-) abhängig (wenn wir uns entscheiden, viele Aktien zu verkaufen, könnte dies die Preise nach unten drücken).
Wir lassen $\omega$ einen Stichprobenpfad $W_1, \ldots, W_T$ darstellen, der eine Sequenz von Ergebnissen jedes $W_t$ repräsentiert. Häufig erstellen wir eine Menge $\Omega$ diskreter Stichproben, wobei jede Stichprobe eine bestimmte Sequenz der Ergebnisse unseres $W_t$-Prozesses darstellt, die wir als $W_1(\omega), \ldots, W_T(\omega)$ schreiben könnten. Wenn wir 20 Stichprobenpfade haben, können wir uns $\omega$ als eine Zahl zwischen 1 und 20 vorstellen, die es uns ermöglicht, den Stichprobenpfad nachzuschlagen.
Übergangsfunktion – Wir bezeichnen die Übergangsfunktion mit
\[\begin{align} S_{t+1} = S^M(S_t,x_t,W_{t+1}), \label{eq:transition} \end{align}\]wobei $S^M(\cdot)$ auch unter Namen wie Zustandsübergangsmodell, Systemmodell, Anlagenmodell, Anlagengleichung, Zustandsgleichung und Transferfunktion bekannt ist.
Gleichung $\eqref{eq:transition}$ ist die klassische Form einer Übergangsfunktion, die die Gleichungen vom Zustand $S_t$ zum Zustand $S_{t+1}$ angibt. Gleichung $\eqref{eq:inventoryexampleequation}$ war die einzige Übergangsgleichung für unser einfaches Bestandsbeispiel, während die Gleichungen $\eqref{eq:introcomplexinventorytransition1}$–$\eqref{eq:introcomplexinventorytransition6}$ die Übergangsfunktion für unser komplizierteres Beispiel bildeten.
Die Übergangsfunktion könnte jede der folgenden Arten von Aktualisierungen erfassen:
- Änderungen physischer Ressourcen, wie das Hinzufügen von Bestand, das Verschieben von Personen oder das Modifizieren von Ausrüstung.
- Aktualisierungen von Informationen, wie Änderungen bei Preisen und Wetter.
- Aktualisierungen unserer Überzeugungen über unsichere Größen oder Parameter.
Die Übergangsfunktion kann eine bekannte Menge von Gleichungen sein oder unbekannt, wie zum Beispiel wenn wir menschliches Verhalten oder die Entwicklung von CO2 in der Atmosphäre beschreiben. Wenn die Gleichungen unbekannt sind, wird das Problem oft als “modellfrei” oder “datengetrieben” bezeichnet, was bedeutet, dass wir nur Änderungen einer Variable beobachten können, anstatt ein physisches Modell zu verwenden. Gleichung $\eqref{eq:introcomplexinventorytransition6}$, bei der wir die Kosten $c_{t+1} = \chat_{t+1}$ “beobachten”, ohne eine Vorstellung davon zu haben, wie wir uns von $c_t$ entwickelt haben, ist ein Beispiel für einen modellfreien Übergang.
Übergangsfunktionen können linear, kontinuierlich nichtlinear oder Stufenfunktionen sein. Wenn der Zustand $S_t$ einen Belief-Zustand $B_t$ enthält, muss die Übergangsfunktion die Aktualisierungsgleichungen enthalten (wir veranschaulichen dies später im Buch).
Gegeben eine Politik $X^\pi(S_t)$, einen exogenen Prozess $W_{t+1}$ und eine Übergangsfunktion, können wir unsere Sequenz von Zuständen, Entscheidungen und Informationen schreiben als
\[(S_0, x_0, W_1, S_1, x_1, W_2, \ldots, x_{T-1}, W_T, S_T).\]Zielfunktionen – Es gibt eine Reihe von Möglichkeiten, Zielfunktionen zu schreiben. Eine der gebräuchlichsten, die wir als Standard verwenden werden, maximiert die gesamten erwarteten Beiträge über einen Horizont $t=0, \ldots, T$
\[\begin{align} \max_{\pi=(f,\theta)} F^\pi(S_0) = \E \left\{\sum_{t=0}^T C_t(S_t,X^\pi_t(S_t\vert \theta))\vert S_0\right\}, \label{eq:objectivecumulativereward} \end{align}\]wobei
\[\begin{align} S_{t+1} = S^M(S_t,X^\pi_t(S_t),W_{t+1}). \label{eq:basetransition} \end{align}\]Das Modell ist vollständig spezifiziert, wenn wir außerdem ein Modell des Anfangszustands $S_0$ und ein Modell des exogenen Prozesses $W_1, W_2, \ldots$ haben. Wir schreiben alle exogenen Informationen als
\[\begin{align} (S_0, W_1, W_2, \ldots, W_T). \label{eq:basestochasticmodel} \end{align}\]Die Gleichungen $\eqref{eq:objectivecumulativereward}$, $\eqref{eq:basetransition}$ und $\eqref{eq:basestochasticmodel}$ bilden ein Modell eines sequentiellen Entscheidungsproblems.
Im weiteren Verlauf werden wir der Kürze halber $\max_\pi$ verwenden, um eine Suche über die Funktionstypen $f\in\Fcal$ und einstellbaren Parameter $\theta\in\Theta^f$ darzustellen.
Gleichung $\eqref{eq:objectivecumulativereward}$ verwendet einen Erwartungswert $\E$, was bedeutet, einen Durchschnitt über alle möglichen Ergebnisse von $W_1, \ldots, W_T$ zu bilden. Dies ist rechnerisch praktisch nie möglich. Stattdessen sei $\omega$ ein einzelnes Ergebnis der Sequenz $W_1, \ldots, W_T$, das wir als $W_1(\omega), \ldots, W_T(\omega)$ schreiben könnten. Nehmen wir an, wir können $N$ mögliche Ergebnisse dieser Sequenz erzeugen, und sei $\omega^n$ die Art und Weise, wie wir die $n^{th}$-Sequenz indizieren.
Wenn wir einem Stichprobenpfad $\omega$ folgen, würden wir unsere Übergangsfunktion in $\eqref{eq:basetransition}$ mit
\[\begin{align} S_{t+1}(\omega) = S^M(S_t(\omega),X^\pi_t(S_t(\omega)),W_{t+1}(\omega)). \label{eq:basetransition2} \end{align}\]umschreiben.
Wir indizieren jede Variable in Gleichung $\eqref{eq:basetransition2}$ mit $\omega$, um anzuzeigen, dass wir einem einzelnen Stichprobenpfad von Werten von $W_t$ folgen.
Wir können nun unsere erwartungswertbasierte Zielfunktion durch einen Durchschnitt ersetzen, den wir schreiben können als
\[\begin{align} \max_\pi \Fbar^\pi(S_0) = \frac{1}{N}\sum_{n=1}^N \sum_{t=0}^T C_t(S_t(\omega^n),X^\pi_t(S_t(\omega^n))). \label{eq:objectivecumulativerewardaverage} \end{align}\]Häufig arbeiten wir nur mit einem einzigen Stichprobenpfad, möglicherweise aus der Historie. In diesem Fall approximieren wir die Performance der Politik anhand dieses einzelnen Stichprobenpfads, was wir schreiben können als
\[\begin{align} \max_\pi \Fhat^\pi(\omega\vert S_0) = \sum_{t=0}^T C_t(S_t(\omega),X^\pi_t(S_t(\omega))). \label{eq:objectivecumulativerewardsample} \end{align}\]Immer wenn wir eine Zielfunktion mit einem Erwartungswert wie in $\eqref{eq:objectivecumulativereward}$ schreiben, sollten wir bedenken, dass wir in der Praxis tatsächlich einen Durchschnitt verwenden würden, wie wir es in $\eqref{eq:objectivecumulativerewardaverage}$ tun, oder eine Stichprobe wie in $\eqref{eq:objectivecumulativerewardsample}$.
Der Erwartungswert muss möglicherweise auch die Unsicherheit im Anfangszustand $S_0$ widerspiegeln, die Überzeugungen über unsichere Prognosen oder unsichere Schätzungen über den Krankheitszustand eines Patienten erfassen könnte. In diesem Fall muss der Stichprobenpfad $\omega$ Stichproben aus diesen Anfangsverteilungen enthalten.
Es gibt Situationen, in denen es sinnvoller ist, einen Zähler $n$ statt der Zeit zu verwenden. In diesem Fall lassen wir $S^n$ den Zustand nach $n$ Beobachtungen sein (dies können Experimente, Kundenankünfte oder Iterationen eines Algorithmus sein). Wir werden die Zeit $t$ als unseren Standardindex verwenden.
Die Anfangszustandsvariablen $S_0$
Wir müssen zwischen dem Anfangszustand $S_0$ und nachfolgenden Zuständen $S_t$ für $t > 0$ unterscheiden:
- $S_0$ – Der Anfangszustand $S_0$ erfasst i) deterministische Parameter, die sich nie ändern, ii) Anfangswerte von Größen oder Parametern, die sich ändern (möglicherweise aufgrund von Entscheidungen), und iii) Überzeugungen über Größen oder Parameter, die wir nicht perfekt kennen (dies könnten die Parameter einer Wahrscheinlichkeitsverteilung sein), etwa wie wir auf einen Impfstoff reagieren oder wie der Markt auf einen Preis reagieren wird. Die Überzeugungen können statisch bleiben, oder wir aktualisieren sie, während wir aus Beobachtungen lernen.
- $S_t$ – Dies sind alle Informationen, die wir zur Zeit $t$ aus der Historie benötigen, um das System ab Zeitpunkt $t$ zu modellieren. $S_t$ für $t > 0$ enthält nur Variablen, die sich über die Zeit verändern, was bedeutet, dass wir zur Zeit $t$ möglicherweise auch statische Informationen verwenden, die in $S_0$ enthalten sind.
Wir schreiben die explizite Abhängigkeit der Performance der Politik vom Anfangszustand $S_0$, unabhängig davon, ob wir $F^\pi(S_0)$, $\Fbar^\pi(S_0)$ oder $\Fhat^\pi(\omega\vert S_0)$ verwenden. Obwohl dies offensichtlich sein sollte, wird es oft übersehen. Der Anfangszustand umfasst Elemente wie:
- Anfangswerte der Mengen physischer oder finanzieller Ressourcen $R_0$ – Dies könnten Anfangsbestände, der Anfangsstandort eines Fahrzeugs, die verfügbaren Maschinen und der Anfangsbestand an Anlagen sein. Dazu gehören auch statische Werte, wie etwa ein Transportnetzwerk, die Größe eines Lagers (die sich nicht ändert) und die Anzahl der Lastwagen in einer Flotte.
- Anfangswerte von Parametern zusammen mit allen Funktionen, die zur Modellierung des Problems verwendet werden $I_0$ – Dies könnte ein Anfangspreis sein, der Medikationsspiegel bei einem Patienten, zusammen mit der Wahl der Funktionen zur Durchführung von Prognosen oder zur Modellierung der Krankheitsentwicklung in einer Bevölkerung.
- Anfängliche Überzeugungen oder Schätzungen jeder Größe oder jedes Parameters $B_0$ – Dies könnte eine Nachfrageprognose sein, die Schätzung, wie Märkte auf Preise reagieren, wie ein Präsidentschaftskandidat in Umfragen abschneidet, oder Überzeugungen über die Leistung eines Fertigungsprozesses.
Wir weisen darauf hin, dass es hilfreich ist, Anfangswerte, die sich nie ändern, von solchen zu trennen, die sich im Laufe der Zeit entwickeln, entweder direkt als Ergebnis von Entscheidungen oder aufgrund exogener Information. Werte, die sich nie ändern, werden in $S_0$ gespeichert, sind aber nicht in $S_t$ für $t > 0$ dargestellt. Der Grund dafür ist der Wunsch, $S_t$ so kompakt wie möglich zu halten.
Angenommen, unsere Politik $X^\pi(S_t\vert \theta)$ hat abstimmbare Parameter. Zum Beispiel könnten wir ein Bestandssystem verwalten, bei dem wir die bekannte “Order-up-to”-Politik verwenden (in der Bestandsliteratur als $(s,S)$-Politik bekannt), gegeben durch
\[X^\pi(S_t\vert \theta) = \begin{cases} \theta^{max} - R_t & R_t < \theta^{min},\\ 0 & \text{otherwise.}\end{cases}\]wobei $\theta = (\theta^{min},\theta^{max})$. Der Einfachheit halber könnten wir annehmen, dass eine Bestellung sofort eintrifft (eine Standardannahme aus Lehrbüchern, die in der Praxis nie zutrifft), was es uns erlaubt, die Entwicklung unseres physischen Zustands $R_t$ (die Menge im Bestand kurz bevor wir unsere sofortige Bestellung aufgeben) zu schreiben mit
\[R_{t+1} = \max\{0,R_t + x_t - \Dhat_{t+1}\}\]wobei $x_t = X^\pi(S_t\vert \theta)$ und $\Dhat_{t+1}$ die Nachfrage nach unserem Produkt über das Intervall $(t,t+1)$ ist (dies ist unsere exogene Information $W_{t+1}$). Schließlich sei $C(S_t,x_t,W_{t+1})$ unser Nettogewinn über das Intervall $(t,t+1)$ (was im Moment nicht wichtig ist).
Stellen wir uns nun vor, dass wir einen historischen Nachfrageprozess $W_1, W_2, \ldots, W_t, \ldots, W_T$ haben, der es uns ermöglicht, eine Simulation unseres Systems durchzuführen. Sei $\omega$ diese historische Sequenz von Nachfragen (oder jede exogene Information) darstellend. Wir würden das Problem, den besten Satz von Bestellparametern $\theta$ zu finden, schreiben mit
\[\begin{align} \max_\theta \Fhat^\pi(\omega,\theta\vert S_0) = \sum_{t=0}^T C_t(S_t(\omega),X^\pi_t(S_t(\omega))), \label{eq:optimizingtheta} \end{align}\]wobei die Zustandsvariable sich entwickelt gemäß
\[S_{t+1}(\omega) = S^M(S_t(\omega), X^\pi_t(S_t(\omega)), W_{t+1}(\omega)).\]Sei $\theta^\ast $ der Wert von $\theta$, den wir durch die Optimierung von $\eqref{eq:optimizingtheta}$ gefunden haben. Die korrekte Art, diesen optimalen Wert zu schreiben, ist als Funktion $\theta^\ast (S_0)$, die von den Informationen in $S_0$ abhängt (sie hängt auch vom Stichprobenpfad $\omega$ ab). Dies hilft dabei, die Tatsache zu vermitteln, dass wenn wir die Eingabedaten unseres Problems ändern, dargestellt durch $S_0$, dies Auswirkungen auf die besten Werte unserer Politikparameter $\theta$ haben kann. Tatsächlich müssten wir möglicherweise sogar unsere Wahl der Politik ändern!
Variationen
Es gibt zwei wichtige Variationen unseres grundlegenden mathematischen Modells:
-
Von der Zeit $t$ zur Iteration $n$ – Es gibt Problemstellungen, in denen es natürlicher ist, einen Zähler $n$ statt der Zeit $t$ zu verwenden. Wir tun mehr, als nur $t$ in $n$ zu ändern, da wir Variablen, die sich mit Iterationen ändern, anders betrachten als eine Entwicklung über die Zeit. Konkret setzen wir den Index $n$ in den hochgestellten Index, wie $S^n$, $x^n$ und $W^{n+1}$.
Ein Grund dafür ist, dass wir eine Menge von Variablen über die Zeit $x_1, x_2, \ldots, x_t, \ldots, x_T$ als Vektor $x=(x_1, x_2, \ldots, x_t, \ldots, x_T)$ betrachten, was nützlich ist, wenn deterministische Probleme modelliert werden (wir könnten über den gesamten Vektor $x$ auf einmal optimieren). Im Gegensatz dazu betrachten wir $x^n$ als eine Funktion, die sich über die Zeit entwickelt.
Praktischer ausgedrückt erlaubt es uns, $n$ in den hochgestellten Index zu setzen, iterative Simulationen zu schreiben. Wir würden also den Informationsprozess über die Zeit für Iteration $n$ schreiben mit
Wenn wir iterativ nach der besten Politik suchen, könnten wir unsere Politik für Iteration $n$ mit $X^{\pi,n}(S_t)$ schreiben, was dann Folgendes ergibt
\[S^n_0, x^n_0, W^n_1, \ldots, S^n_t, x^n_t, W^N_{t+1}, \ldots, S^N_T,\]wobei $x^n_t = X^{\pi,n}(S^n_t\vert \theta)$.
-
Optimierung der Endbelohnung – Eine häufige Situation ist die, in der wir eine stochastische Suche durchführen, wie es bei der Suche nach der besten Politik der Fall wäre. Jede Iteration zur Bewertung des Algorithmus erfordert möglicherweise eine Simulation über die Zeit, obwohl dies nicht immer der Fall ist.
Nehmen wir nun an, dass unsere Entscheidungsvariable der Parameter $\theta$ ist, und dass wir einen Algorithmus $\Theta^\pi(S^{\theta,n})$ haben, der genau wie eine Politik $X^\pi(S_t\vert \theta)$ funktioniert, wobei $S^{\theta,n}$ den “Zustand” des Algorithmus bei der $n$-ten Iteration erfasst.
Suchalgorithmen sind alle sequentielle Entscheidungsprobleme, aber im Gegensatz zu den meisten sequentiellen Entscheidungsproblemen über die Zeit möchten wir $N$ Iterationen durchlaufen und interessieren uns nur für unsere Lösung am Ende. Sei $\theta^{\pi,N}$ der Wert von $\theta^n$ nach $N$ Iterationen, während wir dem “Algorithmus” (der Politik) $\pi$ folgen.
Der Wert $\theta^{\pi,N}$ hängt von der spezifischen Sequenz unseres Informationsprozesses $W^1, \ldots, W^t, \ldots, W^N$ ab, aber wir müssen ihn dann anhand eines neuen Satzes von Stichproben bewerten, die wir $\What$ nennen werden.
Wir bewerten die Performance unseres Algorithmus anhand einer Endbelohnungs-Zielfunktion, die wir schreiben als
Einfach ausgedrückt bewerten wir unsere Lernpolitik für $\theta$, die wir $\Theta^\pi(S^{\theta,N})$ genannt haben, indem wir durch $N$ Iterationen mittels Beobachtungen von $W^n$ simulieren (dies könnte eine gesamte Simulation über die Zeit $t$ sein). Wenn wir unsere endgültige Schätzung des Parameters $\theta$ erhalten, den wir $\theta^{\pi,N}$ nennen, bewerten wir die Performance dieses Werts anhand einer separaten Simulation, bei der wir $\theta = \theta^{\pi,N}$ fixieren und dann einen neuen Satz zufälliger Beobachtungen erzeugen, den wir $\What^m$ für $m=1, \ldots, M$ nennen.
Modellierung von Unsicherheit
Bei vielen komplexen Problemen (Lieferketten, Energiesysteme und öffentliche Gesundheit sind nur einige Beispiele) kann die Identifizierung und Modellierung der verschiedenen Formen von Unsicherheit eine umfangreiche und komplexe Übung sein. Wir werden auf die auftretenden Fragen hinweisen, aber wir werden keine erschöpfende Diskussion dieser Dimension versuchen.
Unsicherheit wird unserem Modell über zwei Mechanismen vermittelt: den Anfangszustand $S_0$, in dem wir die Parameter von Wahrscheinlichkeitsverteilungen modellieren würden, die Größen und Parameter beschreiben, die wir nicht perfekt kennen, und den exogenen Informationsprozess $W_1, \ldots, W_T$.
Unsicherheit im Anfangszustand
Die Anfangszustandsvariable kann deterministische Parameter oder Anfangswerte dynamisch variierender Größen und Parameter enthalten. Wenn dies alles ist, was im Anfangszustand enthalten ist, dann erfasst er keine Form von Unsicherheit.
Es gibt viele Probleme, bei denen wir bestimmte Größen oder Parameter nicht kennen, aber das, was wir wissen, durch die Parameter einer Wahrscheinlichkeitsverteilung darstellen können. Einige Beispiele sind:
- Die Reaktion eines Patienten auf ein neues Medikament.
- Wie ein Markt auf eine Preisänderung reagieren wird.
- Wie viele verkaufsfähige Salatköpfe wir im Bestand haben (eine unsichere Anzahl könnte verwelkt sein und ist nicht mehr verkaufsfähig).
- Der Zeitpunkt, zu dem eine zuvor aus China bestellte Bestandskiste eintreffen wird.
- Die Höhe der Einzahlungen in einen Investmentfonds variiert zufällig um einen Mittelwert $\lambda$, aber wir wissen nicht, was $\lambda$ ist.
Dies sind einige Möglichkeiten, wie wir ein Modell mit Unsicherheit in einigen der Eingaben initialisieren können.
Eine anfängliche probabilistische Überzeugung kann aus subjektivem Urteil oder aus früheren Beobachtungen oder Experimenten stammen.
Der exogene Informationsprozess
Der zweite Weg, wie Unsicherheit in unser Modell eingeht, ist der exogene Informationsprozess. Die Variable $W_t$ enthält Informationen, die erst zum Zeitpunkt $t$ bekannt werden. Das bedeutet, dass wir eine Entscheidung $x_t$ zur Zeit $t$ treffen müssen, bevor wir das Ergebnis von $W_{t+1}$ kennen.
Nachfolgend eine Liste von Beispielen für $W_{t+1}$, die nach einer Entscheidung $x_t$ offenbart werden:
- Wir wählen einen Pfad und beobachten dann die Reisezeit auf dem Pfad.
- Wir wählen ein Medikament und beobachten dann, wie der Patient reagiert.
- Wir wählen einen Katalysator und beobachten dann die Festigkeit des Materials, das er erzeugt.
- Wir wählen ein Produkt für die Werbung auf einem Online-Markt und beobachten dann die Verkäufe.
- Wir wählen ein Webinterface-Design aus und beobachten dann die Anzahl der Klicks, die es generieren kann.
- Wir weisen Mittel einer Investition zu und beobachten dann die Veränderung des Preises der Investition.
In jedem Fall wirkt sich die Information, die wir nach der Entscheidung beobachten, auf die Performance der Entscheidung aus (und darauf, welche Entscheidung die beste gewesen wäre).
Der Leser hat inzwischen wahrscheinlich erkannt, dass $W_{t+1}$ üblicherweise eine Sammlung verschiedener Arten von Information ist. Stellen wir uns beispielsweise vor, dass wir einen Patienten mit erhöhtem Blutzucker behandeln. Der Arzt möchte mit verschiedenen Strategien experimentieren, von Diät und Bewegung über Medikamente zur Gewichtsreduktion bis hin zu Medikamenten, die speziell auf den Blutzucker abzielen. Die Informationsquellen, die der Arzt verarbeiten muss, könnten Folgendes umfassen:
- Bereitschaft des Patienten, eine Diät zu machen.
- Compliance des Patienten mit den Diätanweisungen.
- Bereitschaft des Patienten, tägliche Injektionen zur Gewichtsreduktion zu akzeptieren.
- Tatsächlicher Gewichtsverlust (aus jedem Programm).
- Tatsächliche Veränderung des Blutzuckers.
Jede dieser Größen ist ein separater Informationsfluss. Wir können diese modellieren, indem wir die Menge $\Ical_t$ einführen, die Menge der Informationsprozesse zur Zeit $t$ (die Menge kann sich ändern, wenn wir Strategien ändern, wodurch neue Informationsflüsse eröffnet werden). Wir können nun die verschiedenen Ausprägungen von Information mit $W_{t+1,i}$ ausdrücken, der Realisierung der Information aus Quelle $i\in\Ical_t$, sodass $W_{t+1} = (W_{t+1,i})_{i\in\Ical_t}$.
Wir werden weiterhin $W_{t+1}$ verwenden, um die neu eintreffende Information darzustellen, aber der Leser muss bedenken, dass dies in realen Anwendungen typischerweise eine gesamte Menge von Informationsquellen umfasst, jede mit ihrem eigenen Verhalten.
Zustands-/entscheidungsabhängige Prozesse
Es gibt viele Anwendungen, bei denen die Information $W_{t+1}$ vom aktuellen Zustand $S_t$ und/oder der Entscheidung $x_t$ abhängt. Einige Beispiele umfassen:
- Ein Mangel an Bestand kann Kunden abschrecken und die Nachfrage verringern.
- Der Kauf einer großen Menge an Aktien kann deren Preise erhöhen.
- Die Entscheidung, Impfstoffe zu empfehlen, kann den Verlauf einer Krankheit beeinflussen.
- Die Anzahl der online verfügbaren Stromgeneratoren kann die Strompreise im Netz verändern.
Aus diesem Grund ist es hilfreich, die exogene Information als Funktion $W_{t+1}(S_t,x_t)$ darzustellen, der Funktion der exogenen Information, die die im Intervall $(t,t+1)$ eintreffende Information angibt.
Stellen wir uns beispielsweise vor, dass wir Aktien in großen Mengen kaufen oder verkaufen, was den zukünftigen Preis beeinflussen könnte. Die Dynamik könnte wie folgt geschrieben werden
\[\begin{align} p_{t+1} = \theta^p_0 p_t + \theta^p_1 p_{t-1} + \theta^p_2 p_{t-2} + W_{t+1}(S_t,x_t). \label{eq:statedependentprice} \end{align}\]Der Zustand dieses Preisprozesses würde geschrieben als
\[S_t = (p_t, p_{t-1}, p_{t-2}).\]Die zufällige Preisänderung, gegeben durch $W_{t+1}(S_t,x_t)$, spiegelt unsere Annahme wider, dass die Preisänderung sowohl vom aktuellen Preis abhängen könnte (wenn der Preis hoch ist, sind zukünftige Änderungen wahrscheinlich negativ) als auch von der Menge, die wir kaufen ($x_t > 0$) oder verkaufen ($x_t < 0$).
Natürlich möchten wir historische Daten nutzen, um zu versuchen, jeden strukturellen Einfluss von $S_t$ und $x_t$ auf zukünftige Preise vom wirklich exogenen Rauschen zu trennen. Daher könnten wir ein Modell vorschlagen
\[W_{t+1}(S_t,x_t) = \theta^x x_t + \varepsilon_{t+1},\]wobei wir annehmen könnten, dass
\[\varepsilon_{t+1} \sim N(0, \vert x_t\vert \sigma^2_t),\]Dieses Modell nimmt an, dass $\varepsilon_{t+1}$ den Mittelwert 0 hat und eine Varianz, die mit dem Absolutwert von $x_t$ wächst. Die Information $W_{t+1}(S_t,x_t)$ hätte dann einen Mittelwert von $\theta^x x_t$, der positiv ist, wenn wir Anteile kaufen ($x_t > 0$), und negativ, wenn wir an den Markt verkaufen ($x_t < 0$).
Dieses Buch wird weiterhin $W_{t+1}$ als Standardnotation verwenden, aber der Leser sollte sich bewusst sein, dass sie vom aktuellen Zustand und/oder der bei gegebenem Zustand getroffenen Entscheidung abhängen kann.
Arten der Unsicherheit
Die Identifizierung der Informationstypen ist der erste Schritt zum Verständnis von Unsicherheit. Der nächste Schritt besteht darin, die unterschiedlichen Arten von Unsicherheit zu charakterisieren. Eine Zusammenfassung einiger der wichtigsten Verhaltensweisen, die Informationsprozesse zeigen können, umfasst:
- Feinkörnige Variabilität – Diese kann auf Zeitskalen von Sekunden (sogar Sekundenbruchteilen), Minuten, Stunden oder täglich auftreten.
- Verschiebungen – Die feinkörnige Variabilität eines Prozesses stellt typischerweise Schwankungen um einen Mittelwert dar, aber es gibt Zeiten, in denen sich der Mittelwert periodisch auf ein neues Niveau verschiebt. Dies könnte neue Technologie, Anpassungen von Wettbewerbern oder Veränderungen in der Wirtschaft widerspiegeln.
- Ausbrüche und intermittierende Nachfragen – Die Ausbreitung von Krankheiten kann einen Anstieg von Infektionen verursachen, da sich Ausbrüche lokal ausbreiten können. Ein Kunde könnte ein Produkt aufgreifen und es seinen Freunden empfehlen, die es dann ihren Freunden weitersagen.
- Spitzen – Ein herannahender Schneesturm kann einen sprunghaften Anstieg der Nachfrage nach Milch, Eiern und Toilettenpapier verursachen; der Ausfall eines Stromgenerators kann einen Spitzenwert bei den Strompreisen verursachen.
- Räumliche Ereignisse – Wetter, Krankheiten und Änderungen von Vorschriften können zufällige Änderungen verursachen, die regionaler Natur sind.
- Systemische Ereignisse – Dies sind Ereignisse, die ein ganzes Unternehmen (über internationale Grenzen hinweg), ein ganzes Land oder sogar globale Auswirkungen haben können. Dies könnte durch einen Cyberangriff auf die Kommunikation, Veränderungen in der öffentlichen Wahrnehmung und negative Werbung entstehen.
- Seltene Ereignisse – Seltene Ereignisse können aus einer Reihe von Quellen entstehen, wie Erdbeben, Krankheitsausbrüche oder Terroranschläge. Dies sind tendenziell Ereignisse, die recht selten auftreten, aber, wenn sie eintreten, erhebliche Auswirkungen auf eine Organisation haben können.
- Eventualitäten – Diese Kategorie bezieht sich auf Ereignisse, die passieren könnten, für die es aber keine Historie gibt. Zum Beispiel planen Netzbetreiber für den Ausfall von Kernkraftwerken. Auch wenn dies in einem Land möglicherweise nie geschehen ist, möchte sich der Netzbetreiber dennoch auf das Ereignis vorbereiten, falls es eintritt.
Diese Verhaltensweisen können sich auf die Wahl der Politik zur Entscheidungsfindung auswirken, ein Thema, mit dem wir uns als Nächstes befassen.
Unsicherheit wird weithin als ein Problem anerkannt, für das Unternehmen, Organisationen und sogar Regierungen planen müssen. Oft wird übersehen, dass der Grund für die Modellierung von Unsicherheit darin besteht, zu verstehen, wie sie sich auf Entscheidungen auswirkt. Unsicherheit ist immer mit Informationsprozessen verbunden, die in der Zukunft eintreffen, sodass wir darüber nachdenken müssen, wie eine jetzt getroffene Entscheidung von dieser zukünftigen Information beeinflusst wird.
Gestaltung von Politiken
Eine Politik ist eine Methode zur Entscheidungsfindung … jede beliebige Methode.
Politiken sind Funktionen, die die Information in der Zustandsvariable nutzen, um eine Entscheidung zu treffen. Dies klingt nach einem gut definierten Problem; schließlich baut die Machine-Learning-Gemeinschaft vollständig auf der Herausforderung auf, Funktionen zu finden, die zu einem Trainingsdatensatz passen. Die Gestaltung von Politiken ist jedoch viel vielschichtiger, wie die Vielfalt der Gemeinschaften belegt, die auf diesem Gebiet arbeiten.
Abbildung 1.2 zeigt die Titelseiten von Büchern, die etwa 15 verschiedene Fachgebiete repräsentieren, die sich alle mit sequentiellen Entscheidungen unter Unsicherheit befassen. Sie verwenden acht verschiedene Notationssysteme und grundlegend unterschiedliche Ansätze bei der Modellierung. Manche verwechseln Politiken (die eingebettete Optimierungsprobleme beinhalten) mit Zielfunktionen.
Leistungskennzahlen für Politiken
Die deterministische Optimierung wird durch eine Zielfunktion charakterisiert, die bestimmt, ob eine Entscheidung besser ist als eine andere. Bei sequentiellen Entscheidungsproblemen werden wir typischerweise eine Zielfunktion haben, die die Leistung einer Politik bewertet, wie wir es mit den Gleichungen $\eqref{eq:objectivecumulativereward}$, $\eqref{eq:objectivecumulativerewardaverage}$ und $\eqref{eq:objectivecumulativerewardsample}$ getan haben.
In der Praxis werden Politiken jedoch anhand einer Reihe konkurrierender Kriterien ausgewählt:
- Lösungsqualität – Wir betrachten typischerweise die Leistung (z. B. Kosten, Gewinne, Gesundheitsergebnisse) über einen bestimmten Zeitraum, wie in der gestichprobten Version des Ziels in Gleichung $\eqref{eq:objectivecumulativerewardsample}$ ausgedrückt. Da dies zufällig ist, müssen wir die durchschnittliche Leistung und die Worst-Case-Leistung berücksichtigen.
- Rechenanforderungen – In operativen Umgebungen sind Laufzeiten wichtig. Wie beim Ziel ist die Zeit, die zur Berechnung einer Politik benötigt wird, zufällig, sodass wir die durchschnittliche Ausführungszeit und die Worst-Case-Ausführungszeit berücksichtigen müssen.
- Transparenz – Wie leicht sich eine Entscheidung auf Eingabedaten zurückführen lässt, die Fehler enthalten könnten.
- Flexibilität/Anpassungsfähigkeit – Reale Probleme können kompliziert sein, und wir müssen uns oft an komplexe Situationen anpassen.
- Methodische Komplexität – Wenn eine Politik beispielsweise von einer internen Analytikgruppe implementiert wird, müssen diese die Wahrscheinlichkeit berücksichtigen, dass sie eine Methode tatsächlich zum Funktionieren bringen können.
- Datenanforderungen – Verschiedene Politiken haben unterschiedliche Datenanforderungen.
Die in Abbildung 1.2 dargestellten mathematischen Optimierungsgemeinschaften sprechen möglicherweise von optimalen Politiken, was die Optimierung des Erwartungswerts in Gleichung $\eqref{eq:objectivecumulativereward}$ impliziert. Es ist jedoch wichtig, auf all diese Eigenschaften zu achten.
Die vier Klassen von Politiken
Die Bücher in Abbildung 1.2 zeigen eine Vielzahl von Möglichkeiten, im Laufe der Zeit Entscheidungen zu treffen. Es stellt sich heraus, dass sie sich alle in gut definierte Klassen von Politiken einteilen lassen. Es gibt zwei grundlegende Strategien zur Erstellung von Politiken, von denen jede weiter in zwei Klassen unterteilt werden kann, wodurch vier Klassen von Politiken entstehen:
Politiksuche – Hierbei durchsucht man Methoden (Funktionen) zur Entscheidungsfindung und simuliert deren Leistung (wie wir es in Gleichung $\eqref{eq:objectivecumulativereward}$ tun), um die Methode zu finden, die im Durchschnitt über die Zeit am besten funktioniert. Dies kann die Suche über verschiedene Methodenklassen sowie über beliebige abstimmbare Parameter für eine gegebene Methode umfassen. Diese Idee eröffnet zwei Klassen von Politiken:
- 1) Politikfunktionsapproximationen (PFAs) – Dies sind analytische Funktionen eines Zustands, die direkt eine Aktion angeben. Die Bestell-bis-Politik in Gleichung $\eqref{eq:introorderupto}$ ist ein gutes Beispiel, ebenso wie unsere Politik der Verwendung einer angepassten Prognose in Gleichung $\eqref{eq:adjustedforecastpolicy}$.
- 2) Kostenfunktionsapproximationen (CFAs) – Dies sind Politiken, die das Lösen eines Optimierungsproblems beinhalten, das typischerweise eine Vereinfachung des ursprünglichen Problems darstellt, wobei Parameter eingeführt werden, um die Politik im Laufe der Zeit besser funktionieren zu lassen. Dies ist eine besonders leistungsfähige Idee, die in der Industrie weit verbreitet ist. Wir haben später im Buch mehrere Illustrationen von CFAs (beginnend mit Kapitel 4, um die beste Medikation für Diabetes zu erlernen).
Lookahead-Politiken – Wir können effektive Politiken erstellen, indem wir über den Beitrag (oder die Kosten) einer Entscheidung plus einer Approximation der nachgelagerten Beiträge (oder Kosten), die sich aus der jetzt getroffenen Entscheidung ergeben, optimieren. Auch hier können wir diese in zwei weitere Klassen von Politiken unterteilen:
- 3) Wertfunktionsapproximationen (VFAs) – Stellen wir uns vor, wir durchqueren ein in Abbildung 1.3 dargestelltes Netzwerk, in dem wir einen Pfad von Knoten 1 zu Knoten 11 finden möchten. Stellen wir uns nun vor, wir befinden uns an Knoten $S_t = i = 2$, wobei $t$ zählt, wie viele Verbindungen wir durchquert haben. Sei $V_{t+1}(S_{t+1})$ der Wert (unter der Annahme, dass wir maximieren) des Pfades von Knoten $S_{t+1}$ (wie zum Beispiel Knoten 4 oder 5) zu Knoten 11 (machen Sie sich keine Sorgen darüber, wie wir $V_{t+1}(S_{t+1})$ erhalten haben). Sei eine Entscheidung $x_t$ die Verbindung, die wir aus Knoten $S_t = i$ heraus durchqueren. Der Wert, sich an Knoten $S_t$ zu befinden, wäre gegeben durch
Gleichung $\eqref{eq:bellmangraph}$ ist bekannt als Bellman-Gleichung. Wenn sie verwendet wird, um den besten Pfad in einem deterministischen Netzwerk wie dem in Abbildung 1.3 dargestellten zu finden, lässt sie sich recht leicht visualisieren.
Es gibt viele Probleme, bei denen der Übergang vom Zustand $S_t$ zu $S_{t+1}$ zufällige Information beinhaltet, die zum Zeitpunkt $t$ nicht bekannt ist. Wir haben ein einfaches Beispiel für Zufälligkeit in unserem ersten Bestandsproblem gesehen und ein komplizierteres Beispiel in unserem zweiten Bestandsproblem.
Für diese allgemeineren Probleme gilt: Wenn wir uns in einem Zustand $S_t$ befinden, eine Entscheidung $x_t$ treffen und dann neue Information $W_{t+1}$ beobachten (die zum Zeitpunkt $t$ nicht bekannt ist), führt uns dies gemäß unserer Übergangsfunktion zu einem neuen Zustand $S_{t+1}$
\[S_{t+1} = S^M(S_t,x_t,W_{t+1}).\]Das bedeutet, dass zum Zeitpunkt $t$, wenn wir $x_t$ wählen müssen, $W_{t+1}$ eine Zufallsvariable ist, was wiederum bedeutet, dass auch $S_{t+1}$ eine Zufallsvariable ist. In diesem Fall müssen wir einen Erwartungswert in die Bellman-Gleichung einfügen und Gleichung $\eqref{eq:bellmangraph}$ schreiben als
\[\begin{align} V_t(S_t) = \max_{x_t} \big(C(S_t,x_t) + \E_{W_{t+1}} \left\{V_{t+1}(S_{t+1})\vert S_t,x_t\right\}\big). \label{eq:bellmanstochastic} \end{align}\]Hier haben wir den Erwartungswert $\E_{W_{t+1}}\lbrace \cdot\rbrace $ eingefügt, was buchstäblich bedeutet, über alle zufälligen Ausgänge von $W_{t+1}$ zu mitteln.
Die stochastische Version der Bellman-Gleichung in $\eqref{eq:bellmanstochastic}$ ist äußerst allgemein. Der Zustand $S_t$ bedeutet nicht nur einen Knoten in einem Graphen; er erfasst jede (und alle) für das Problem relevante Information. Die Schwierigkeit besteht darin, dass wir die Wertfunktion $V_t(S_t)$ nicht mehr berechnen können, was wiederum bedeutet, dass wir keinen Zugriff auf $V_{t+1}(S_{t+1})$ haben werden, von dem wir in den Gleichungen $\eqref{eq:bellmangraph}$ und $\eqref{eq:bellmanstochastic}$ angenommen hatten, dass wir es kennen.
Die Strategie, die die Forschungsgemeinschaft beim Versuch, die Bellman-Gleichung anzuwenden, verfolgt hat, besteht darin, auf das Gebiet des maschinellen Lernens zurückzugreifen, um eine statistische Approximation zu schätzen, die wir $\Vbar_t(S_t)$ nennen werden. Unter der Annahme, dass wir eine vernünftige Approximation $\Vbar_{t+1}(S_{t+1})$ finden können, würden wir unsere Politik (unsere Methode zur Entscheidungsfindung) schreiben mit
\[\begin{align} X^\pi(S_t) = \argmax_{x_t\in\Xcal_t} \big(C(S_t,x_t) + \E_{W_{t+1}} \{\Vbar_{t+1}(S_{t+1})\vert S_t,x_t\}\big). \label{eq:introvbarpolicy} \end{align}\]Die Notation „$\argmax_x f(x)$” bedeutet den Wert von $x$, der die Funktion $f(x)$ maximiert. Der Index $\pi$ trägt die Information, die die Struktur der Funktion $f$ festlegt, sowie beliebige abstimmbare Parameter $\theta$, die wir in der Approximation $\Vbar_{t+1}(S_{t+1})$ benötigen würden.
Diese Klasse von Politik fällt unter Bezeichnungen wie approximative dynamische Programmierung und, am häufigsten, bestärkendes Lernen. Obwohl dies eine leistungsfähige Idee ist, ist sie nicht einfach anzuwenden und hängt von unserer Fähigkeit ab, eine genaue Approximation $\Vbar_{t+1}(S_{t+1})$ zu erstellen.
Es gibt eine sehr umfangreiche Literatur zu Methoden zur Approximation von Wertfunktionen, aber sie ist kein Allheilmittel. Dieses Buch wird diese Idee an einigen Stellen veranschaulichen, aber die Leser seien gewarnt, dass diese Klasse von Politiken recht schwierig anzuwenden ist.
-
4) Direkte Lookahead-Approximationen (DLAs) – Es gibt viele Probleme, bei denen wir mit keiner der ersten drei Klassen effektive Politiken entwickeln können, und in solchen Fällen müssen wir auf direkte Lookahead-Approximationen zurückgreifen. Wir werden dies später in voller mathematischer Form ausschreiben, aber vorerst werden wir DLAs so beschreiben, dass sie eine Entscheidung jetzt treffen, während sie über ein (typischerweise approximatives) Modell optimieren, das sich über einen bestimmten Planungshorizont erstreckt.
Eine häufige DLA besteht darin, ein approximatives Modell zu erstellen, das deterministisch ist. Das ist es, was wir tun, wenn wir ein Navigationssystem verwenden, das den kürzesten Weg zum Ziel findet, unter der Annahme, dass wir die Reisezeit entlang jeder Verbindung des Netzwerks kennen. Als allgemeine Regel gilt, dass das Lösen eines exakten stochastischen Modells der Zukunft nahezu immer unmöglich ist, sodass wir unterschiedliche Strategien zur Approximation des Problems untersuchen werden.
Wir haben unser Modellierungsrahmenwerk anhand von zwei Bestandsproblemen veranschaulicht und zwei einfache Politiken (Formen von PFAs) mit den Gleichungen $\eqref{eq:introorderupto}$ und $\eqref{eq:adjustedforecastpolicy}$ vorgeschlagen, taten dies jedoch nur, um ein konkretes Beispiel für eine Politik zu haben. Während PFAs im alltäglichen Entscheidungsfindungsprozess weit verbreitet sind, handelt es sich hierbei um spezialisierte Beispiele.
Im Gegensatz dazu werden wir behaupten, dass die vier soeben skizzierten Klassen von Politiken (PFAs, CFAs, VFAs und DLAs) universell sind, da sie jede Methode abdecken, die wir zur Lösung jedes sequentiellen Entscheidungsproblems verwenden könnten. Um es klar zu sagen: Dies sind Meta-Klassen. Das heißt, wenn wir denken, dass sich ein Problem für eine bestimmte Klasse eignet, sind wir noch nicht fertig, da wir immer noch die spezifische Politik innerhalb der Klasse entwerfen müssen. Dennoch sind wir der Meinung, dass diese vier Klassen einen Fahrplan bieten, der den Prozess des Entwerfens von Politiken leitet.
Testen von Politiken
Um den Wert einer Politik zu testen, werden wir Gleichung $\eqref{eq:objectivecumulativerewardsample}$ verwenden, die eine Politik über einen einzelnen Stichprobenpfad des Informationsprozesses $W_t$ simuliert. Der schwierigste Teil bei der Simulation einer Politik besteht typischerweise darin, den exogenen Informationsprozess zu erstellen.
Sei $\omega$ ein Stichprobenpfad, wobei $W_1(\omega), \ldots, W_T(\omega)$ einen bestimmten Stichprobenpfad darstellt. Tabelle 1.3 veranschaulicht 10 Stichprobenpfade von Preisen, die von $\omega^1$ bis $\omega^{10}$ indexiert sind. Wenn wir $\omega^6$ wählen, dann gilt $W_7(\omega^6) = 44.16$.
| $t=1$ | $t=2$ | $t=3$ | $t=4$ | $t=5$ | $t=6$ | $t=7$ | $t=8$ | |
|---|---|---|---|---|---|---|---|---|
| $\omega^n$ | $p_1$ | $p_2$ | $p_3$ | $p_4$ | $p_5$ | $p_6$ | $p_7$ | $p_8$ |
| $\omega^1$ | 45.00 | 45.53 | 47.07 | 47.56 | 47.80 | 48.43 | 46.93 | 46.57 |
| $\omega^2$ | 45.00 | 43.15 | 42.51 | 40.51 | 41.50 | 41.00 | 39.16 | 41.11 |
| $\omega^3$ | 45.00 | 45.16 | 45.37 | 44.30 | 45.35 | 47.23 | 47.35 | 46.30 |
| $\omega^4$ | 45.00 | 45.67 | 46.18 | 46.22 | 45.69 | 44.24 | 43.77 | 43.57 |
| $\omega^5$ | 45.00 | 46.32 | 46.14 | 46.53 | 44.84 | 45.17 | 44.92 | 46.09 |
| $\omega^6$ | 45.00 | 44.70 | 43.05 | 43.77 | 42.61 | 44.32 | 44.16 | 45.29 |
| $\omega^7$ | 45.00 | 43.67 | 43.14 | 44.78 | 43.12 | 42.36 | 41.60 | 40.83 |
| $\omega^8$ | 45.00 | 44.98 | 44.53 | 45.42 | 46.43 | 47.67 | 47.68 | 49.03 |
| $\omega^9$ | 45.00 | 44.57 | 45.99 | 47.38 | 45.51 | 46.27 | 46.02 | 45.09 |
| $\omega^{10}$ | 45.00 | 45.01 | 46.73 | 46.08 | 47.40 | 49.14 | 49.03 | 48.74 |
Tabelle 1.3. Veranschaulichung einer Reihe von Stichprobenpfaden für Preise, die alle bei $45.00 beginnen.
Die Frage ist: Wie erstellen wir eine Stichprobe von Beobachtungen wie den in Tabelle 1.3 dargestellten? Es gibt drei typische Strategien:
- Stichproben aus historischen Daten erstellen. Da es zu jedem Zeitpunkt nur ein Ergebnis gibt, können wir mehrere Stichprobenpfade erstellen, indem wir Beobachtungen aus verschiedenen Zeiträumen kombinieren. Wir könnten Preise aus verschiedenen Jahren, Nachfragen aus verschiedenen Monaten oder beobachtete Reisezeiten an verschiedenen Tagen auswählen. Dieser Ansatz ist nicht möglich, wenn die exogene Information vom Zustand $S_t$ oder von Entscheidungen $x_t$ abhängt.
- Simulation aus einem mathematischen Modell. Dieser Ansatz bietet den Vorteil, große Stichproben erzeugen zu können, um statistisch zuverlässige Schätzungen der Leistung einer Politik zu erhalten. Diese Modelle können sehr ausgefeilt sein, aber es ist recht einfach, Modelle zu erstellen (selbst ausgefeilte), die das Verhalten realer Daten nicht replizieren. Die größte Herausforderung besteht darin, Korrelationen zu erfassen, sei es über die Zeit oder zwischen Stichproben (etwa die Nachfragen verschiedener Produkte, die Preise verschiedener Aktien oder die Windgeschwindigkeit an verschiedenen Orten).
- Wir können eine Idee im Feld testen, indem wir Beobachtungen so verwenden, wie sie tatsächlich auftreten. Der Vorteil dabei ist, dass wir mit echten Daten arbeiten (die Vergangenheit muss nicht dieselbe sein wie die Zukunft). Der Nachteil ist, dass es einen Tag dauert, einen Tag neuer Daten zu beobachten (und wir möglicherweise weit mehr als einen einzigen Tag an Beobachtungen benötigen).
Wenn $W_{t+1}$ vom Zustand $S_t$ und/oder der Entscheidung $x_t$ abhängt, müssen wir einen Weg finden, diese Abhängigkeit widerzuspiegeln. Die Erstellung eines mathematischen Modells ermöglicht es, viele Simulationen im Computer durchzuführen, aber die Erstellung von Stichproben des Informationsprozesses erfordert auch die Rekonstruktion von Korrelationen über die Zeit sowie über den Raum hinweg. Wir verweisen den Leser auf RLSO, Kapitel 10, für eine ausführlichere Diskussion der Unsicherheitsmodellierung.
Nächste Schritte
Die nächsten fünf Kapitel des Buches werden unser Modellierungsrahmenwerk auf fünf verschiedene Probleme anwenden:
- Kapitel 2 – Ein Problem des Verkaufs von Vermögenswerten
- Kapitel 3 – Adaptive Marktplanung
- Kapitel 4 – Erlernen der besten Diabetes-Medikation
- Kapitel 5 – Stochastische Kürzeste-Wege-Probleme - Statisch
- Kapitel 6 – Stochastische Kürzeste-Wege-Probleme - Dynamisch
Jedes dieser Kapitel wird derselben Gliederung folgen, die wir oben zur Beschreibung der beiden Bestandsprobleme verwendet haben. Diese Gliederung besteht aus:
- Erzählung – Eine allgemeinverständliche Beschreibung des Problems.
- Das universelle Modell – Dieses Modell wird unserem Format folgen, die fünf Elemente eines sequentiellen Entscheidungsproblems zu beschreiben: Zustandsvariablen, Entscheidungsvariablen, exogene Informationsvariablen, die Übergangsfunktion und die Zielfunktion.
- Unsicherheitsmodell – Hier werden wir ein mögliches Modell für etwaige Unsicherheiten im Problem bereitstellen.
- Entwurf von Politiken – Wir werden mögliche Politiken zur Entscheidungsfindung vorschlagen. Wir haben unsere Probleme so ausgewählt, dass die fünf Anwendungsszenarien uns eine Tour durch alle vier Klassen von Politiken bieten. Vorerst überlassen wir es dem Leser, zu erkennen, welche der vier Klassen wir jeweils wählen.
- Erweiterung – Schließlich schlagen wir möglicherweise eine oder mehrere mögliche Erweiterungen unseres Grundproblems vor, die eine Änderung der Politik erfordern könnten.
Anschließend kehren wir in Kapitel 7 zu den vier Klassen von Politiken zurück und diskutieren unser allgemeines Modellierungsrahmenwerk, wobei wir die Probleme aus den Kapiteln 2–6 verwenden, um verschiedene Modellierungsideen zu veranschaulichen.
Nach dieser Diskussion kehren wir zu unserem Muster von Lernen-am-Beispiel-Kapiteln zurück, verwenden dabei jedoch komplexere Probleme. Unsere verbleibenden Kapitel behandeln die folgenden Probleme:
- Kapitel 8 – Energiespeicherung I
- Kapitel 9 – Energiespeicherung II
- Kapitel 10 – Lieferkettenmanagement I: Der Zwei-Agenten-Zeitschriftenhändler
- Kapitel 11 – Lieferkettenmanagement II: Das Bierspiel
- Kapitel 12 – Ad-Click-Optimierung
- Kapitel 13 – Blutmanagementproblem
- Kapitel 14 – Optimierung klinischer Studien
Was haben wir gelernt?
- Zunächst haben wir gelernt, was eine Entscheidung ist!
- Wir haben ein allgemeines Modell vorgestellt, das sogenannte universelle Modellierungsrahmenwerk, für jedes sequentielle Entscheidungsproblem.
- Wir haben das Modell zunächst anhand eines klassischen Bestandsproblems veranschaulicht, bei dem der Zustand des Systems die Menge im Bestand ist.
- Anschließend sind wir zu einem etwas komplizierteren Bestandsproblem übergegangen, bei dem die Zustandsvariable den Ressourcenzustand $R_t$ des Bestands, eine Informations-Zustandsvariable in Form des Preises $p_t$ und schließlich einen Belief-Zustand über die bevorstehende Nachfrage $\Dhat_{t+1}$ in Form eines geschätzten Mittelwerts und einer Varianz umfasst.
- Wir haben gelernt, wie man den Fluss exogener Information modelliert, die aus einer Reihe verschiedener Quellen eintreffen kann. Exogene Information wird als Funktion dargestellt, die vom Zustand und/oder der Entscheidung abhängen kann.
- Wir haben zwei Formen einer einfachen Klasse von Politik veranschaulicht, die als Politikfunktionsapproximation (oder PFA) bekannt ist.
- Wir haben gelernt, dass Politiken auf verschiedene Weisen bewertet werden können, die vom Kontext und davon abhängen, wie Entscheidungen verwendet werden.
- Wir haben mit einem kurzen Überblick über vier Klassen von Politiken geschlossen. Veranschaulichungen aller vier Klassen werden in den Kapiteln 2–6 gegeben, an welcher Stelle wir in Kapitel 7 innehalten, um die Politiken eingehender zu diskutieren und damit die Grundlage für die komplexeren Probleme in den Kapiteln 8–14 zu legen.
Übungen
Wiederholungsfragen
- Was sind die fünf Elemente des mathematischen Modells eines sequentiellen Entscheidungsproblems?
- Was ist der Unterschied zwischen den Variablen im Anfangszustand $S_0$ und denen im dynamischen Zustand $S_t$ für $t > 0$?
- Was ist der Unterschied zwischen einer Entscheidung und der exogenen Information?
- Was sind die beiden Hauptkategorien von Politiken, und wie unterscheiden sie sich?
- Vergleichen Sie die Zustandsvariablen des einfachen Bestandsproblems mit denen des komplizierteren Bestandsproblems.
Problemlösungsfragen
- Vergleichen Sie die Politiken für die beiden Bestandsprobleme im Hinblick darauf, wie sie mit zeitabhängigem Verhalten umgehen würden. Zum Beispiel könnte unsere Pizzeria am Wochenende eine viel höhere Nachfrage haben als an Wochentagen. Kommentieren Sie den Wert, den es hätte, den einstellbaren Parameter $\theta$ zeitabhängig (oder wochentagsabhängig) zu machen, im Hinblick darauf, wie er die Lösung verbessern könnte.
- Vergleichen Sie, wie Sie den Parameter $\theta$ für die Bestandsprobleme abstimmen würden:
- In einem Simulator.
- Im Feld.